1 Metodo di eliminazione di Gauss

1.1 Introduzione
Il metodo di eliminazione di Gauss1 è una procedura sistematica per risolvere sistemi di equazioni lineari. Consiste nel trasformare il sistema iniziale in un sistema equivalente di struttura più semplice, detto in forma triangolare, nel quale ogni equazione contiene un numero non crescente di incognite.
L’obiettivo del metodo è annullare, passo dopo passo, i coefficienti al di sotto della diagonale principale della matrice associata al sistema, mediante operazioni elementari sulle righe (scambi, moltiplicazioni per uno scalare e somme di righe). Una volta ottenuta la forma triangolare, il sistema si risolve mediante sostituzioni all’indietro: si parte dall’ultima equazione e si procede a ritroso fino alla prima.
Il metodo di Gauss è alla base di numerose tecniche numeriche per la risoluzione dei sistemi lineari.
Applicato a un sistema lineare della forma:
\left\{\begin{aligned} A_{1,1}x_1 + A_{1,2}x_2 + \cdots + A_{1,n}x_n &= b_1 \\ A_{2,1}x_1 + A_{2,2}x_2 + \cdots + A_{2,n}x_n &= b_2 \\ &\vdots\\ A_{n,1}x_1 + A_{n,2}x_2 + \cdots + A_{n,n}x_n &= b_n \end{aligned}\right.
il metodo lo trasforma in un sistema equivalente, cioè con lo stesso insieme di soluzioni, della forma:
\left\{\begin{aligned} C_{1,1}x_1 + C_{1,2}x_2 + \cdots + C_{1,n}x_n &= d_1 \\ C_{2,2}x_2 + \cdots + C_{2,n}x_n &= d_2 \\ &\vdots\\ C_{n,n}x_n &= d_n \end{aligned}\right. \tag{1.1}
detta forma triangolare.
Un sistema in forma triangolare si risolve mediante sostituzioni all’indietro: si parte dall’ultima incognita, il cui valore è determinato dall’ultima equazione, e si procede risalendo il sistema. In formula:
\begin{aligned} x_n &= \dfrac{d_n}{C_{n,n}} \\ x_{n-1} &= \dfrac{d_{n-1} - C_{n-1,n}x_n}{C_{n-1,n-1}} \\ x_{n-2} &= \dfrac{d_{n-2} - C_{n-2,n}x_n - C_{n-2,n-1}x_{n-1}}{C_{n-2,n-2}} \\ &\vdots \\ x_1 &= \dfrac{d_1 - C_{1,n}x_n - C_{1,n-1}x_{n-1} - \cdots - C_{1,2}x_2}{C_{1,1}} \\ \end{aligned} \tag{1.2}
Esempio 1.1 (Esempio) La soluzione del sistema in forma triangolare:
\left\{\begin{aligned} x+y+z &= 1 \\ 4y+2z &= 0 \\ z &= 2 \end{aligned}\right.
(nel quale abbiamo posto x=x_1, y=x_2 e z=x_3), si ottiene immediatamente sostituendo all’indietro le variabili come mostrato in 1.2,
\begin{aligned} z &= \dfrac{2}{1} = 2, \\ y &= \dfrac{0-2z}{4} = \dfrac{0-2\cdot 2}{4}=-1,\\ x &= \dfrac{1-1z-1y}{1} = \dfrac{1-1(-1)-1\cdot 2}{1} = 0. \end{aligned}
L’algoritmo di eliminazione di Gauss elimina, a ogni passo, una variabile esprimendola come combinazione lineare di quelle non ancora eliminate. A questo scopo si sceglie un’equazione, che viene poi usata per sostituire la variabile nelle altre equazioni. In termini matriciali, il procedimento consiste nel costruire opportune combinazioni lineari delle equazioni, e quindi delle righe della matrice dei coefficienti.
Per fissare le idee, illustriamo il procedimento con un esempio dettagliato.
Esempio 1.2 (Esempio) Sia dato il seguente sistema lineare
\left\{\begin{aligned} x+y+z+w &= 1 \qquad\qquad & [1] \\ -x-y+4z &= 0 & [2]\\ x-z-w &= 2 & [3]\\ x+w &= 0 & [4] \end{aligned}\right.
Le equazioni sono numerate a destra tra parentesi quadre per facilitarne il riferimento. Trasformiamo il sistema in forma triangolare eliminando, un passo alla volta, le incognite x, y, z2 mediante combinazioni lineari delle equazioni.
Per eliminare l’incognita x dalle equazioni [2], [3] e [4], eseguiremo le seguenti operazioni:
Eliminare x da [2]: Sommiamo l’equazione [1] all’equazione [2] per ottenere la nuova equazione [2']: [2'] \gets [2] + [1]
Eliminare x da [3]: Sottraiamo l’equazione [1] dall’equazione [3] per ottenere la nuova equazione [3']: [3'] \gets [3] - [1]
Eliminare x da [4]: Sottraiamo l’equazione [1] dall’equazione [4] per ottenere la nuova equazione [4']: [4'] \gets [4] - [1]
Si ottiene:
\left\{\begin{aligned} x+y+z+w &= 1 \qquad\qquad & [1] \\ 5z+w &= 1 & [2'] \\ -y-2z-2w &= 1 & [3'] \\ -y-z &= -1 & [4'] \end{aligned}\right.
Osserviamo che l’equazione [2'] non contiene la variabile y, mentre l’equazione [3'] la contiene. Per semplificare il sistema, scambiamo l’equazione [2'] con la [3'] prima di procedere all’eliminazione successiva:
\left\{\begin{aligned} x+y+z+w &= 1 \qquad\qquad & [1] \\ -y-2z-2w &= 1 & [3']\\ 5z+w &= 1 & [2']\\ -y-z &= -1 & [4'] \end{aligned}\right.
Per eliminare l’incognita y dall’equazione [4'], eseguiremo la seguente operazione:
- Eliminare y da [4']: Sommiamo l’equazione [3'] all’equazione [4'] per ottenere la nuova equazione [4'']: [4''] \gets [4'] - [3']
Si ottiene:
\left\{\begin{aligned} x+y+z+w &= 1 \qquad\qquad & [1] \\ -y-2z-2w &= 1 & [3']\\ 5z+w &= 1 & [2']\\ z+2w &= -2 & [4''] \end{aligned}\right.
Per eliminare l’incognita z dall’equazione [4''], eseguiremo la seguente operazione:
- Eliminare z da [4'']: Sottraiamo \dfrac{1}{5} volte l’equazione [2'] dall’equazione [4''] per ottenere la nuova equazione [4''']: [4'''] \gets [4''] - \dfrac{1}{5}[2']
Si ottiene:
\left\{\begin{aligned} x+y+z+w &=1 \qquad\qquad & [1] \\ -y-2z-2w &=1 & [3']\\ 5z+w &=1 & [2']\\ \dfrac{9}{5}w &=-\dfrac{11}{5} & [4'''] \end{aligned}\right.
Il sistema è ora in forma triangolare e, tramite il procedimento di sostituzioni all’indietro 1.2, possiamo calcolare la soluzione:
\begin{aligned} w &= \dfrac{-\dfrac{11}{5}}{\dfrac{9}{5}} = -\dfrac{11}{9} \\ z &= \dfrac{1 - \left(-\dfrac{11}{9}\right)}{5} = \dfrac{4}{9} \\ y &= \dfrac{1 + 2\left(-\dfrac{11}{9}\right) + 2 \dfrac{4}{9}}{-1} = \dfrac{5}{9} \\ x &= \dfrac{1 - \left(-\dfrac{11}{9}\right) - \dfrac{4}{9} - \dfrac{5}{9}}{1} = \dfrac{11}{9} \end{aligned}
L’algoritmo di Gauss si può quindi descrivere come segue:
Consideriamo un sistema lineare:
\bm{A}\bm{x} = \bm{b}
dove
\bm{A} = \begin{pmatrix} A_{1,1} & A_{1,2} & \cdots & A_{1,n} \\ A_{2,1} & A_{2,2} & \ddots & \vdots \\ \vdots & \ddots & \ddots & A_{n-1,n} \\ A_{n,1} & \cdots & A_{n,n-1} & A_{n,n} \end{pmatrix}, \quad \bm{x} = \begin{pmatrix} x_1 \\ x_2 \\ \vdots \\ x_n \end{pmatrix}, \qquad \bm{b} = \begin{pmatrix} b_1 \\ b_2 \\ \vdots \\ b_n \end{pmatrix}.
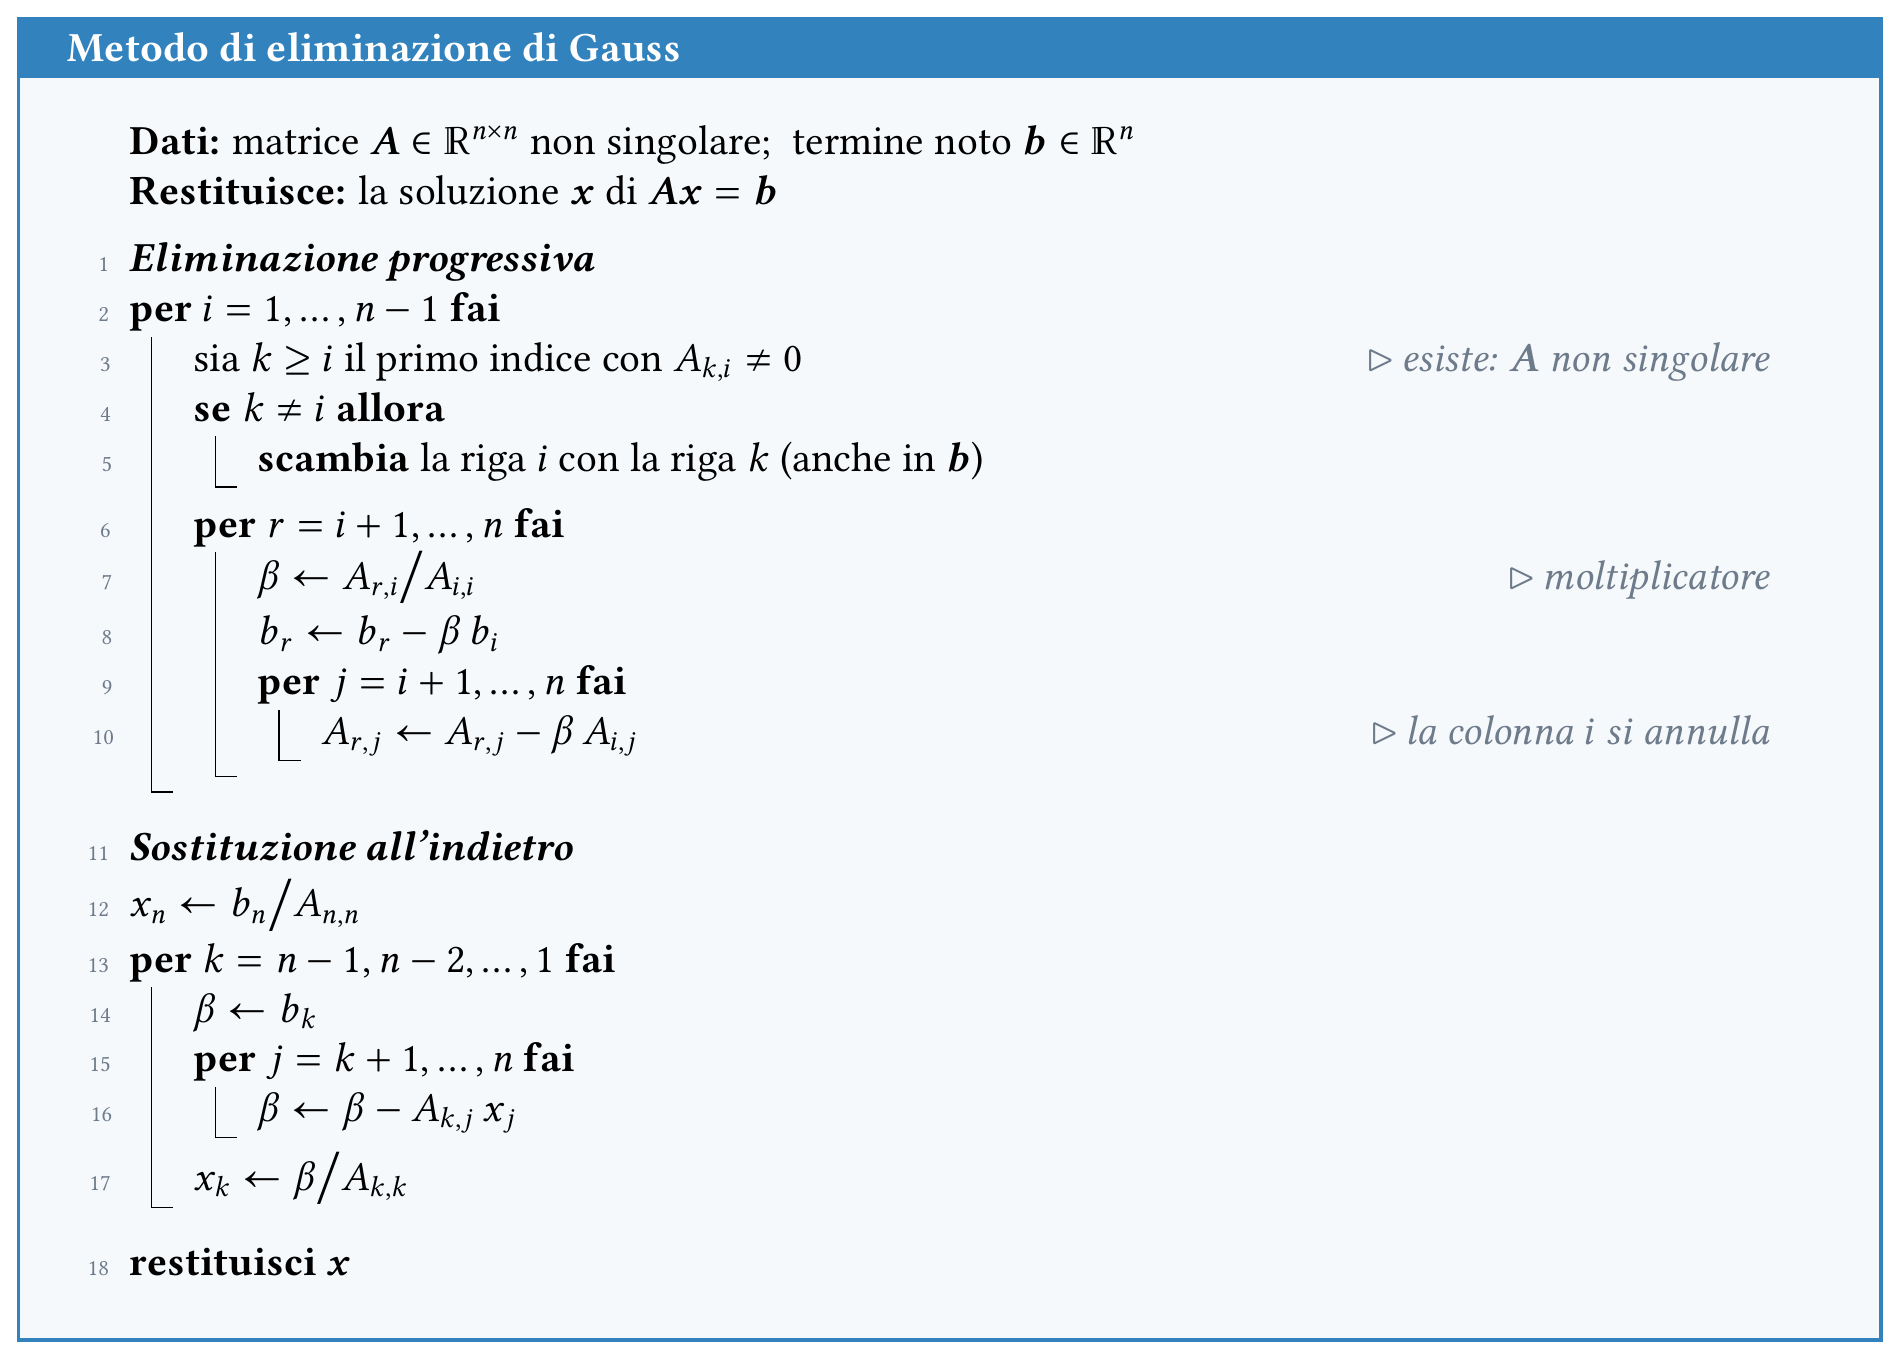
Alla fine dell’eliminazione progressiva la matrice \bm{A} e il termine noto \bm{b} hanno la forma
\bm{A} = \begin{pmatrix} A_{1,1} & A_{1,2} & \cdots & A_{1,n} \\ 0 & A_{2,2} & \cdots & A_{2,n} \\ 0 & 0 & \ddots & \vdots \\ \vdots & \vdots & & A_{n-1,n} \\ 0 & 0 & \cdots & A_{n,n} \end{pmatrix}, \qquad \bm{b} = \begin{pmatrix} b_1 \\ b_2 \\ \vdots \\ b_{n-1} \\ b_n \end{pmatrix},
e la sostituzione all’indietro può procedere dall’ultima equazione verso la prima.
1.2 Forma Matriciale del Metodo di Gauss
Il metodo di Gauss per la risoluzione di sistemi lineari può essere interpretato usando il formalismo delle matrici. Consideriamo un sistema lineare nella forma matriciale:
\bm{A} \bm{x} = \bm{b}
dove \bm{A} è una matrice quadrata n \times n, \bm{x} è un vettore colonna di incognite, e \bm{b} è un vettore colonna di termini noti.
Trasformazione in Forma Triangolare Superiore
L’obiettivo del metodo di Gauss è trasformare il sistema \bm{A} \bm{x} = \bm{b} in un sistema equivalente della forma:
\bm{U} \bm{x} = \bm{c}
dove \bm{U} è una matrice triangolare superiore e \bm{c} è un vettore modificato di termini noti. La matrice \bm{U} è ottenuta applicando una serie di operazioni elementari al sistema originale.
Passaggi per la Trasformazione
La trasformazione dal sistema originale \bm{A} \bm{x} = \bm{b} al sistema triangolare superiore \bm{U} \bm{x} = \bm{c} avviene attraverso i seguenti passaggi:
Operazioni Elementari: Utilizziamo matrici elementari, chiamate matrici di Frobenius, per applicare operazioni elementari alle righe della matrice \bm{A}. Queste operazioni nel caso del metodo di Gauss si riducono a:
- Addizione di un multiplo di una riga a un’altra riga.
Matrici di Scambio: Se necessario, scambiamo due righe della matrice \bm{A} utilizzando matrici di permutazione, che sono matrici identità con due righe scambiate. Queste matrici assicurano che l’algoritmo non fallisca a causa di zeri nei pivots (elementi diagonali).
Matrici di Frobenius
Le matrici di Frobenius3 sono matrici elementari utilizzate per eseguire operazioni sui sistemi lineari. Ogni matrice di Frobenius rappresenta una trasformazione elementare specifica:
Addizione di Multipli di Righe ad Altre Righe: Una matrice di Frobenius per aggiungere multipli \beta_{k+1}, \beta_{k+2}, \ldots, \beta_{n} della riga k-esima alle righe k+1, k+2 fino a n è una matrice identità con gli \beta_j posizionati nella k-esima colonna. Per scriverla esplicitamente consideriamo il vettore \bm{v}=\begin{pmatrix}0,\ldots,0,\beta_{k+1},\ldots,\beta_n\end{pmatrix}^{T} cioè tale che v_i = 0, \qquad i=1,2,\ldots,k in questo modo la matrice di Frobenius \bm{F} diventa \bm{F} = \bm{I}+ \bm{v}\bm{e}_k^T, o più esplicitamente: \bm{F} = \left( \begin{array}{ccc|c|ccc} 1 & & & 0 & 0 & \cdots & 0 \\ & \ddots & & \vdots & \vdots & & \vdots \\ & & 1 & 0 & 0 & \cdots & 0 \\ \hline 0 & \cdots & 0 & 1 & 0 & \cdots & 0 \\ \hline 0 & \cdots & 0 & \beta_{k+1} & 1 & & \\ \vdots & & \vdots & \vdots & & \ddots & \\ 0 & \cdots & 0 & \beta_n & & & 1 \end{array} \right)
Scambio di Due Righe: Una matrice di permutazione per scambiare la i-esima e la j-esima riga (denotata con \bm{S}_{i,j}) è una matrice identità con le righe i e j scambiate. Esplicitamente prende la forma: \bm{S}_{i,j} = \left(\begin{array}{ccc|c|ccc|c|ccc} 1 & & & & & & & & & & \\ & \ddots & & & & & & & & & \\ & & 1 & & & & & & & & \\ \hline & & & 0 & & & & 1 & & & \\ \hline & & & & 1 & & & & & & \\ & & & & & \ddots & & & & & \\ & & & & & & 1 & & & & \\ & & & 1 & & & & 0 & & & \\ \hline & & & & & & & & 1 & & \\ \hline & & & & & & & & & \ddots & \\ & & & & & & & & & & 1 \end{array}\right) \tag{1.3}
La stessa matrice ammette la seguente rappresentazione più compatta: \bm{S}_{i,j} = \bm{I} - (\bm{e}_i-\bm{e}_j)(\bm{e}_i-\bm{e}_j)^{T}
1.3 Proprietà delle matrici di Frobenius
Consideriamo la matrice di Frobenius \bm{F} definita in 1.3 e la matrice \bm{A},
\bm{A} = \begin{pmatrix} A_{1,1} & A_{1,2} & \cdots & A_{1,n} \\ \vdots & \vdots & & \vdots \\ A_{k,1} & A_{k,2} & \cdots & A_{k,n} \\ A_{k+1,1} & A_{k+1,2} & \cdots & A_{k+1,n} \\ \vdots & \vdots & & \vdots \\ A_{n,1} & A_{n,2} & \cdots & A_{n,n} \end{pmatrix},
il prodotto \bm{F}\bm{A} è
\bm{F}\bm{A} = \begin{pmatrix} A_{1,1} & A_{1,2} & \cdots & A_{1,n} \\ \vdots & \vdots & & \vdots \\ A_{k,1} & A_{k,2} & \cdots & A_{k,n} \\ A_{k+1,1}+\beta_{k+1}A_{k,1} & A_{k+1,2}+\beta_{k+1}A_{k,2} & \cdots & A_{k+1,n}+\beta_{k+1}A_{k,n} \\ \vdots & \vdots & & \vdots \\ A_{n,1}+\beta_n A_{k,1} & A_{n,2}+\beta_n A_{k,2} & \cdots & A_{n,n}+\beta_n A_{k,n} \end{pmatrix}.
L’effetto della moltiplicazione di \bm{F} sulla matrice \bm{A} può essere descritto come segue:
- La riga i-esima della matrice \bm{A} viene sostituita dalla somma della riga i-esima originale con un multiplo della riga k-esima, dove il multiplo è dato dallo scalare v_i.
In altre parole, stiamo effettuando le seguenti modifiche alle righe della matrice \bm{A}:
Sostituiamo la riga (k+1)-esima con la riga
A_{k+1,\bullet} \gets A_{k+1,\bullet} + \beta_{k+1} \cdot A_{k,\bullet}
Sostituiamo la riga (k+2)-esima con la riga
A_{k+2,\bullet} \gets A_{k+2,\bullet} + \beta_{k+2} \cdot A_{k,\bullet}
E così via fino a:
A_{n,\bullet} \gets A_{n,\bullet} + \beta_{n} \cdot A_{k,\bullet}
Lemma 1.1 (Prodotto di Matrici di Frobenius) Siano \bm{F}_i = \bm{I} + \bm{v}_i \bm{e}_i^T le matrici di Frobenius, dove \bm{v}_i è un vettore con zeri nelle prime i componenti, ossia della forma:
\bm{v}_i = \begin{pmatrix} 0 \\ \vdots \\ 0 \\ \beta_{i+1} \\ \beta_{i+2} \\ \vdots \\ \beta_n \end{pmatrix}
Allora, per ogni 2 \leq k \leq n-1, si ha che:
\bm{F}_1 \bm{F}_2 \cdots \bm{F}_k = \bm{I} + \bm{v}_1 \bm{e}_1^T + \bm{v}_2 \bm{e}_2^T + \cdots + \bm{v}_k \bm{e}_k^T
Dimostrazione. La dimostrazione procede per induzione sull’indice k.
Base dell’Induzione (k=2):
Calcoliamo il prodotto delle due matrici:
\begin{aligned} \bm{F}_1 \bm{F}_2 &= (\bm{I} + \bm{v}_1 \bm{e}_1^T)(\bm{I} + \bm{v}_2 \bm{e}_2^T) \\ &= \bm{I} + \bm{v}_1 \bm{e}_1^T + \bm{v}_2 \bm{e}_2^T + \bm{v}_1 (\bm{e}_1^T \bm{v}_2) \bm{e}_2^T \\ &= \bm{I} + \bm{v}_1 \bm{e}_1^T + \bm{v}_2 \bm{e}_2^T, \end{aligned}
poiché \bm{e}_1^T \bm{v}_2 = (\bm{v}_2)_1 = 0.
Passo Induttivo:
Supponiamo che il lemma sia vero per un indice generico k-1, cioè:
\bm{F}_1 \bm{F}_2 \cdots \bm{F}_{k-1} = \bm{I} + \bm{v}_1 \bm{e}_1^T + \bm{v}_2 \bm{e}_2^T + \cdots + \bm{v}_{k-1} \bm{e}_{k-1}^T.
Ora, calcoliamo:
\begin{aligned} \left(\bm{F}_1 \bm{F}_2 \cdots \bm{F}_{k-1}\right) \bm{F}_k &= \left(\bm{I} + \bm{v}_1 \bm{e}_1^T + \bm{v}_2 \bm{e}_2^T + \cdots + \bm{v}_{k-1} \bm{e}_{k-1}^T\right) \left(\bm{I} + \bm{v}_k \bm{e}_k^T\right) \\ &= \bm{I} + \bm{v}_1 \bm{e}_1^T + \bm{v}_2 \bm{e}_2^T + \cdots + \bm{v}_{k-1} \bm{e}_{k-1}^T + \bm{v}_k \bm{e}_k^T \\ &\quad + \bm{v}_1 (\bm{e}_1^T \bm{v}_k) \bm{e}_k^T + \cdots + \bm{v}_{k-1} (\bm{e}_{k-1}^T \bm{v}_k) \bm{e}_k^T \\ &= \bm{I} + \bm{v}_1 \bm{e}_1^T + \bm{v}_2 \bm{e}_2^T + \cdots + \bm{v}_{k-1} \bm{e}_{k-1}^T + \bm{v}_k \bm{e}_k^T, \end{aligned}
poiché tutti i termini misti sono nulli, essendo
\bm{e}_i^T \bm{v}_k = (\bm{v}_k)_i = 0, \qquad i = 1, 2, \ldots, k-1.
Lemma 1.2 (Inversa della Matrice di Frobenius) Consideriamo la matrice di Frobenius \bm{F} definita come:
\bm{F} = \bm{I} + \bm{v} \bm{e}_k^T
dove \bm{I} è la matrice identità, \bm{v} è un vettore colonna e \bm{e}_k^T è il vettore riga unitario con 1 nella k-esima posizione e zeri altrove.
Quando v_k = 0, l’inversa di \bm{F} è data dalla matrice:
\bm{F}^{-1} = \bm{I} - \bm{v} \bm{e}_k^T.
Dimostrazione. Per verificare che \bm{F}^{-1} = \bm{I} - \bm{v} \bm{e}_k^T sia effettivamente l’inversa di \bm{F}, dobbiamo mostrare che:
\bm{F} \cdot \bm{F}^{-1} = \bm{I}
Calcoliamo il prodotto:
\begin{aligned} \left(\bm{I} + \bm{v} \bm{e}_k^T\right) \left(\bm{I} - \bm{v} \bm{e}_k^T\right) &= \bm{I} \cdot \bm{I} - \bm{I} \cdot \bm{v} \bm{e}_k^T + \bm{v} \bm{e}_k^T \cdot \bm{I} - \bm{v} \bm{e}_k^T \cdot \bm{v} \bm{e}_k^T \\ &= \bm{I} - \bm{v} \bm{e}_k^T + \bm{v} \bm{e}_k^T - \bm{v} (\bm{e}_k^T \bm{v}) \bm{e}_k^T \\ &= \bm{I} - \bm{v} (\bm{e}_k^T \bm{v}) \bm{e}_k^T \end{aligned}
Notiamo che i termini \bm{v} \bm{e}_k^T si cancellano:
-\bm{v} \bm{e}_k^T + \bm{v} \bm{e}_k^T = 0
Pertanto, rimane:
\left(\bm{I} + \bm{v} \bm{e}_k^T\right) \left(\bm{I} - \bm{v} \bm{e}_k^T\right) = \bm{I} - \bm{v} (\bm{e}_k^T \bm{v}) \bm{e}_k^T
Per dimostrare che \bm{F}^{-1} = \bm{I} - \bm{v} \bm{e}_k^T è effettivamente l’inversa di \bm{F}, dobbiamo verificare che il termine \bm{v} (\bm{e}_k^T \bm{v}) \bm{e}_k^T sia nullo. Poiché \bm{e}_k^T \bm{v} è il k-esimo elemento del vettore \bm{v}, denotato come v_k, abbiamo:
\bm{e}_k^T \bm{v} = v_k
Se v_k = 0 (cioè l’k-esimo elemento di \bm{v} è zero), allora:
\left(\bm{I} + \bm{v} \bm{e}_k^T\right) \left(\bm{I} - \bm{v} \bm{e}_k^T\right) = \bm{I}
Poiché v_k = 0 allora \bm{F}^{-1} = \bm{I} - \bm{v} \bm{e}_k^T è l’inversa della matrice di Frobenius.
1.4 Primo passo del metodo di Gauss
Dato il sistema \bm{A}\bm{x}=\bm{b} poniamo \bm{A}^{(1)}=\bm{A} e \bm{b}^{(1)}=\bm{b},
\bm{A}^{(1)}=\begin{pmatrix} A^{(1)}_{1,1} & A^{(1)}_{1,2} & \cdots & A^{(1)}_{1,n} \\ A^{(1)}_{2,1} & A^{(1)}_{2,2} & \ddots & \vdots \\ \vdots & \ddots & \ddots & A^{(1)}_{n-1,n} \\ A^{(1)}_{n,1} & \cdots & A^{(1)}_{n,n-1} & A^{(1)}_{n,n} \end{pmatrix}.
Supponendo A^{(1)}_{1,1}\neq 0 definiamo
\begin{aligned} v^{(1)}_i &= \begin{cases} 0 & i=1 \\ \dfrac{A^{(1)}_{i,1}} {A^{(1)}_{1,1}} & i=2,3,\ldots,n \end{cases}, \\ %\bm{v}^{(1)} &= \MAT{ % 0 \\ v^{(1)}_2 \\ v^{(1)}_3 \\ \vdots \\ v^{(1)}_n %}, %\\ \bm{L}_1 &= \bm{I}-\bm{v}^{(1)}\bm{e}_1^T = \begin{pmatrix} 1 & 0 & \cdots & & 0 \\ -v^{(1)}_2 & 1 & & & \vdots \\ \vdots & & \ddots & & 0 \\ -v^{(1)}_{n-1} & & & 1 & 0 \\ -v^{(1)}_n & 0 & \cdots & 0 & 1 \end{pmatrix}. \end{aligned}
Moltiplicando il sistema \bm{A}^{(1)}\bm{x}=\bm{b}^{(1)} a sinistra per la matrice di Frobenius \bm{L}_1 otteniamo il sistema trasformato \bm{A}^{(2)}\bm{x} = \bm{b}^{(2)} dove,
\bm{A}^{(2)} = \bm{L}_1\bm{A}^{(1)} = \left(\begin{array}{c|cccc} A^{(1)}_{1,1} & A^{(1)}_{1,2} & A^{(1)}_{1,3} & \cdots & A^{(1)}_{1,n} \\ \hline 0 & A^{(2)}_{2,2} & A^{(2)}_{2,3} & \cdots & A^{(2)}_{2,n} \\ 0 & A^{(2)}_{3,2} & A^{(2)}_{3,3} & \cdots & A^{(2)}_{3,n} \\ \vdots & \vdots & & & \vdots \\ 0 & A^{(2)}_{n,2} & A^{(2)}_{n,3} & \cdots & A^{(2)}_{n,n} \end{array}\right), \quad \bm{b}^{(2)} = \bm{L}_1\bm{b}^{(1)} = \left(\begin{array}{c} b^{(1)}_1 \\ b^{(2)}_2 \\ b^{(2)}_3 \\ \vdots \\ b^{(2)}_n \end{array}\right).
ed inoltre si ha
\begin{aligned} A^{(2)}_{i,j} &= A^{(1)}_{i,j}-v^{(1)}_i A^{(1)}_{1,j}, \qquad & i,j &= 2,3,\ldots,n \\ b^{(2)}_i &= b^{(1)}_i-v^{(1)}_i b^{(1)}_1 & i &= 2,3,\ldots,n. \end{aligned}
1.5 k-esimo passo del metodo di Gauss
Supponiamo di aver effettuato k-1 passi dell’algoritmo di Gauss (senza permutazione di righe). Siamo quindi nella situazione
\bm{A}^{(k)}=\bm{L}_{k-1}\cdots\bm{L}_2\bm{L}_1\bm{A}^{(1)}
e
\bm{b}^{(k)}=\bm{L}_{k-1}\cdots\bm{L}_2\bm{L}_1\bm{b}^{(1)}
dove
\bm{A}^{(k)}= \left(\begin{array}{ccc|ccc} A^{(1)}_{1,1} & \cdots & A^{(1)}_{1,k-1} & ^{(1)}_{1,k} & \cdots & A^{(1)}_{1,n} \\ & \ddots & \vdots & \vdots & & \vdots \\ 0 & & A^{(k-1)}_{k-1,k-1} & A^{(k-1)}_{k-1,k} & \cdots & A^{(k-1)}_{k-1,n} \\ \hline 0 & \cdots & 0 & A^{(k)}_{k,k} & \cdots & A^{(k)}_{k,n} \\ \vdots & & \vdots & \vdots & & \vdots \\ 0 & \cdots & 0 & A^{(k)}_{n,k} & \cdots & A^{(k)}_{n,n} \end{array}\right), \quad \bm{b}^{(k)} = \left(\begin{array}{c} b^{(1)}_1 \\ \vdots \\ b^{(k-1)}_{k-1} \\ b^{(k)}_k \\ \vdots \\ b^{(k)}_n \end{array}\right).
Supponendo A^{(k)}_{k,k}\neq 0 e ponendo
\begin{aligned} v^{(k)}_i &= \begin{cases} 0 & i=1,2,\ldots,k \\ \dfrac{A^{(k)}_{i,k}} {A^{(k)}_{k,k}} & i=k+1,k+2,\ldots,n \end{cases}, \\ % \bm{v}^{(k)} = % \MAT{ 0 \\ \vdots \\ 0 \\ v^{(k)}_{k+1} \\ \vdots %\\ v^{(k)}_n }, \\ \bm{L}_k &= \bm{I}-\bm{v}_k\bm{e}_k^T = \left(\begin{array}{ccc|c|ccc} 1 & & & 0 & 0 & \cdots & 0 \\ & \ddots & & \vdots & \vdots & & \vdots \\ & & 1 & 0 & 0 & \cdots & 0 \\ \hline 0 & \cdots & 0 & 1 & 0 & \cdots & 0 \\ \hline 0 & \cdots & 0 & -v^{(k)}_{k+1} & 1 & & \\ \vdots & & \vdots & \vdots & & \ddots & \\ 0 & \cdots & 0 & -v^{(k)}_n & & & 1 \end{array}\right), \end{aligned}
otteniamo
\bm{L}_k\bm{A}^{(k)}= \left(\begin{array}{ccc|cccc} A^{(1)}_{1,1} & \cdots & A^{(1)}_{1,k-1} & A^{(1)}_{1,k} & A^{(1)}_{1,k+1} & \cdots & A^{(1)}_{1,n} \\ & \ddots & \vdots & \vdots & \vdots & & \vdots \\ 0 & & A^{(k-1)}_{k-1,k-1} & A^{(k-1)}_{k-1,k} & A^{(k-1)}_{k-1,k+1} & \cdots & A^{(k-1)}_{k-1,n} \\ \hline 0 & \cdots & 0 & A^{(k)}_{k,k} & A^{(k)}_{k,k+1} & \cdots & A^{(k)}_{k,n} \\ 0 & \cdots & 0 & 0 & A^{(k+1)}_{k+1,k+1} & \cdots & A^{(k+1)}_{k+1,n} \\ \vdots & & \vdots & \vdots & \vdots & & \vdots \\ 0 & \cdots & 0 & 0 & A^{(k+1)}_{n,k+1} & \cdots & A^{(k+1)}_{n,n} \end{array}\right), \quad \bm{L}_k\bm{b}^{(k)}=\left(\begin{array}{c} b^{(1)}_1 \\ \vdots \\ b^{(k-1)}_{k-1} \\ b^{(k)}_{k} \\ b^{(k+1)}_{k+1} \\ \vdots \\ b^{(k+1)}_n \end{array}\right),
dove
\begin{aligned} A^{(k+1)}_{i,j} &= A^{(k)}_{i,j}-v^{(k)}_i A^{(k)}_{k,j},\qquad &i,j&=k+1,k+2,\ldots,n \\ b^{(k+1)}_i &= b^{(k)}_i-v^{(k)}_i b^{(k)}_i & i&=k+1,k+2,\ldots,n. \end{aligned}
L’algoritmo di Gauss applica lo stesso processo iterativo su matrici sempre più piccole fino a ottenere la triangolarizzazione della matrice originale. Ad ogni passo, le operazioni elementari di riga riducono progressivamente la dimensione della matrice fino a raggiungere una forma triangolare superiore.
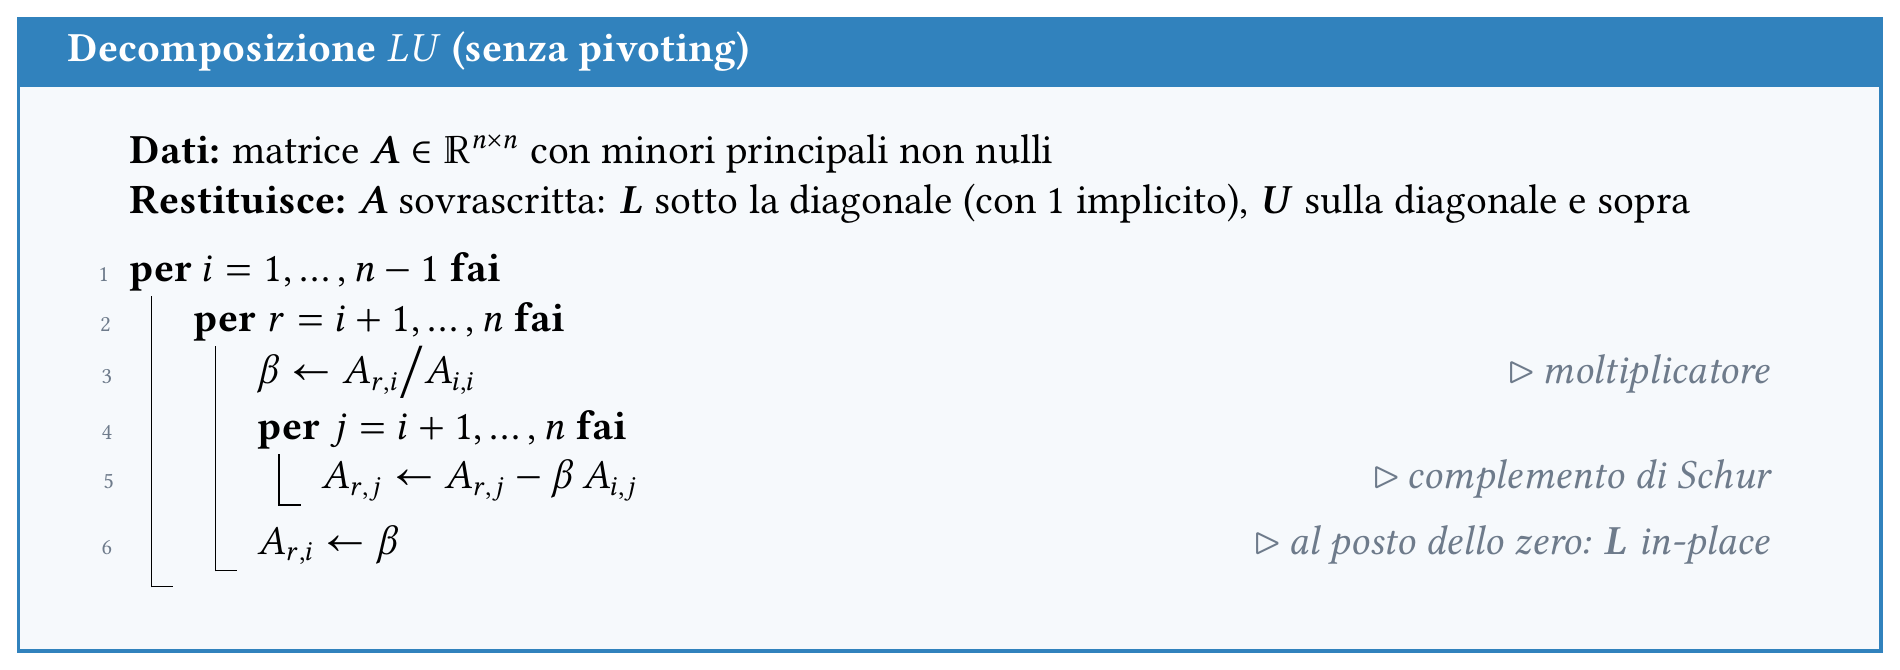
L’algoritmo modifica la matrice \bm{A} in-place: i coefficienti di eliminazione prendono il posto degli zeri sotto la diagonale, formando \bm{L} (con 1 sottintesi sulla diagonale), mentre sopra la diagonale resta \bm{U}.
1.6 Algoritmo di Gauss in presenza di pivoting
Nel processo di eliminazione di Gauss di base, l’algoritmo esegue operazioni sulle righe per convertire una matrice in una forma triangolare superiore. Tuttavia, questo metodo può incontrare instabilità numerica, specialmente quando la matrice presenta elementi di pivot molto piccoli o è mal condizionata. Per migliorare la stabilità numerica e l’accuratezza, si utilizza il pivoting parziale.
Il pivoting parziale consiste nel selezionare l’elemento di valore assoluto massimo nella colonna corrente come pivot e scambiare le righe per portare questo elemento massimo nella posizione del pivot. Questa strategia aiuta a minimizzare gli errori di arrotondamento e migliora la robustezza dell’algoritmo.
Per analizzare l’algoritmo di eliminazione di Gauss con pivoting parziale, è necessario gestire anche le matrici di scambio che vengono introdotte. Queste matrici sono utilizzate per scambiare righe e devono essere propagate attraverso le operazioni di fattorizzazione. Introduciamo quindi il seguente lemma per capire questo processo:
Lemma 1.3 (Frobenius e Scambi) Sia \bm{F} = \bm{I} - \bm{v} \bm{e}_k^T una matrice di Frobenius e \bm{S}_{i,j} una matrice di scambio che scambia le righe i e j. Se i e j sono entrambi maggiori di k, allora la matrice risultante \bm{F} \bm{S}_{i,j} può essere scritta come \bm{S}_{i,j} \bm{F}', dove \bm{F}' è anch’essa una matrice di Frobenius. In particolare:
\bm{F}' = \bm{I} - \bm{w} \bm{e}_k^T, \quad \text{dove} \quad \bm{w} = \bm{S}_{i,j} \bm{v}.
Dimostrazione. Calcoliamo direttamente il prodotto \bm{F} \bm{S}_{i,j} e confrontiamolo con la forma \bm{S}_{i,j} \bm{F}'.
Osservazione sui vettori unitari: Nota che \bm{e}_k^T \bm{S}_{i,j} \bm{x} = x_k=\bm{e}_k^T\bm{x} se i \neq k e j \neq k. Questo perché, quando i e j sono diversi da k, la matrice di scambio \bm{S}_{i,j} non sposta la k-esima componente. Quindi possiamo scrivere \bm{e}_k^T \bm{S}_{i,j} = \bm{e}_k^T.
Calcolo di \bm{F} \bm{S}_{i,j}: Consideriamo il prodotto: \begin{aligned} \bm{F} \bm{S}_{i,j} &= (\bm{I} - \bm{v} \bm{e}_k^T) \bm{S}_{i,j} \\ &= \bm{S}_{i,j} - \bm{v} \bm{e}_k^T \bm{S}_{i,j} \\ &= \bm{S}_{i,j} - \bm{v} \bm{e}_k^T\qquad[\text{per il punto 1}] \end{aligned}
Calcolo di \bm{S}_{i,j} \bm{F}': Sostituendo \bm{F}' = \bm{I} - \bm{w} \bm{e}_k^T, otteniamo:
\begin{aligned} \bm{S}_{i,j} \bm{F}' &= \bm{S}_{i,j} (\bm{I} - \bm{w} \bm{e}_k^T) \\ &= \bm{S}_{i,j} - \bm{S}_{i,j} \bm{w} \bm{e}_k^T, \\ &= \bm{S}_{i,j} - \bm{S}_{i,j}\bm{S}_{i,j} \bm{v} \bm{e}_k^T .\\ &= \bm{S}_{i,j} - \bm{v} \bm{e}_k^T. \qquad[\text{per la proprietà $\bm{S}_{i,j}\bm{S}_{i,j}=\bm{I}$}] \end{aligned}
e quindi \bm{F} \bm{S}_{i,j}=\bm{S}_{i,j} \bm{F}'.
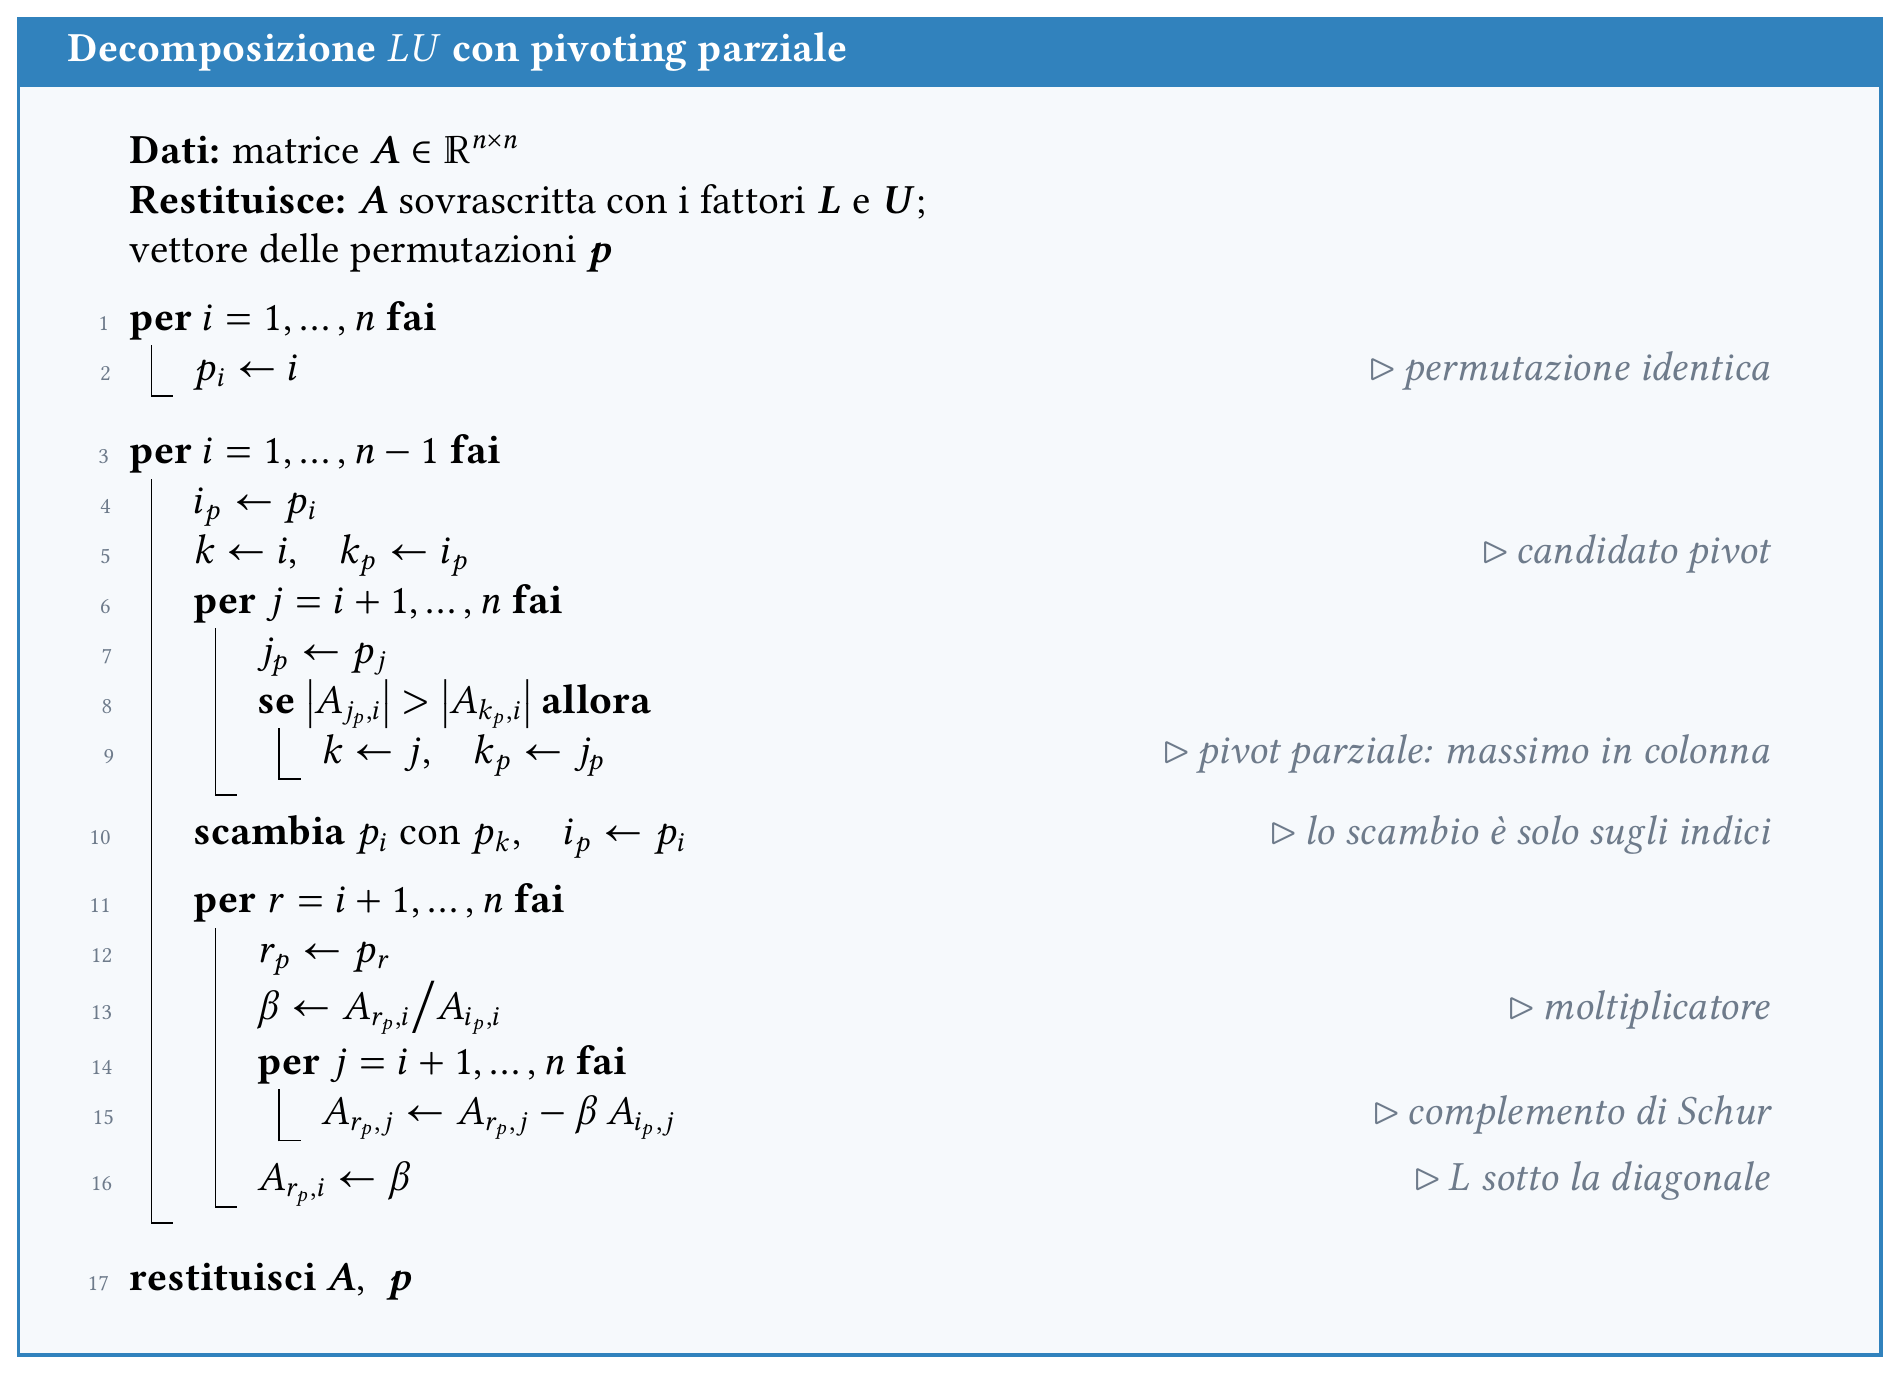
L’algoritmo di Gauss con pivoting può essere formulato come segue:
\bm{L}_{n-1}\bm{P}_{n-1}\bm{L}_{n-2}\bm{P}_{n-2}\cdots\bm{L}_2\bm{P}_2\bm{L}_1\bm{P}_1\bm{A} = \bm{U},
dove \bm{P}_k è una matrice di scambio, utilizzata se è necessario scambiare righe al k-esimo passo dell’algoritmo di Gauss. Quando non è necessario scambiare righe, \bm{P}_k è la matrice identità. Si osserva che \bm{P}_k = \bm{S}_{i,j} per i,j \geq k, e quindi, applicando il lemma Lemma 1.3, otteniamo che:
\bm{P}_k \bm{L}_{k-1} = \bm{L}_{k-1}' \bm{P}_k,
dove \bm{L}_{k-1}' = \bm{I} - \bm{w}_k \bm{e}_k^T e \bm{w}_k = \bm{P}_k \cdots \bm{P}_2 \bm{P}_1 \bm{v}_k. Spostando le matrici di scambio a destra nell’equazione precedente, otteniamo:
\left(\bm{L}_{n-1}' \bm{L}_{n-2}' \cdots \bm{L}_2' \bm{L}_1'\right) \left(\bm{P}_{n-1} \bm{P}_{n-2} \cdots \bm{P}_2 \bm{P}_1\right) \bm{A} = \bm{U},
dove la matrice \bm{U} è triangolare superiore e le matrici \bm{L}_k' sono matrici di Frobenius date da:
\bm{L}_k' = \bm{I} - \bm{w}_k \bm{e}_k^T, \qquad \bm{w}_k = \bm{P}_k \cdots \bm{P}_2 \bm{P}_1 \bm{v}_k.
Definiamo ora:
\bm{L} = (\bm{L}_1')^{-1} (\bm{L}_2')^{-1} \cdots (\bm{L}_{n-1}')^{-1}, \qquad \bm{P} = \bm{P}_{n-1} \bm{P}_{n-2} \cdots \bm{P}_2 \bm{P}_1,
e otteniamo:
\bm{P} \bm{A} = \bm{L} \bm{U}.
Quindi, l’algoritmo di eliminazione consente di decomporre la matrice \bm{P} \bm{A} in un prodotto \bm{L} \bm{U}, dove \bm{P} rappresenta la sequenza di scambi di righe applicati alla matrice \bm{A}, e \bm{L} e \bm{U} sono rispettivamente la matrice triangolare inferiore e superiore ottenute tramite la decomposizione LU.
Esempio
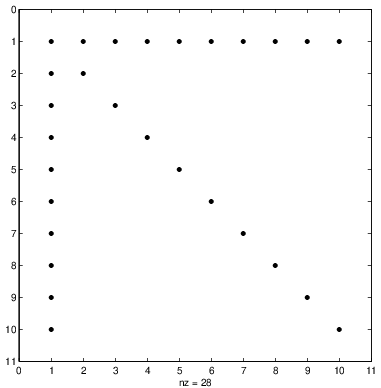
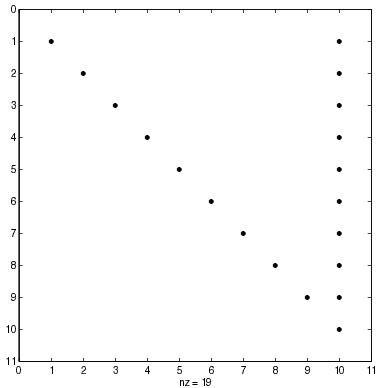
Consideriamo la fattorizzazione LU della matrice \bm{A}\in\mathbb{R}^{10\times 10}
\bm{A} = \begin{pmatrix} \bm{1} & \bm{1} & \bm{1} & \bm{1} & \bm{1} & \bm{1} & \bm{1} & \bm{1} & \bm{1} & \bm{1} \\ \bm{1} & \bm{1} & 0 & 0 & 0 & 0 & 0 & 0 & 0 & 0 \\ \bm{1} & 0 & \bm{1} & 0 & 0 & 0 & 0 & 0 & 0 & 0 \\ \bm{1} & 0 & 0 & \bm{1} & 0 & 0 & 0 & 0 & 0 & 0 \\ \bm{1} & 0 & 0 & 0 & \bm{1} & 0 & 0 & 0 & 0 & 0 \\ \bm{1} & 0 & 0 & 0 & 0 & \bm{1} & 0 & 0 & 0 & 0 \\ \bm{1} & 0 & 0 & 0 & 0 & 0 & \bm{1} & 0 & 0 & 0 \\ \bm{1} & 0 & 0 & 0 & 0 & 0 & 0 & \bm{1} & 0 & 0 \\ \bm{1} & 0 & 0 & 0 & 0 & 0 & 0 & 0 & \bm{1} & 0 \\ \bm{1} & 0 & 0 & 0 & 0 & 0 & 0 & 0 & 0 & \bm{1} \end{pmatrix}
e della matrice che si ottiene prendendo righe e colonne nell’ordine inverso, cioè
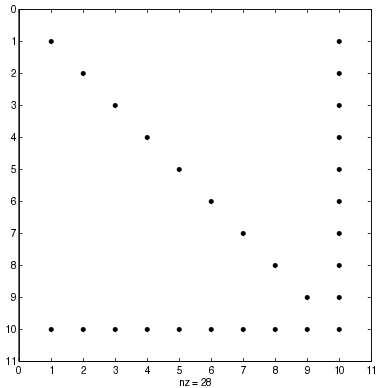
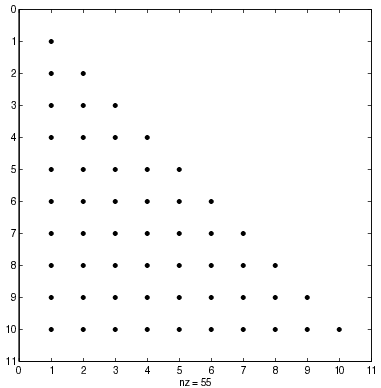
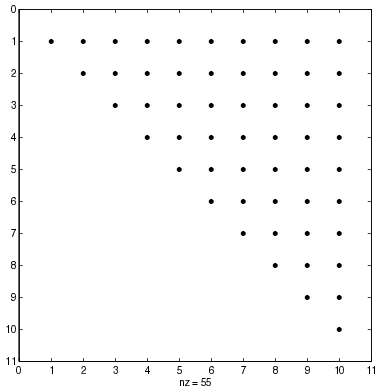
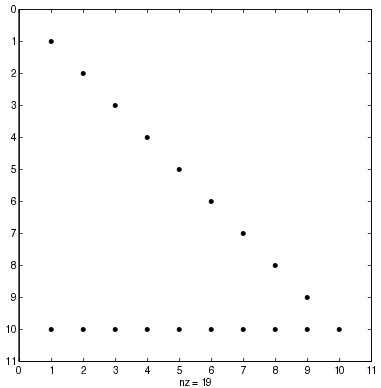
\bm{P}\bm{A}\bm{P} = \begin{pmatrix} \bm{1} & 0 & 0 & 0 & 0 & 0 & 0 & 0 & 0 & \bm{1} \\ 0 & \bm{1} & 0 & 0 & 0 & 0 & 0 & 0 & 0 & \bm{1} \\ 0 & 0 & \bm{1} & 0 & 0 & 0 & 0 & 0 & 0 & \bm{1} \\ 0 & 0 & 0 & \bm{1} & 0 & 0 & 0 & 0 & 0 & \bm{1} \\ 0 & 0 & 0 & 0 & \bm{1} & 0 & 0 & 0 & 0 & \bm{1} \\ 0 & 0 & 0 & 0 & 0 & \bm{1} & 0 & 0 & 0 & \bm{1} \\ 0 & 0 & 0 & 0 & 0 & 0 & \bm{1} & 0 & 0 & \bm{1} \\ 0 & 0 & 0 & 0 & 0 & 0 & 0 & \bm{1} & 0 & \bm{1} \\ 0 & 0 & 0 & 0 & 0 & 0 & 0 & 0 & \bm{1} & \bm{1} \\ \bm{1} & \bm{1} & \bm{1} & \bm{1} & \bm{1} & \bm{1} & \bm{1} & \bm{1} & \bm{1} & \bm{1} \end{pmatrix} Abbiamo considerato gli elementi non nulli di \bm{A} come aventi valore 1, ma l’argomento che desideriamo illustrare riguarda esclusivamente il processo di formazione di nuovi elementi non nulli durante la fattorizzazione, noto con il termine inglese fill-in. Questo è distinto dal valore che tali elementi assumono nei fattori di Gauss \bm{L} e \bm{U}.
In seguito, analizzeremo la struttura degli elementi non nulli nella matrice \bm{A}, nella matrice permutata simmetricamente \bm{P}\bm{A}\bm{P}, e nei rispettivi fattori triangolari superiori e inferiori ottenuti dall’algoritmo di Gauss, assumendo che non sia necessario eseguire pivoting numerico.
È importante notare che nella forma originale della matrice \bm{A}, i fattori risultanti dall’algoritmo di Gauss sono pieni, il che implica un riempimento totale.
Invece, nella forma permutata, non si generano nuovi elementi non nulli. Inoltre, poiché la diagonale di \bm{L} è composta esclusivamente da 1, non è necessario memorizzarla. Di conseguenza, non viene richiesta ulteriore memoria rispetto a quella necessaria per memorizzare gli elementi non nulli della matrice.
In sintesi
- L’eliminazione di Gauss trasforma \bm{A}\bm{x}=\bm{b} in un sistema triangolare con \sim 2n^3/3 flop; la risoluzione all’indietro costa poi solo \mathcal{O}(n^2).
- In forma matriciale ogni passo è la moltiplicazione per una matrice di Frobenius \bm{F}_k, la cui inversa si ottiene cambiando di segno i moltiplicatori: da qui \bm{A}=\bm{L}\bm{U} a costo nullo.
- La fattorizzazione LU va calcolata una volta sola: sistemi con la stessa matrice e termini noti diversi costano \mathcal{O}(n^2) ciascuno.
- Il pivoting parziale serve alla stabilità, non all’esistenza: scambia le righe per massimizzare il pivot e dà \bm{P}\bm{A}=\bm{L}\bm{U}.
- Pivot simbolicamente nullo e pivot numericamente piccolo sono problemi diversi: il primo riguarda la singolarità, il secondo l’amplificazione degli errori di arrotondamento.