
# prodotto di Cauchy: (a*b)_[k] = sum_j a_[j] b_[k-j]
cauchy <- function(a, b, k) sum(a[1:(k + 1)] * b[(k + 1):1])

# coefficienti di Taylor di Lotka-Volterra fino all'ordine p
lv_coef <- function(u0, v0, p, par) {
  u <- numeric(p + 1); v <- numeric(p + 1)
  u[1] <- u0; v[1] <- v0                       # u[j+1] contiene u_[j]
  for (k in 0:(p - 1)) {
    uv <- cauchy(u, v, k)
    u[k + 2] <- (par$alpha * u[k + 1] - par$beta  * uv       ) / (k + 1)
    v[k + 2] <- (par$delta * uv       - par$gamma * v[k + 1] ) / (k + 1)
  }
  list(u = u, v = v)
}

# un passo = somma della serie troncata; poi si itera
lv_taylor <- function(u0, v0, h, n, p, par) {
  U <- numeric(n + 1); V <- numeric(n + 1)
  U[1] <- u0; V[1] <- v0; pw <- h^(0:p)
  for (i in 1:n) {
    C <- lv_coef(U[i], V[i], p, par)
    U[i + 1] <- sum(C$u * pw)
    V[i + 1] <- sum(C$v * pw)
  }
  cbind(t = (0:n) * h, u = U, v = V)
}29 Metodi di Taylor per ODE
Consideriamo la seguente equazione differenziale ordinaria (ODE):
\left\{ \begin{aligned} y' &= f(t,y) \\ y(a) &= y_a \end{aligned} \right. \tag{29.1}
Sotto le usuali condizioni di regolarità per f(t, y), possiamo garantire l’esistenza e l’unicità della soluzione.
Per approssimare numericamente la soluzione nell’intervallo [a, b], dividiamo l’intervallo in n parti uguali con ampiezza h = (b - a) / n. Cerchiamo di calcolare la soluzione in corrispondenza dei punti:
t_k = a + kh, \qquad k=0,1,\dots,n.
La soluzione esatta y(t) soddisfa:
y'(t) = f(t,y(t)), \qquad y(a) = y_a.
Possiamo sfruttare lo sviluppo in serie di Taylor1 per costruire metodi numerici che approssimano la soluzione.
29.1 Metodo di Eulero e Serie di Taylor
Utilizziamo la serie di Taylor per approssimare la soluzione y(t) al primo ordine:
y(t_{k+1}) = y(t_k) + y'(t_k) h + \dfrac{y''(\zeta)}{2}h^2, \qquad \zeta \in (t_k, t_{k+1}),
dove y'(t_k) si ottiene direttamente dalla ODE come y'(t_k) = f(t_k, y(t_k)). Otteniamo così:
y(t_{k+1}) = y(t_k) + f(t_k, y(t_k)) h + \dfrac{y''(\zeta)}{2}h^2.
Trascurando il termine d’errore \mathcal{O}(h^2), otteniamo il metodo di Eulero2 esplicito:
y_{k+1} = y_k + f(t_k, y_k) h,
che è un metodo del primo ordine.
29.2 Metodo di Taylor al Secondo Ordine
Per ottenere una migliore approssimazione, possiamo considerare un’espansione della serie di Taylor fino al secondo ordine:
y(t_{k+1}) = y(t_k) + y'(t_k) h + \dfrac{y''(t_k)}{2} h^2 + \dfrac{y'''(\zeta)}{6} h^3,\quad \zeta\in(t_k,t_{k+1})
Il problema che emerge è il calcolo di y''(t_k), che non è immediatamente disponibile. Tuttavia, possiamo calcolarlo derivando la ODE rispetto a t:
y''(t) = \dfrac{\mathrm{d}}{\mathrm{d}t} y'(t) = \dfrac{\mathrm{d}}{\mathrm{d}t} f(t, y(t)).
Applicando la chain rule, otteniamo:
y''(t) = \dfrac{\partial f(t, y(t))}{\partial t} + \dfrac{\partial f(t, y(t))}{\partial y} \cdot y'(t).
Sostituendo y'(t) con f(t, y(t)), possiamo esprimere y''(t) come:
y''(t) = \dfrac{\partial f(t, y(t))}{\partial t} + \dfrac{\partial f(t, y(t))}{\partial y} \cdot f(t, y(t)).
Sostituendo questa espressione nello sviluppo di Taylor, otteniamo:
\begin{aligned} y(t_{k+1}) &= y(t_k) + f(t_k, y(t_k)) h \\ &\quad + \dfrac{h^2}{2} \left( \dfrac{\partial f(t_k, y(t_k))}{\partial t} + \dfrac{\partial f(t_k, y(t_k))}{\partial y} \cdot f(t_k, y(t_k)) \right) \\ &\quad + \mathcal{O}(h^3). \end{aligned}
Trascurando il termine \mathcal{O}(h^3), otteniamo un metodo di Taylor al secondo ordine:
y_{k+1} = y_k + f(t_k, y_k) h + \dfrac{h^2}{2} \left( \dfrac{\partial f(t_k, y_k)}{\partial t} + \dfrac{\partial f(t_k, y_k)}{\partial y} \cdot f(t_k, y_k) \right).
Osservazione 29.1. Il calcolo delle derivate parziali di f(t, y) è essenziale per costruire metodi di Taylor di ordine superiore. Tuttavia, per funzioni complesse, il calcolo manuale delle derivate può risultare molto laborioso e soggetto a errori. In questi casi, l’uso del calcolo simbolico diventa fondamentale.
Software come Mathematica, Maple, o librerie di Python come SymPy permettono di automatizzare il processo di differenziazione simbolica.
29.3 Metodo di Taylor al Terzo Ordine
Per ottenere una migliore approssimazione della soluzione, possiamo estendere la serie di Taylor fino al terzo ordine:
\begin{aligned} y(t_{k+1}) &= y(t_k) + y'(t_k) h + \dfrac{y''(t_k)}{2} h^2 \\ &\quad + \dfrac{y'''(t_k)}{6} h^3 + \dfrac{y^{(4)}(\zeta)}{24} h^4, \quad \zeta \in (t_k, t_{k+1}). \end{aligned}
Il calcolo di y''(t_k) è già stato fatto nel metodo di Taylor al secondo ordine. Per y'''(t_k), possiamo procedere come segue:
\begin{aligned} y'''(t) &= \dfrac{\mathrm{d}}{\mathrm{d}t} y''(t) \\ &= \dfrac{\mathrm{d}}{\mathrm{d}t} \left( \dfrac{\partial f(t, y(t))}{\partial t} + \dfrac{\partial f(t, y(t))}{\partial y} \cdot f(t, y(t)) \right) \\ &= \dfrac{\partial^2 f(t, y(t))}{\partial t^2} + \dfrac{\partial^2 f(t, y(t))}{\partial y^2} f(t, y(t))^2 \\ &\quad + \left( \dfrac{\partial f(t, y(t))}{\partial y} \right)^2 f(t, y(t)) + 2 \dfrac{\partial^2 f(t, y(t))}{\partial t \partial y} f(t, y(t)) \\ &\quad + \dfrac{\partial f(t, y(t))}{\partial t} \cdot \dfrac{\partial f(t, y(t))}{\partial y}. \end{aligned}
Notazione Compatta
Per semplificare la scrittura e il calcolo, possiamo introdurre alcune scorciatoie:
\begin{aligned} f_k &= f(t_k, y(t_k)), \\ f_{t,k} &= \dfrac{\partial f(t_k, y(t_k))}{\partial t}, \\ f_{y,k} &= \dfrac{\partial f(t_k, y(t_k))}{\partial y}, \\ f_{tt,k} &= \dfrac{\partial^2 f(t_k, y(t_k))}{\partial t^2}, \\ f_{yy,k} &= \dfrac{\partial^2 f(t_k, y(t_k))}{\partial y^2}, \\ f_{ty,k} &= \dfrac{\partial^2 f(t_k, y(t_k))}{\partial t \partial y}. \end{aligned}
Sostituendo queste espressioni nello sviluppo di Taylor, otteniamo:
\begin{aligned} y(t_{k+1}) &= y(t_k) + h f_k \\ &\quad + \dfrac{h^2}{2} \left( f_{t,k} + f_{y,k} f_k \right) \\ &\quad + \dfrac{h^3}{6} \left( f_{tt,k} + f_{yy,k} f_k^2 + ( f_{y,k}^2 + 2 f_{ty,k} ) f_k + f_{t,k} f_{y,k} \right) \\ &\quad + \mathcal{O}(h^4). \end{aligned}
Metodo di Taylor al Terzo Ordine
Trascurando il termine d’errore \mathcal{O}(h^4), otteniamo il metodo di Taylor al terzo ordine:
\begin{aligned} y_{k+1} &= y_k + f(t_k, y_k) h \\ &\quad + \dfrac{h^2}{2} \left( \dfrac{\partial f(t_k, y_k)}{\partial t} + \dfrac{\partial f(t_k, y_k)}{\partial y} \cdot f(t_k, y_k) \right) \\ &\quad + \dfrac{h^3}{6} \left( f_{tt,k} + f_{yy,k} f_k^2 + ( f_{y,k}^2 + 2 f_{ty,k} ) f_k + f_{t,k} f_{y,k} \right). \end{aligned}
Considerazioni sul metodo
Nota
I metodi basati su Taylor richiedono il calcolo di derivate parziali multiple della funzione f(t, y). Questo pone alcune sfide significative:
Derivate simboliche: Per usare un metodo di ordine superiore, è necessario calcolare simbolicamente (o con un software di algebra computazionale) un numero crescente di derivate parziali.
Crescita della complessità: La complessità del metodo cresce rapidamente con l’ordine, rendendo l’implementazione e il calcolo più difficili per ordini superiori al terzo.
Tuttavia, se la forma analitica di f(t, y) è nota in anticipo, è possibile costruire un metodo numerico basato sulla serie di Taylor specifico per quella funzione, ottenendo così un’accurata approssimazione della soluzione.
29.4 Metodo basato su Taylor con f(t,y) nota
Sia y(t) la soluzione analitica della seguente equazione differenziale ordinaria (ODE):
y'(t) = f(t, y(t)).
Consideriamo la serie di Taylor della soluzione:
\begin{aligned} y(t+h) &= y(t) + h y'(t) + \dfrac{h^2}{2} y''(t) + \cdots + \dfrac{h^p}{p!} y^{(p)}(t) + \mathcal{O}(h^{p+1}), \end{aligned} \tag{29.2}
dove ogni derivata k-esima può essere espressa in termini della funzione f(t, y(t)). A partire da questa relazione, possiamo costruire delle funzioni D_k(t, y) che hanno la proprietà:
y^{(k)}(t) = D_k(t, y(t)),
ovvero, se valutate sulla soluzione esatta y(t), restituiscono la derivata k-esima della soluzione stessa.
Definizione ricorsiva di D_k(t,y)
La costruzione delle funzioni D_k(t, y) è ricorsiva e parte dalla definizione:
D_1(t, y) = f(t, y),
poiché y'(t) = f(t, y(t)) = D_1(t, y(t)).
Se supponiamo che y^{(k)}(t) = D_k(t, y(t)), possiamo derivare y^{(k+1)}(t) come segue:
\begin{aligned} y^{(k+1)}(t) &= \dfrac{\mathrm{d}}{\mathrm{d}t} y^{(k)}(t) \\ &= \dfrac{\mathrm{d}}{\mathrm{d}t} D_k(t, y(t)) \\ &= \dfrac{\partial D_k(t, y(t))}{\partial t} + \dfrac{\partial D_k(t, y(t))}{\partial y} \cdot y'(t) \\ &= \dfrac{\partial D_k(t, y(t))}{\partial t} + \dfrac{\partial D_k(t, y(t))}{\partial y} \cdot f(t, y(t)). \end{aligned}
Da questa relazione, otteniamo la seguente formula ricorsiva per D_{k+1}(t, y):
\left[ \begin{aligned} D_1(t, y) &= f(t, y), \\ D_{k+1}(t, y) &= \dfrac{\partial D_k(t, y)}{\partial t} + \dfrac{\partial D_k(t, y)}{\partial y} \cdot f(t, y), \quad k = 1, 2, \ldots \end{aligned} \right.
Espansione della soluzione con D_k(t,y)
Sostituendo queste funzioni ricorsive nella serie di Taylor, otteniamo l’espansione completa:
\begin{aligned} y(t+h) &= y(t) + h D_1(t, y(t)) + \dfrac{h^2}{2} D_2(t, y(t)) \\ &\quad + \dfrac{h^3}{6} D_3(t, y(t)) + \cdots + \dfrac{h^p}{p!} D_p(t, y(t)) + \mathcal{O}(h^{p+1}). \end{aligned}
Da qui possiamo derivare un metodo numerico che approssima la soluzione della ODE fino all’ordine p:
\left[ \begin{aligned} y_{k+1} &= y_k + h y'_k + \dfrac{h^2}{2} y''_k + \dfrac{h^3}{6} y'''_k + \cdots + \dfrac{h^p}{p!} y^{(p)}_k, \\[1em] y'_k &= D_1(t_k, y_k), \\ y''_k &= D_2(t_k, y_k), \\ y'''_k &= D_3(t_k, y_k), \\ &\vdots \\ y^{(p)}_k &= D_p(t_k, y_k). \end{aligned} \right.
Esempio: f(t,y)=t+y+ty
Consideriamo la seguente equazione differenziale ordinaria:
\left\{ \begin{aligned} y' &= t + y + ty, \\ y(a) &= y_a. \end{aligned} \right.
Per questa ODE, le funzioni D_k(t, y) si calcolano come segue:
\begin{aligned} D_1(t, y) &= t + y + ty, \\[2em] D_2(t, y) &= \dfrac{\partial D_1(t, y)}{\partial t} + \dfrac{\partial D_1(t, y)}{\partial y} \cdot D_1(t, y) \\ &= y + 1 + (t + 1)(ty + t + y), \\[2em] D_3(t, y) &= \dfrac{\partial D_2(t, y)}{\partial t} + \dfrac{\partial D_2(t, y)}{\partial y} \cdot D_1(t, y) \\ &= (y + 1)t^3 + (3y + 2)t^2 + (6y + 4)t + 4y + 1, \\[2em] D_4(t, y) &= \dfrac{\partial D_3(t, y)}{\partial t} + \dfrac{\partial D_3(t, y)}{\partial y} \cdot D_1(t, y) \\ &= (y + 1)t^4 + (4y + 3)t^3 + (12y + 9)t^2 + (16y + 8)t + 10y + 4, \\[2em] D_5(t, y) &= \dfrac{\partial D_4(t, y)}{\partial t} + \dfrac{\partial D_4(t, y)}{\partial y} \cdot D_1(t, y) \\ &= (y + 1)t^5 + (5y + 4)t^4 + (20y + 16)t^3 + (40y + 25)t^2 + (50y + 28)t + 26y + 8, \\[2em] D_6(t, y) &= \dfrac{\partial D_5(t, y)}{\partial t} + \dfrac{\partial D_5(t, y)}{\partial y} \cdot D_1(t, y) \\ &= (y + 1)t^6 + (6y + 5)t^5 + (30y + 25)t^4 + (80y + 56)t^3 + (150y + 98)t^2 + (156y + 76)t + 76y + 28. \end{aligned}
Metodo Numerico di Ordine 6
Utilizzando fino alla derivata sesta, possiamo costruire un metodo numerico di ordine 6 per approssimare la soluzione:
\left[ \begin{aligned} y_{k+1} &= y_k + h y'_k + \dfrac{h^2}{2!} y''_k + \dfrac{h^3}{3!} y'''_k + \dfrac{h^4}{4!} y''''_k + \dfrac{h^5}{5!} y'''''_k + \dfrac{h^6}{6!} y''''''_k, \\[1em] y'_k &= D_1(t_k, y_k), \\ y''_k &= D_2(t_k, y_k), \\ y'''_k &= D_3(t_k, y_k), \\ y''''_k &= D_4(t_k, y_k), \\ y'''''_k &= D_5(t_k, y_k), \\ y''''''_k &= D_6(t_k, y_k). \end{aligned} \right.
29.5 Metodo di Taylor migliorato
La costruzione delle funzioni D_k(t,y) richiede la sostituzione di y'(t)=D_1(t,y(t)) che poi viene derivato nel calcolo delle funzioni successive. Se si evita questa sostituzione si ottengono delle funzioni ugualmente calcolabili ma in generale più semplici.
Consideriamo la sequenza
\begin{aligned} \color{red}y'(t) &= f(t,y(t)) = D_1(t,y(t)) \\ \color{blue}y''(t) &= \dfrac{\mathrm{d}}{\mathrm{d}t}D_1(t,y(t)) \\ &= \dfrac{\partial D_1(t,y(t))}{\partial t} + \dfrac{\partial D_1(t,y(t))}{\partial y} {\color{red}y'(t)} \\ & = D_2(t,y(t),y'(t)) \\ y'''(t) &= \dfrac{\mathrm{d}}{\mathrm{d}t}D_2(t,y(t),y'(t)) \\ &= \dfrac{\partial D_2(t,y(t),y'(t))}{\partial t} + \dfrac{\partial D_2(t,y(t),y'(t))}{\partial y} {\color{red}y'(t)} + \dfrac{\partial D_2(t,y(t),y'(t))}{\partial y'} {\color{blue}y''(t)}\\ & = D_3(t,y(t),y'(t),y''(t)) \\ &~~\vdots \end{aligned}
questa suggerisce la definizione delle funzioni
D_k(t,y,y',\ldots,y^{(k-1)})
tali che data la soluzione esatta y(t) vale
y^{(k)}(t) = D_k(t,y(t),y'(t),\ldots,y^{(k-1)}(t))
e che soddisfano la ricorrenza:
\left[ \begin{aligned} D_1(t, y) &= f(t, y), \\ D_{k+1}(t, y, y', \ldots, y^{(k)}) &= \dfrac{\partial D_k(t, y, y', \ldots, y^{(k-1)})}{\partial t} \\ & + \sum_{j=0}^{k-1} \dfrac{\partial D_k(t, y, y', \ldots, y^{(k-1)})} {\partial y^{(j)}}y^{(j+1)}, \quad k=1,2,\ldots, \quad y^{(0)}:=y \end{aligned} \right.
Esempio: f(t,y)=t+y+ty
Consideriamo la seguente equazione differenziale ordinaria:
\left\{ \begin{aligned} y' &= t + y + ty, \\ y(a) &= y_a. \end{aligned} \right.
Per questa ODE, le funzioni D_k(t,\ldots) si calcolano come segue (omettiamo gli argomenti per semplicità)
\begin{aligned} D_1 &= t + y + ty, \\[1em] D_2 &= \dfrac{\partial D_1}{\partial t} + \dfrac{\partial D_1}{\partial y} y' \\ &= (t + 1)y' + y + 1, \\[1em] D_3 &= \dfrac{\partial D_2}{\partial t} + \dfrac{\partial D_2}{\partial y} y' + \dfrac{\partial D_2}{\partial y'} y'' \\ &= (t+1)y'' + 2y', \\[1em] D_4 &= \dfrac{\partial D_3}{\partial t} + \dfrac{\partial D_3}{\partial y}y' + \dfrac{\partial D_3}{\partial y'}y'' + \dfrac{\partial D_3}{\partial y''}y''' \\ &= (t+1)y''' + 3y'' \\[1em] D_5 &= \dfrac{\partial D_4}{\partial t} + \dfrac{\partial D_4}{\partial y}y' + \dfrac{\partial D_4}{\partial y'}y'' + \dfrac{\partial D_4}{\partial y''}y''' + \dfrac{\partial D_4}{\partial y'''}y'''' \\ &= (t+1)y'''' + 4y''', \\[1em] D_6 &= \dfrac{\partial D_5}{\partial t} + \dfrac{\partial D_5}{\partial y}y'+ \dfrac{\partial D_5}{\partial y'}y''+ \dfrac{\partial D_5}{\partial y''}y'''+ \dfrac{\partial D_5}{\partial y'''}y''''+ \dfrac{\partial D_5}{\partial y''''}y''''' \\ &= (t+1)y'''''+ 5y''''. \end{aligned}
Metodo Numerico di Ordine 6
Ora possiamo costruire un metodo numerico di ordine 6, utilizzando le derivate fino alla sesta:
\left[ \begin{aligned} y_{k+1} &= y_k + h y'_k + \dfrac{h^2}{2!} y''_k + \dfrac{h^3}{3!} y'''_k + \dfrac{h^4}{4!} y''''_k + \dfrac{h^5}{5!} y'''''_k + \dfrac{h^6}{6!} y''''''_k, \\[1em] y'_k &= (t_k+1) y_k + t_k, \\ y''_k &= (t_k+1) y'_k + y_k + 1, \\ y'''_k &= (t_k+1) y''_k + 2y'_k, \\ y''''_k &= (t_k+1) y'''_k + 3y''_k, \\ y'''''_k &= (t_k+1) y''''_k + 4y'''_k, \\ y''''''_k &= (t_k+1) y'''''_k + 5y''''_k. \end{aligned} \right.
Questo metodo, basato sull’espansione in serie di Taylor, permette di ottenere un’approssimazione di ordine elevato con una complessità computazionale ridotta rispetto alla versione semplice del metodo.
29.6 Sistemi di ODE
Tutto quello che abbiamo visto vale, parola per parola, anche quando l’incognita non è un numero ma un vettore. È il caso interessante nelle applicazioni: un modello di popolazioni, un circuito, un sistema meccanico, un modello epidemiologico sono tutti sistemi di equazioni accoppiate.
Il caso vettoriale: la ricorrenza non cambia
Consideriamo il problema di Cauchy vettoriale
\left\{ \begin{aligned} \mathbf y'(t) &= \mathbf f(t,\mathbf y(t)), \\ \mathbf y(a) &= \mathbf y_a, \end{aligned} \right. \qquad \mathbf y(t)\in\Re^m,\quad \mathbf f:\Re\times\Re^m\to\Re^m . \tag{29.3}
In componenti, \mathbf y=(y_1,\ldots,y_m)^T e \mathbf f=(f_1,\ldots,f_m)^T: le m equazioni sono accoppiate perché ogni f_i può dipendere da tutte le componenti.
Lo sviluppo di Taylor si applica a ciascuna componente, quindi
\mathbf y(t+h)=\mathbf y(t)+h\,\mathbf y'(t) +\frac{h^2}{2}\mathbf y''(t)+\cdots +\frac{h^p}{p!}\mathbf y^{(p)}(t)+\mathcal O(h^{p+1}), \tag{29.4}
ed esattamente come nel caso scalare il problema è esprimere \mathbf y'', \mathbf y''', … in funzione di \mathbf f. Deriviamo la prima equazione rispetto a t usando la regola della catena, che per una funzione a valori vettoriali diventa
\mathbf y''(t)=\frac{\mathrm d}{\mathrm dt}\mathbf f(t,\mathbf y(t)) =\frac{\partial \mathbf f}{\partial t} +\underbrace{\frac{\partial \mathbf f}{\partial \mathbf y}}_{\text{Jacobiana}} \,\mathbf y'(t) =\mathbf f_t+J_{\mathbf f}\,\mathbf f , \tag{29.5}
dove
J_{\mathbf f}(t,\mathbf y)=\frac{\partial\mathbf f}{\partial\mathbf y} =\begin{pmatrix} \dfrac{\partial f_1}{\partial y_1} & \cdots & \dfrac{\partial f_1}{\partial y_m}\\[6pt] \vdots & & \vdots\\[2pt] \dfrac{\partial f_m}{\partial y_1} & \cdots & \dfrac{\partial f_m}{\partial y_m} \end{pmatrix}\in\Re^{m\times m}
è la matrice Jacobiana di \mathbf f, e J_{\mathbf f}\,\mathbf f è un ordinario prodotto matrice–vettore. Confrontando 29.5 con la formula scalare y''=f_t+f_y f si vede che non è cambiato nulla: la derivata parziale \partial f/\partial y è diventata una matrice e il prodotto è diventato un prodotto matrice–vettore.
Lo stesso vale per tutta la ricorrenza. Definendo le funzioni \mathbf D_k:\Re\times\Re^m\to\Re^m come nel caso scalare,
\left[ \begin{aligned} \mathbf D_1(t,\mathbf y) &= \mathbf f(t,\mathbf y), \\ \mathbf D_{k+1}(t,\mathbf y) &= \frac{\partial \mathbf D_k}{\partial t} + J_{\mathbf D_k}(t,\mathbf y)\,\mathbf f(t,\mathbf y), \qquad k=1,2,\ldots \end{aligned} \right. \tag{29.6}
si ottiene \mathbf y^{(k)}(t)=\mathbf D_k(t,\mathbf y(t)) e quindi il metodo di Taylor di ordine p per sistemi
\mathbf y_{k+1}=\mathbf y_k+\sum_{j=1}^{p}\frac{h^j}{j!}\, \mathbf D_j(t_k,\mathbf y_k). \tag{29.7}
Nota
Il prezzo del caso vettoriale non è concettuale ma di taglia. Nel caso scalare al passo k servono le derivate parziali di una funzione; qui serve la Jacobiana m\times m di \mathbf D_k, cioè m^2 derivate parziali, e le espressioni crescono molto in fretta. Per questo, in pratica, non si costruiscono mai esplicitamente le \mathbf D_k: si propagano invece i coefficienti di Taylor, come mostriamo ora.
Dalle derivate ai coefficienti di Taylor
Conviene cambiare incognita. Invece delle derivate \mathbf y^{(k)} usiamo i coefficienti di Taylor normalizzati
\mathbf y_{[k]}=\frac{\mathbf y^{(k)}(t)}{k!}, \qquad\text{cosicché}\qquad \mathbf y(t+h)=\sum_{k\ge0}\mathbf y_{[k]}\,h^k . \tag{29.8}
Il vantaggio è che la relazione fra la funzione e la sua derivata diventa banale: se \mathbf g(t)=\mathbf y'(t) allora
\mathbf y_{[k+1]}=\frac{\mathbf g_{[k]}}{k+1}, \tag{29.9}
perché derivare abbassa di uno l’indice e moltiplica per k+1. Dunque, se so calcolare i coefficienti del secondo membro \mathbf f, i coefficienti della soluzione si ottengono dividendo per k+1. Il problema si sposta tutto sul calcolo dei coefficienti di \mathbf f a partire da quelli di \mathbf y.
La regola di Leibniz e i sistemi polinomiali
Per i secondi membri che si incontrano più spesso — polinomi nelle componenti di \mathbf y — quel calcolo è elementare, perché somme e prodotti si trasformano in operazioni sui coefficienti:
\begin{aligned} (a+b)_{[k]} &= a_{[k]}+b_{[k]}, \\ (\lambda\,a)_{[k]} &= \lambda\,a_{[k]}, \\ (a\,b)_{[k]} &= \sum_{j=0}^{k} a_{[j]}\,b_{[k-j]} . \end{aligned} \tag{29.10}
L’ultima è la regola di Leibniz scritta nei coefficienti normalizzati — un prodotto di convoluzione, lo stesso che si usa per moltiplicare due serie di potenze. Si verifica subito a partire da (ab)^{(k)}=\sum_j\binom{k}{j}a^{(j)}b^{(k-j)} dividendo per k!.
L’algoritmo che ne segue è semplice: si parte da \mathbf y_{[0]}, il valore corrente; si calcolano i coefficienti di \mathbf f di ordine k con 29.10; si ricava \mathbf y_{[k+1]} con 29.9; si ripete fino a k=p-1; infine si somma la serie troncata 29.8. Nessuna derivata simbolica, nessuna Jacobiana, costo \mathcal O(p^2m) per passo.
Esempio: il modello preda–predatore
Il modello di Lotka–Volterra34 descrive due popolazioni: le prede u(t) e i predatori v(t).
\left\{ \begin{aligned} u' &= \alpha\,u-\beta\,uv, \\ v' &= \delta\,uv-\gamma\,v, \end{aligned} \right. \qquad u(0)=u_0,\quad v(0)=v_0 . \tag{29.11}
Le prede crescono con tasso \alpha in assenza di predatori e vengono predate con frequenza proporzionale agli incontri uv; i predatori si riproducono in proporzione agli stessi incontri e muoiono con tasso \gamma. Il sistema è autonomo, quindi \mathbf f_t=\mathbf 0 e 29.5 si riduce a \mathbf y''=J_{\mathbf f}\mathbf f con
J_{\mathbf f}(u,v)= \begin{pmatrix} \alpha-\beta v & -\beta u\\ \delta v & \delta u-\gamma \end{pmatrix}, \qquad \mathbf y''= \begin{pmatrix} \alpha u'-\beta\,(u'v+uv')\\ \delta\,(u'v+uv')-\gamma v' \end{pmatrix}.
La seconda scrittura è già la regola di Leibniz applicata al prodotto uv, e suggerisce la ricorrenza generale. Posto (uv)_{[k]}=\sum_{j=0}^k u_{[j]}v_{[k-j]},
\left[ \begin{aligned} u_{[k+1]} &= \frac{\alpha\,u_{[k]}-\beta\,(uv)_{[k]}}{k+1}, \\[4pt] v_{[k+1]} &= \frac{\delta\,(uv)_{[k]}-\gamma\,v_{[k]}}{k+1}, \end{aligned} \right. \qquad k=0,1,\ldots,p-1 , \tag{29.12}
con u_{[0]}=u_k e v_{[0]}=v_k i valori correnti. Sono poche righe di codice e funzionano per qualunque ordine p.
Integriamo con \alpha=2/3, \beta=4/3, \gamma=\delta=1 e u_0=v_0=0{,}9. Per questi valori l’equilibrio non banale è (\gamma/\delta,\ \alpha/\beta)=(1,\ 1/2) e le orbite sono curve chiuse attorno ad esso: le due popolazioni oscillano indefinitamente, con i predatori in ritardo di fase sulle prede.
par_lv <- list(alpha = 2/3, beta = 4/3, gamma = 1, delta = 1)
u0 <- 0.9; v0 <- 0.9; h <- 0.05; Tend <- 30
S8 <- lv_taylor(u0, v0, h, Tend/h, 8, par_lv)   # ordine 8
S1 <- lv_taylor(u0, v0, h, Tend/h, 1, par_lv)   # ordine 1 = Eulero

op <- par(mfrow = c(1, 2), mar = c(4.2, 4.2, 2.6, 0.8))
matplot(S8[, "t"], S8[, c("u", "v")], type = "l", lty = 1, lwd = 2,
        col = c(4, 2), xlab = "t", ylab = "popolazione",
        main = "Preda-predatore nel tempo")
legend("topright", c("prede u(t)", "predatori v(t)"), col = c(4, 2),
       lwd = 2, bty = "n", cex = 0.85)

plot(S1[, "u"], S1[, "v"], type = "l", lwd = 1.6, col = "grey55",
     xlab = "prede u", ylab = "predatori v", main = "Ritratto di fase",
     xlim = range(S1[, "u"], S8[, "u"]), ylim = range(S1[, "v"], S8[, "v"]))
lines(S8[, "u"], S8[, "v"], lwd = 2.2, col = 4)
points(par_lv$gamma/par_lv$delta, par_lv$alpha/par_lv$beta,
       pch = 4, lwd = 2, col = 2, cex = 1.3)
points(u0, v0, pch = 19, cex = 1)
legend("topright", c("Eulero (p=1)", "Taylor p=8", "equilibrio"),
       col = c("grey55", 4, 2), lwd = c(1.6, 2.2, NA), pch = c(NA, NA, 4),
       bty = "n", cex = 0.8)
par(op)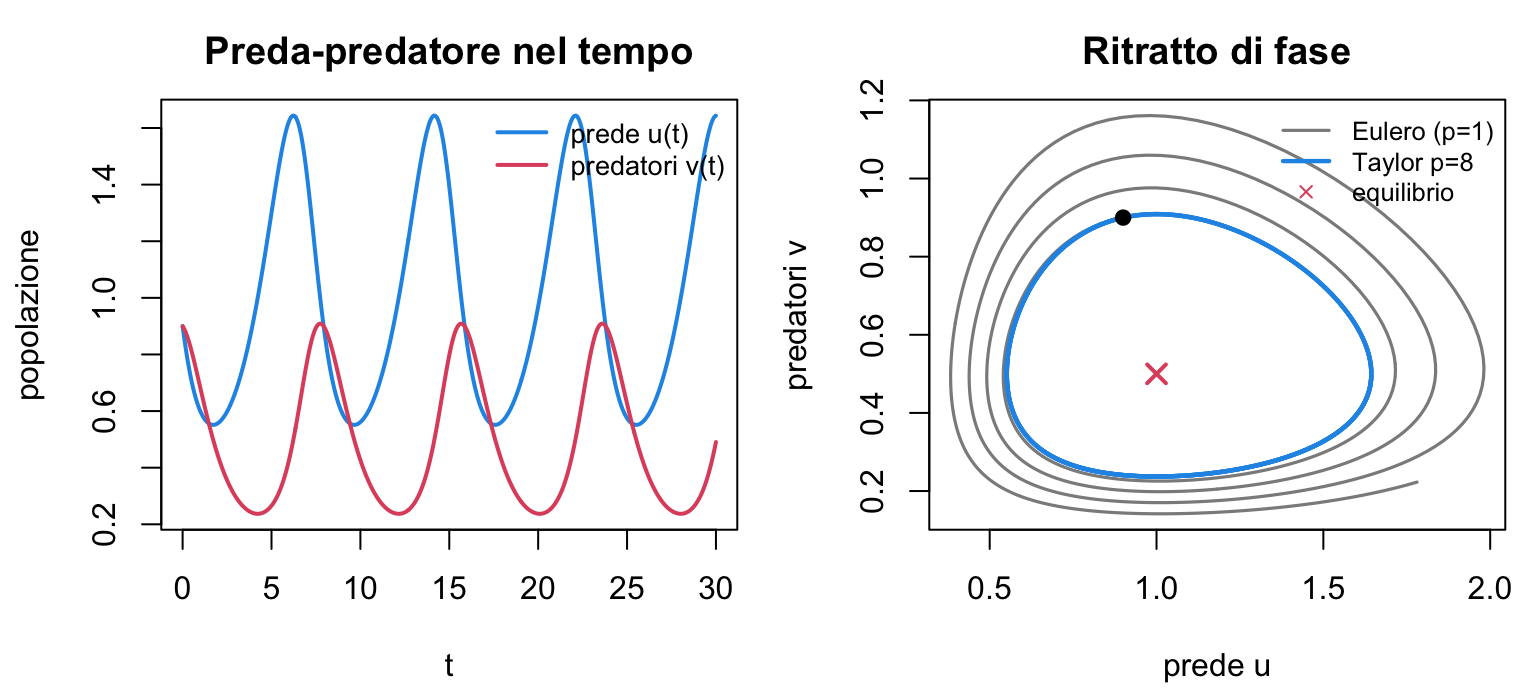
chiusa e il metodo di ordine 8 la riproduce, mentre Eulero (ordine 1) a parita di passo spiraleggia verso l’esterno, cioe` crea energia dal nulla.
Il pannello di destra mostra un fenomeno che il solo errore puntuale non racconta. Il sistema 29.11 possiede una quantità conservata,
V(u,v)=\delta\,u-\gamma\ln u+\beta\,v-\alpha\ln v , \tag{29.13}
costante lungo ogni soluzione: lo si verifica derivando e raccogliendo, \dot V=(\delta u-\gamma)\big[(\alpha-\beta v)+(\beta v-\alpha)\big]=0. Le orbite sono dunque le curve di livello di V, cioè curve chiuse. Eulero non conserva V e l’orbita numerica si allarga ad ogni giro; il metodo di ordine 8, a parità di passo, la mantiene chiusa.
V <- function(u, v, p) p$delta*u - p$gamma*log(u) + p$beta*v - p$alpha*log(v)
V0 <- V(u0, v0, par_lv)
deriva <- sapply(c(1, 2, 4, 8), function(p) {
  S <- lv_taylor(u0, v0, h, Tend/h, p, par_lv)
  max(abs(V(S[, "u"], S[, "v"], par_lv) - V0))
})
knitr::kable(data.frame(ordine_p = c(1, 2, 4, 8),
                        deriva_massima_di_V = sprintf("%.2e", deriva)),
align = c("r", "r"))conservata V su 30 unita di tempo, a parita` di passo h=0.05. L’ordine del metodo si legge direttamente nella colonna di destra.
| ordine_p | deriva_massima_di_V |
|---|---|
| 1 | 2.26e-01 |
| 2 | 1.73e-04 |
| 4 | 6.74e-08 |
| 8 | 2.35e-14 |
Esempio: il modello SIR
Il modello SIR56 divide una popolazione di N individui in tre gruppi: i suscettibili S, gli infetti I e i rimossi R (guariti o deceduti).
\left\{ \begin{aligned} S' &= -\dfrac{\beta}{N}\,S\,I, \\[4pt] I' &= \phantom{-}\dfrac{\beta}{N}\,S\,I-\gamma\,I, \\[4pt] R' &= \phantom{-}\gamma\,I , \end{aligned} \right. \qquad S(0)+I(0)+R(0)=N . \tag{29.14}
Il termine \beta SI/N conta i contagi per unità di tempo: è proporzionale agli incontri fra suscettibili e infetti. Il parametro \gamma è il tasso di rimozione, quindi 1/\gamma è la durata media dell’infezione, e il rapporto
\mathcal R_0=\frac{\beta}{\gamma}
è il numero di riproduzione di base: il numero medio di contagi causati da un infetto in una popolazione interamente suscettibile. Se \mathcal R_0>1 l’epidemia parte, se \mathcal R_0<1 si spegne.
Il secondo membro è di nuovo polinomiale, con un solo prodotto SI: la ricorrenza sui coefficienti è immediata. Posto (SI)_{[k]}=\sum_{j=0}^{k}S_{[j]}I_{[k-j]},
\left[ \begin{aligned} S_{[k+1]} &= \frac{1}{k+1}\left(-\frac{\beta}{N}(SI)_{[k]}\right), \\[4pt] I_{[k+1]} &= \frac{1}{k+1}\left(\frac{\beta}{N}(SI)_{[k]}-\gamma I_{[k]}\right), \\[4pt] R_{[k+1]} &= \frac{1}{k+1}\,\gamma\,I_{[k]} . \end{aligned} \right. \tag{29.15}
ConsiglioIl metodo conserva la popolazione, a ogni ordine
Sommando le tre righe di 29.15 si ottiene, per ogni k\ge0,
S_{[k+1]}+I_{[k+1]}+R_{[k+1]} =\frac{1}{k+1}\left(-\frac{\beta}{N}(SI)_{[k]}+\frac{\beta}{N}(SI)_{[k]} -\gamma I_{[k]}+\gamma I_{[k]}\right)=0 .
Tutti i coefficienti di ordine \ge1 della somma S+I+R sono nulli, quindi la somma calcolata non cambia da un passo all’altro: il vincolo S+I+R=N è soddisfatto esattamente, a meno degli errori di arrotondamento, per qualunque ordine p e qualunque passo h. Non è una proprietà di tutti i metodi: va verificata caso per caso, ed è una delle prime cose da controllare in un codice.
sir_coef <- function(S0, I0, R0, p, par) {
  S <- numeric(p + 1); I <- numeric(p + 1); R <- numeric(p + 1)
  S[1] <- S0; I[1] <- I0; R[1] <- R0
  for (k in 0:(p - 1)) {
    si <- cauchy(S, I, k) * par$beta / par$N
    S[k + 2] <- (-si                        ) / (k + 1)
    I[k + 2] <- ( si - par$gamma * I[k + 1] ) / (k + 1)
    R[k + 2] <- (      par$gamma * I[k + 1] ) / (k + 1)
  }
  list(S = S, I = I, R = R)
}

sir_taylor <- function(y0, h, n, p, par) {
  out <- matrix(0, n + 1, 4); out[1, ] <- c(0, y0); pw <- h^(0:p)
  for (i in 1:n) {
    C <- sir_coef(out[i, 2], out[i, 3], out[i, 4], p, par)
    out[i + 1, ] <- c(i*h, sum(C$S*pw), sum(C$I*pw), sum(C$R*pw))
  }
  colnames(out) <- c("t", "S", "I", "R"); out
}
Integriamo una popolazione di N=1000 individui con un solo infetto iniziale, \beta=0{,}3 e \gamma=0{,}1 al giorno, quindi \mathcal R_0=3.
par_sir <- list(beta = 0.30, gamma = 0.10, N = 1000)
sir <- sir_taylor(c(999, 1, 0), h = 0.5, n = 240, p = 6, par_sir)

par(mar = c(4.2, 4.2, 2.8, 0.8))
matplot(sir[, "t"], sir[, c("S", "I", "R")], type = "l", lty = 1, lwd = 2.2,
        col = c(4, 2, 3), xlab = "giorni", ylab = "individui",
        main = "Modello SIR,  R0 = 3")
ip <- which.max(sir[, "I"])
abline(v = sir[ip, "t"], lty = 3, col = "grey50")
abline(h = par_sir$N * par_sir$gamma / par_sir$beta, lty = 2, col = "grey50")
points(sir[ip, "t"], sir[ip, "I"], pch = 19, col = 2)
text(sir[ip, "t"], sir[ip, "I"],
     sprintf(" picco: %.0f infetti al giorno %.0f", sir[ip, "I"], sir[ip, "t"]),
     pos = 4, cex = 0.8)
text(72, par_sir$N*par_sir$gamma/par_sir$beta, "soglia  N/R0", pos = 3,
     cex = 0.78, col = "grey30")
legend("right", c("suscettibili S", "infetti I", "rimossi R"),
       col = c(4, 2, 3), lwd = 2.2, bty = "n")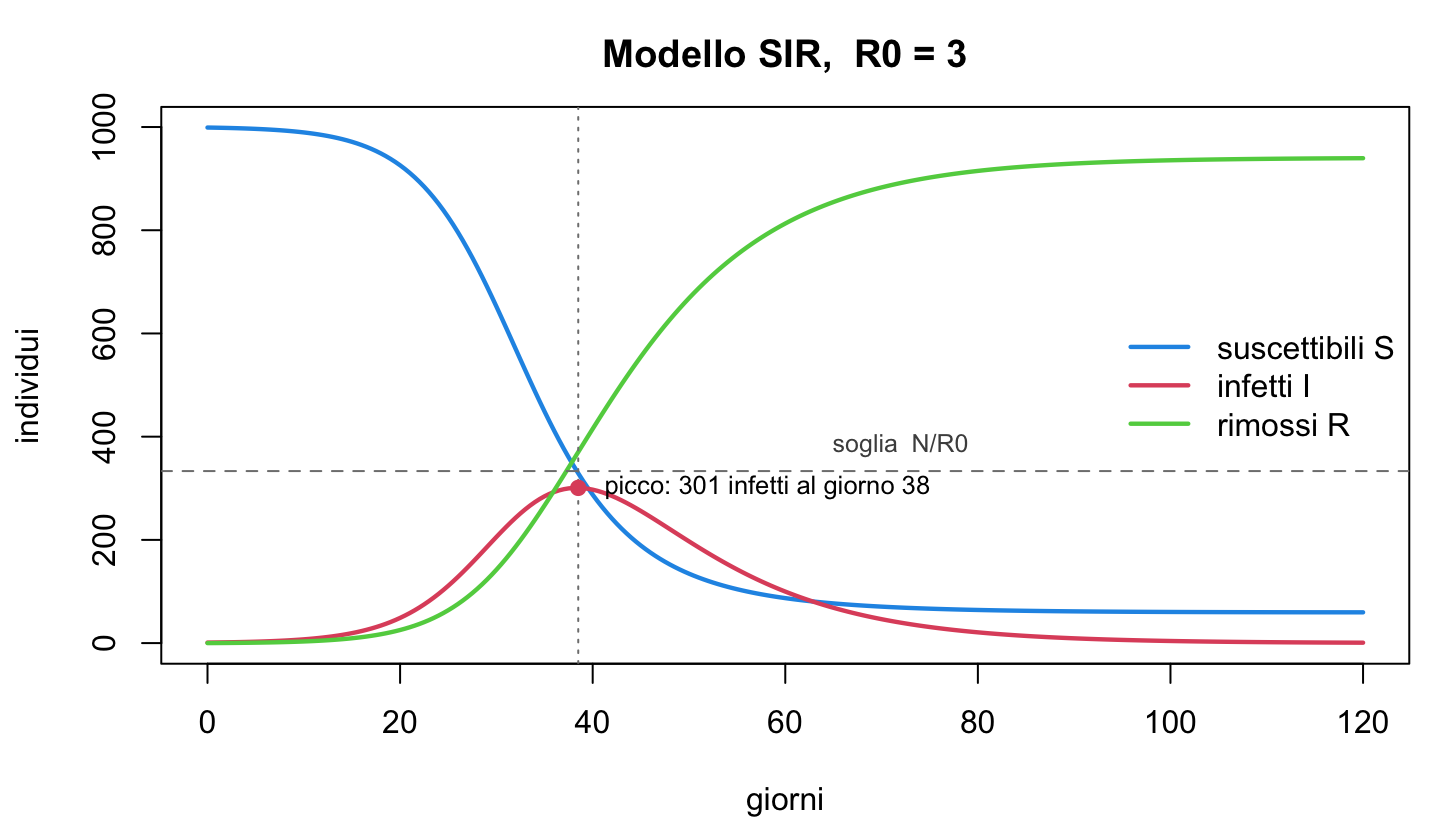
Tre letture del grafico, tutte verificabili sui numeri.
- Il picco degli infetti cade dove la curva S attraversa la soglia N/\mathcal R_0 (linea tratteggiata): è lì che I'=0, perché I'=I\,(\beta S/N-\gamma) cambia segno quando S=\gamma N/\beta.
- L’epidemia si spegne prima di contagiare tutti: la frazione finale R(\infty)/N risolve x=1-e^{-\mathcal R_0 x}, che per \mathcal R_0=3 dà x\simeq0{,}94.
- La somma S+I+R resta pari a N a meno dell’arrotondamento, come garantito sopra.
x_inf <- uniroot(function(x) x - (1 - exp(-3*x)), c(0.1, 0.999))$root
knitr::kable(data.frame(
  grandezza = c("scarto massimo su S+I+R-N", "picco di I",
                "giorno del picco", "R(120)/N calcolato",
                "R(infinito)/N teorico"),
  valore    = sprintf("%.6g",
              c(max(abs(rowSums(sir[, 2:4]) - par_sir$N)),
                max(sir[, "I"]), sir[which.max(sir[, "I"]), "t"],
                sir[nrow(sir), "R"]/par_sir$N, x_inf))),
align = c("l", "r"))| grandezza | valore |
|---|---|
| scarto massimo su S+I+R-N | 2.72848e-12 |
| picco di I | 300.768 |
| giorno del picco | 38.5 |
| R(120)/N calcolato | 0.939588 |
| R(infinito)/N teorico | 0.940481 |
Ordine e costo
Resta da controllare che il metodo abbia davvero l’ordine annunciato anche nel caso vettoriale. Confrontiamo la soluzione a T fissato con una soluzione di riferimento, al variare del passo.
rif_lv  <- deSolve::ode(c(u0, v0), c(0, 20),
             function(t, y, p) list(c(p$alpha*y[1] - p$beta*y[1]*y[2],
                                      p$delta*y[1]*y[2] - p$gamma*y[2])),
             par_lv, atol = 1e-13, rtol = 1e-13)[2, 2:3]
rif_sir <- deSolve::ode(c(999, 1, 0), c(0, 120),
             function(t, y, p) list(c(-p$beta*y[1]*y[2]/p$N,
                                       p$beta*y[1]*y[2]/p$N - p$gamma*y[2],
                                       p$gamma*y[2])),
             par_sir, atol = 1e-13, rtol = 1e-13)[2, 2:4]

ordini <- c(1, 2, 4, 8); cols <- c(1, 2, 4, 3)
h_lv  <- c(0.4, 0.2, 0.1, 0.05, 0.025)
h_sir <- c(4, 2, 1, 0.5, 0.25)
E_lv <- sapply(ordini, function(p) sapply(h_lv, function(hh) {
  S <- lv_taylor(u0, v0, hh, round(20/hh), p, par_lv)
  max(abs(S[nrow(S), 2:3] - rif_lv)) }))
E_sir <- sapply(ordini, function(p) sapply(h_sir, function(hh) {
  S <- sir_taylor(c(999, 1, 0), hh, round(120/hh), p, par_sir)
  max(abs(S[nrow(S), 2:4] - rif_sir)) }))

op <- par(mfrow = c(1, 2), mar = c(4.2, 4.4, 2.8, 0.8))
for (k in 1:2) {
  H <- if (k == 1) h_lv else h_sir
  E <- if (k == 1) E_lv else E_sir
  E[E < 1e-14] <- NA
  matplot(H, E, type = "b", pch = 16, lty = 1, lwd = 2, col = cols, log = "xy",
          xlab = "passo h", ylab = "errore finale",
          main = if (k == 1) "Preda-predatore (T=20)" else "SIR (T=120)")
  for (j in seq_along(ordini))
    lines(H, E[1, j] * (H/H[1])^ordini[j], lty = 3, col = cols[j])
  legend("bottomright", paste0("p = ", ordini), col = cols, lwd = 2,
         pch = 16, bty = "n", cex = 0.8)
}
par(op)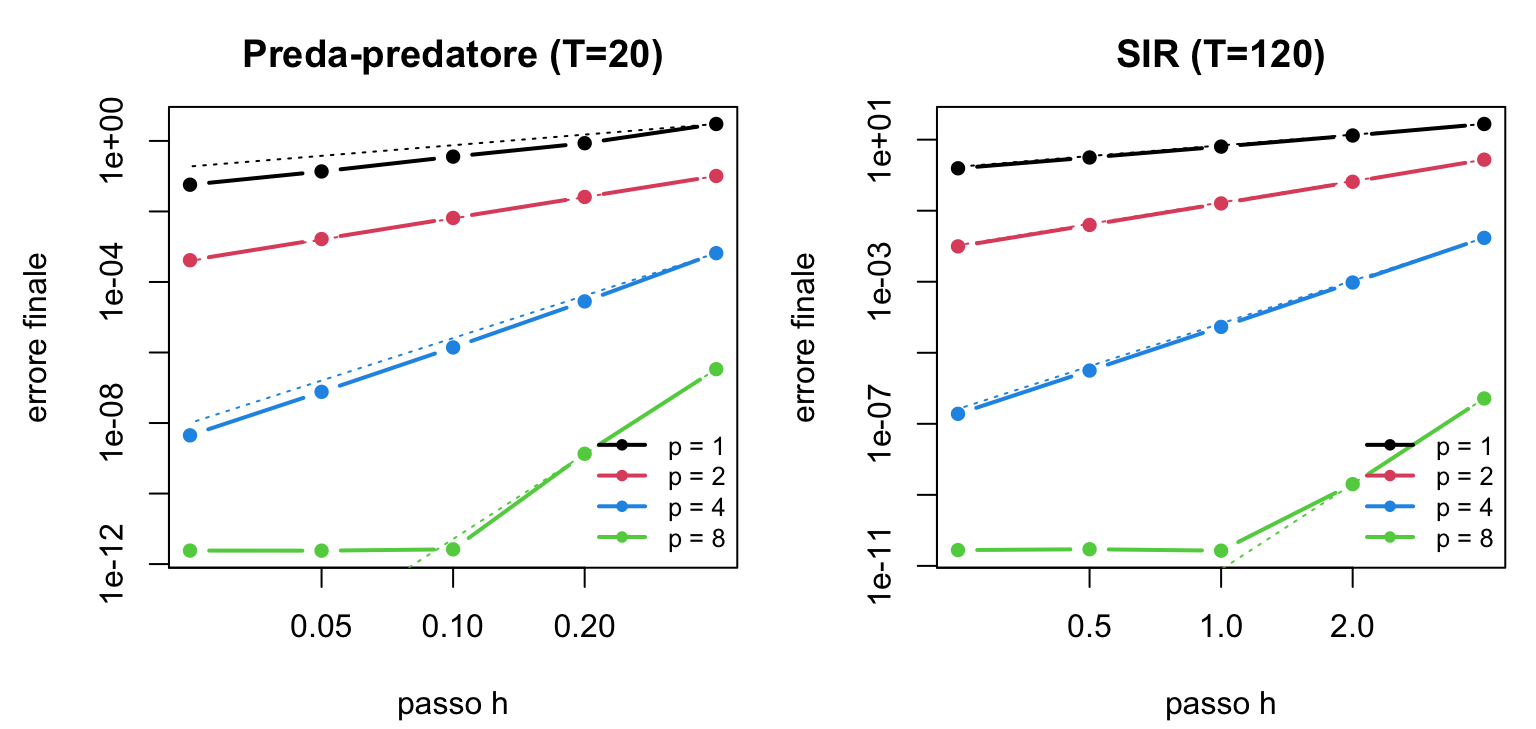
Il costo di un passo è \mathcal O(p^2m) operazioni: la somma di convoluzione di 29.10 costa \mathcal O(k) al passo k, e si somma su k=0,\ldots,p-1. Confrontato con un Runge–Kutta di pari ordine, che richiede un numero di valutazioni di \mathbf f che cresce più che linearmente in p, il metodo di Taylor è competitivo proprio quando p è alto e il secondo membro è polinomiale — e allora permette ordini, 20 o 30, che con Runge–Kutta non sono praticabili. Il limite resta quello di sempre: serve conoscere la forma analitica di \mathbf f e saperne propagare i coefficienti, cosa che per un secondo membro generico richiede differenziazione automatica.
In sintesi
- Derivando ripetutamente la ODE si esprimono y'', y''', … in funzione di f e delle sue derivate parziali: nasce così il metodo di Taylor di ordine p.
- Il metodo raggiunge qualunque ordine con un solo punto, ma richiede le derivate di f: è pratico solo con derivazione simbolica o automatica.
- La notazione compatta D_k(t,y) organizza la ricorsione e rende il metodo implementabile per p arbitrario.
- È il confronto che motiva i metodi di Runge-Kutta: stesso ordine, nessuna derivata, al prezzo di più valutazioni di f per passo.
- Per i sistemi la costruzione è identica: \partial f/\partial y diventa la matrice Jacobiana e il prodotto diventa matrice–vettore (29.6).
- In pratica non si costruiscono le D_k: si propagano i coefficienti di Taylor con 29.9 e la regola di Leibniz 29.10. Per secondi membri polinomiali — come preda–predatore e SIR — bastano poche righe di codice e si raggiunge qualunque ordine, con costo \mathcal O(p^2m) per passo.
- Conviene controllare se il metodo preserva le quantità conservate del modello: il SIR mantiene S+I+R=N esattamente a ogni ordine, mentre l’invariante di Lotka–Volterra viene conservato solo tanto meglio quanto più alto è l’ordine.