University of Trento, Department of Industrial Engineering
In molte applicazioni si presenta il problema di trovare una soluzione x tale che:
f(x) = 0,
dove f: \mathbb{R} \to \mathbb{R} è una funzione continua. Un numero reale \alpha che soddisfa f(\alpha) = 0 si chiama radice della funzione. Se f(x) è lineare, ossia ha la forma:
f(x) = a x + b,
dove a \neq 0 e b sono costanti assegnate, la radice si calcola facilmente come \alpha = -b/a.
Se invece f(x) è non lineare, per esempio:
f(x) = a x^{n} - b,
e se a e b hanno lo stesso segno oppure n è dispari, si può determinare una radice reale ponendo \alpha = \sqrt[n]{b/a}. Nei problemi pratici, tuttavia, la funzione f(x) è spesso non lineare e non è disponibile una formula esplicita per determinarne facilmente una radice. In questi casi occorre ricorrere a metodi numerici per approssimarla.
20.1 Classificazione dei metodi
I metodi numerici per approssimare le soluzioni di f(x)=0 si suddividono in tre famiglie, che corrispondono all’organizzazione di questo capitolo e del successivo.
Metodi con intervallo di confinamento (bracketing). Mantengono a ogni passo un intervallo [a_k,b_k] tale che f(a_k)f(b_k)\le 0 e che, per il teorema degli zeri, contiene una radice. Appartengono a questa famiglia il metodo di bisezione (o dicotomia, Sezione 20.3) e la regula falsi (Sezione 20.8). La convergenza è garantita, ma in generale è lenta.
Metodi aperti locali. Generano una successione x_0,x_1,x_2,\ldots sostituendo localmente f con un modello semplice (una retta tangente, una secante o una parabola) e assumendo come iterata successiva uno zero del modello. Appartengono a questa famiglia il metodo di Newton1-Raphson2 (Sezione 20.6), il metodo delle secanti (Sezione 20.7), il metodo delle corde (Sezione 20.9), il metodo di Müller (Sezione 20.10), la parabola tangente (Sezione 20.11) e il metodo di Halley (Sezione 20.12). Alla stessa famiglia appartengono anche le iterazioni di punto fisso (Capitolo 23). La convergenza locale è rapida, ma non è garantita globalmente.
Metodi ibridi con salvaguardia. Propongono a ogni passo il candidato di un metodo aperto e lo accettano solo se supera i test di ammissibilità; in caso contrario, ricorrono a un passo di bisezione. Combinano così la rapidità dei metodi aperti con la garanzia dei metodi di confinamento. Sono trattati nel capitolo sui metodi ibridi.
In alcuni casi particolari, come nel caso di polinomi, esistono tecniche speciali che non rientrano nelle famiglie sopra descritte (Capitolo 24).
AvvisoAvvertenza terminologica
In letteratura il nome metodo delle corde è usato con due significati diversi: in alcuni testi indica la regula falsi, in altri il metodo di Newton con derivata congelata. In questi appunti il nome è riservato alla seconda costruzione (Sezione 20.9), mentre la prima è sempre chiamata regula falsi o metodo delle false posizioni.
20.2 Notazione
Per tutto il capitolo adottiamo le seguenti convenzioni uniformi:
Notazione usata nel capitolo
Simbolo
Significato
\alpha
la radice cercata, f(\alpha)=0
x_k
iterata k-esima; l’indice di iterazione è sempre k
raggio dell’intorno di \alpha in cui vale la convergenza locale
M_j = \sup \left\lvert f^{(j)}\right\rvert
estremo superiore della derivata j-esima sull’intervallo considerato
\varepsilon_{\rm mach}
precisione di macchina (2^{-52}\approx2.22\cdot10^{-16} in doppia precisione)
I[a,b,c,\ldots]
il più piccolo intervallo chiuso contenente a,b,c,\ldots
20.3 Metodo di bisezione (o dicotomico)
Il metodo di bisezione è una semplice applicazione del seguente teorema, che enunciamo senza dimostrazione.
Teorema 20.1 (Teorema: esistenza di uno zero per cambio di segno) Sia f:[a,b] \to \mathbb{R} una funzione continua su [a,b] e tale che f(a)f(b) < 0. Allora esiste almeno un punto \alpha \in (a,b) tale che f(\alpha) = 0.
Se f(x) è continua e a_0 e b_0 sono due punti tali che f(a_0)f(b_0) < 0, significa che f(a_0) e f(b_0) hanno segno opposto. Il Teorema 20.1 garantisce l’esistenza di almeno una radice \alpha nell’intervallo (a_0, b_0).
Ora consideriamo il punto medio dell’intervallo:
c_0 = \dfrac{a_0 + b_0}{2}.
Si possono verificare solo tre possibili situazioni:
Caso 1:f(c_0) = 0; in tal caso, c_0 è una radice esatta.
Caso 2:f(c_0)f(a_0) < 0; in questo caso, esiste almeno una radice nell’intervallo (a_0, c_0).
Caso 3:f(c_0)f(b_0) < 0; in questo caso, esiste almeno una radice nell’intervallo (c_0, b_0).
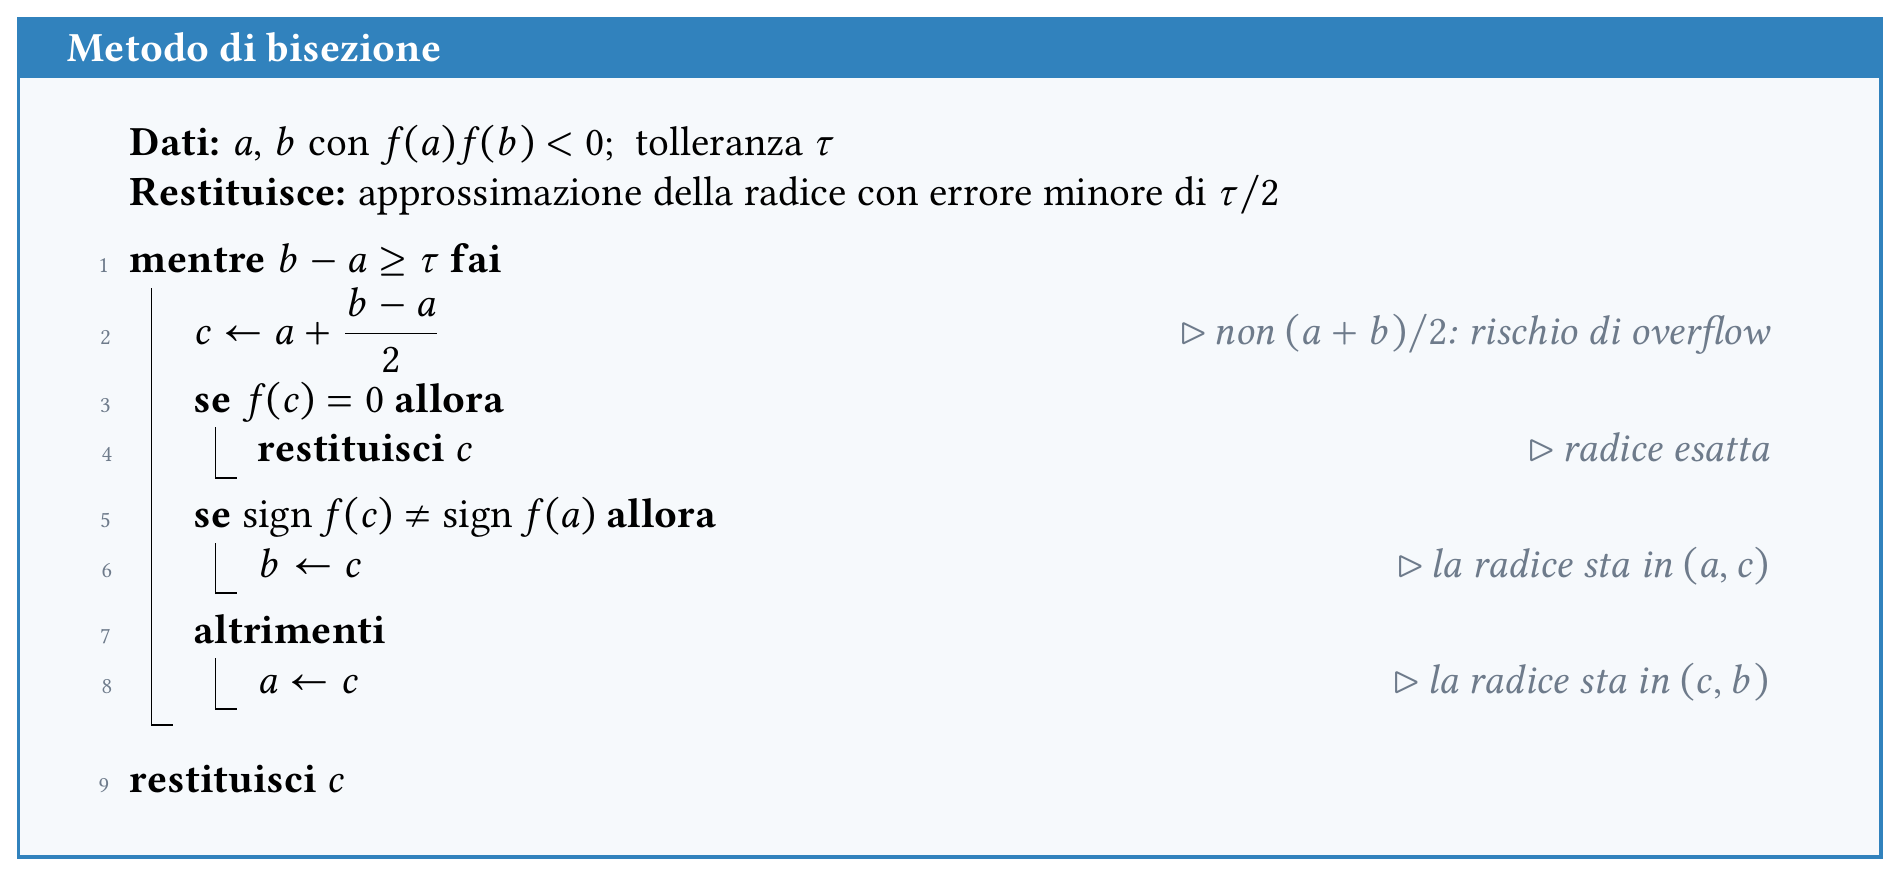
Escludendo il primo caso in cui la radice è già stata trovata, è sempre possibile ridurre l’intervallo di ricerca dimezzandolo. Ripetendo questo procedimento, il metodo dicotomico consente, data una tolleranza \tau, di trovare un intervallo di lunghezza inferiore a \tau che contiene una radice.
L’algoritmo può essere descritto come segue:
ConsiglioDue dettagli di implementazione
Il punto medio va calcolato come a_k+(b_k-a_k)/2 e non come (a_k+b_k)/2: la seconda forma può produrre overflow quando a_k e b_k sono grandi, e per estremi di segno concorde non è garantito che il risultato cada nell’intervallo.
Il test di cambio di segno va fatto confrontando i segni, non calcolando il prodotto f(c)f(a_k): il prodotto di due numeri piccoli può andare in underflow a zero (facendo credere di aver trovato una radice esatta) e quello di due numeri grandi in overflow.
È possibile calcolare il numero minimo di passi necessari per approssimare una radice con l’accuratezza desiderata. Consideriamo che, ad ogni iterazione, la lunghezza dell’intervallo si dimezza. Dunque, per l’intervallo all’iterazione k abbiamo:
fornisce il numero minimo di iterazioni necessarie per garantire che l’ampiezza dell’intervallo sia minore di \tau. Poiché come approssimazione si assume il punto medio, l’errore commesso è allora minore di \tau/2. Si noti che questo numero non dipende da f: è il principale pregio del metodo, insieme al fatto che l’errore è maggiorato in modo rigoroso a ogni passo.
In termini di velocità di convergenza (Sezione 21.1) la bisezione è R-lineare con fattore 1/2: ogni iterazione guadagna esattamente un bit di accuratezza, quindi servono circa 3.3 iterazioni per ogni cifra decimale e circa 52 iterazioni per esaurire la doppia precisione.
20.4 Criteri di arresto e accuratezza raggiungibile
Prima di introdurre metodi più rapidi è bene chiarire fino a dove ha senso spingersi. In aritmetica finita la funzione non viene valutata esattamente: il valore calcolato è
dove \epsilon_f raccoglie gli errori di arrotondamento commessi nella valutazione. Una stima realistica è \epsilon_f \approx \varepsilon_{\rm mach}\,\mu(x), dove \mu(x) è l’ordine di grandezza dei termini intermedi del calcolo, che può essere molto maggiore di \left\lvert f(x)\right\rvert in presenza di cancellazione.
Intervallo di incertezza e condizionamento della radice
Tutti i punti x per cui \left\lvert f(x)\right\rvert\leq\epsilon_f sono indistinguibili da radici: nessun algoritmo che usi solo i valori calcolati di f può separarli. Se \alpha è una radice semplice, sviluppando f(x)\approx f'(\alpha)(x-\alpha) si ottiene che l’intervallo di incertezza ha semiampiezza
La quantità 1/\left\lvert f'(\alpha)\right\rvert è dunque il numero di condizionamento della radice: una radice con derivata piccola è intrinsecamente mal determinata, indipendentemente dal metodo usato.
Se invece \alpha ha molteplicità m, il primo termine non nullo dello sviluppo è f^{(m)}(\alpha)(x-\alpha)^m/m! e si ottiene
cioè un intervallo di incertezza di ampiezza O(\epsilon_f^{1/m}): per una radice doppia in doppia precisione si arriva a circa 10^{-8}, per una tripla a circa 10^{-5}. Nessun metodo può fare meglio.
NotaEsempio: la radice tripla di (x-1)^3
Valutiamo il polinomio p(x)=(x-1)^3 nella sua forma espansa x^3-3x^2+3x-1 in un intorno di x=1. Il valore calcolato è puro rumore di arrotondamento e il segno è erratico.
p_espanso <-function(x) x^3-3*x^2+3*x -1x <-1+ (-8:8)*1e-6data.frame(delta = x -1, p =p_espanso(x), segno =sign(p_espanso(x)))
I termini intermedi sono di ordine 3, quindi \epsilon_f\approx3\varepsilon_{\rm mach}\approx6.7\cdot10^{-16} e la 20.2 con m=3, f'''=6 prevede un’incertezza di circa (6.7\cdot10^{-16})^{1/3}\approx 8.8\cdot10^{-6}: esattamente l’ampiezza della zona di rumore osservata.
Criteri pratici
Alla luce di quanto sopra, i criteri d’arresto usati in pratica sono i seguenti.
Test sull’incremento (misto assoluto/relativo). Si arresta quando
\left\lvert x_{k+1}-x_k\right\rvert \leq \tau_r \left\lvert x_{k+1}\right\rvert + \tau_a .
È il criterio più usato per i metodi aperti; è affidabile quando la convergenza è almeno lineare con fattore nettamente minore di 1, perché in tal caso \left\lvert x_{k+1}-x_k\right\rvert è una buona stima di \left\lvert e_k\right\rvert. Non lo è per convergenza lenta: con fattore 1-1/m l’incremento sottostima l’errore di un fattore m.
Test sul residuo. Si arresta quando \left\lvert f(x_k)\right\rvert\leq\epsilon_f. Dipende dalla scala di f (moltiplicare f per 10^{6} cambia il risultato) e, per la 20.1, si attiva lontano dalla radice quando \left\lvert f'(\alpha)\right\rvert è piccolo. Usato da solo è il criterio peggiore; è però l’unico utilizzabile quando si vuole una garanzia sul residuo e non sull’argomento.
Test sull’ampiezza del bracket. Per i metodi di confinamento si arresta quando
b_k-a_k \leq 2\varepsilon_{\rm mach}\left\lvert b_k\right\rvert + \tau_a ,
che è la forma usata nelle implementazioni di tipo zeroin. È l’unico criterio che fornisce una maggiorazione rigorosa dell’errore, perché la radice è certamente nell’intervallo.
Limite sul numero di iterazioni. In ogni caso va imposto un numero massimo di iterazioni: un metodo aperto può non convergere affatto (Sezione 20.6.4).
Una buona implementazione combina i primi due test in or con il limite sulle iterazioni, e per i metodi con bracket usa il terzo.
20.5 Dalla bisezione ai metodi aperti
La bisezione conserva un intervallo con cambio di segno e garantisce la riduzione della sua ampiezza. I metodi aperti sostituiscono invece localmente f con un modello semplice: una retta tangente, una secante o una parabola. La rapidità locale può migliorare di molto, ma senza salvaguardie non è garantita la convergenza globale.
20.6 Metodo di Newton-Raphson
Derivazione e interpretazione geometrica
Sia f : [a,b] \to \mathbb{R} continua e differenziabile e sia x_k l’approssimazione corrente della radice. Ponendo s=x_{k+1}-x_k, lo sviluppo di Taylor al primo ordine fornisce
f(x_k+s)=f(x_k)+f'(x_k)s+O(s^2).
Trascurando il resto e imponendo lo zero del modello lineare, f(x_k)+f'(x_k)s=0, si ottiene s=-f(x_k)/f'(x_k) e quindi lo schema iterativo
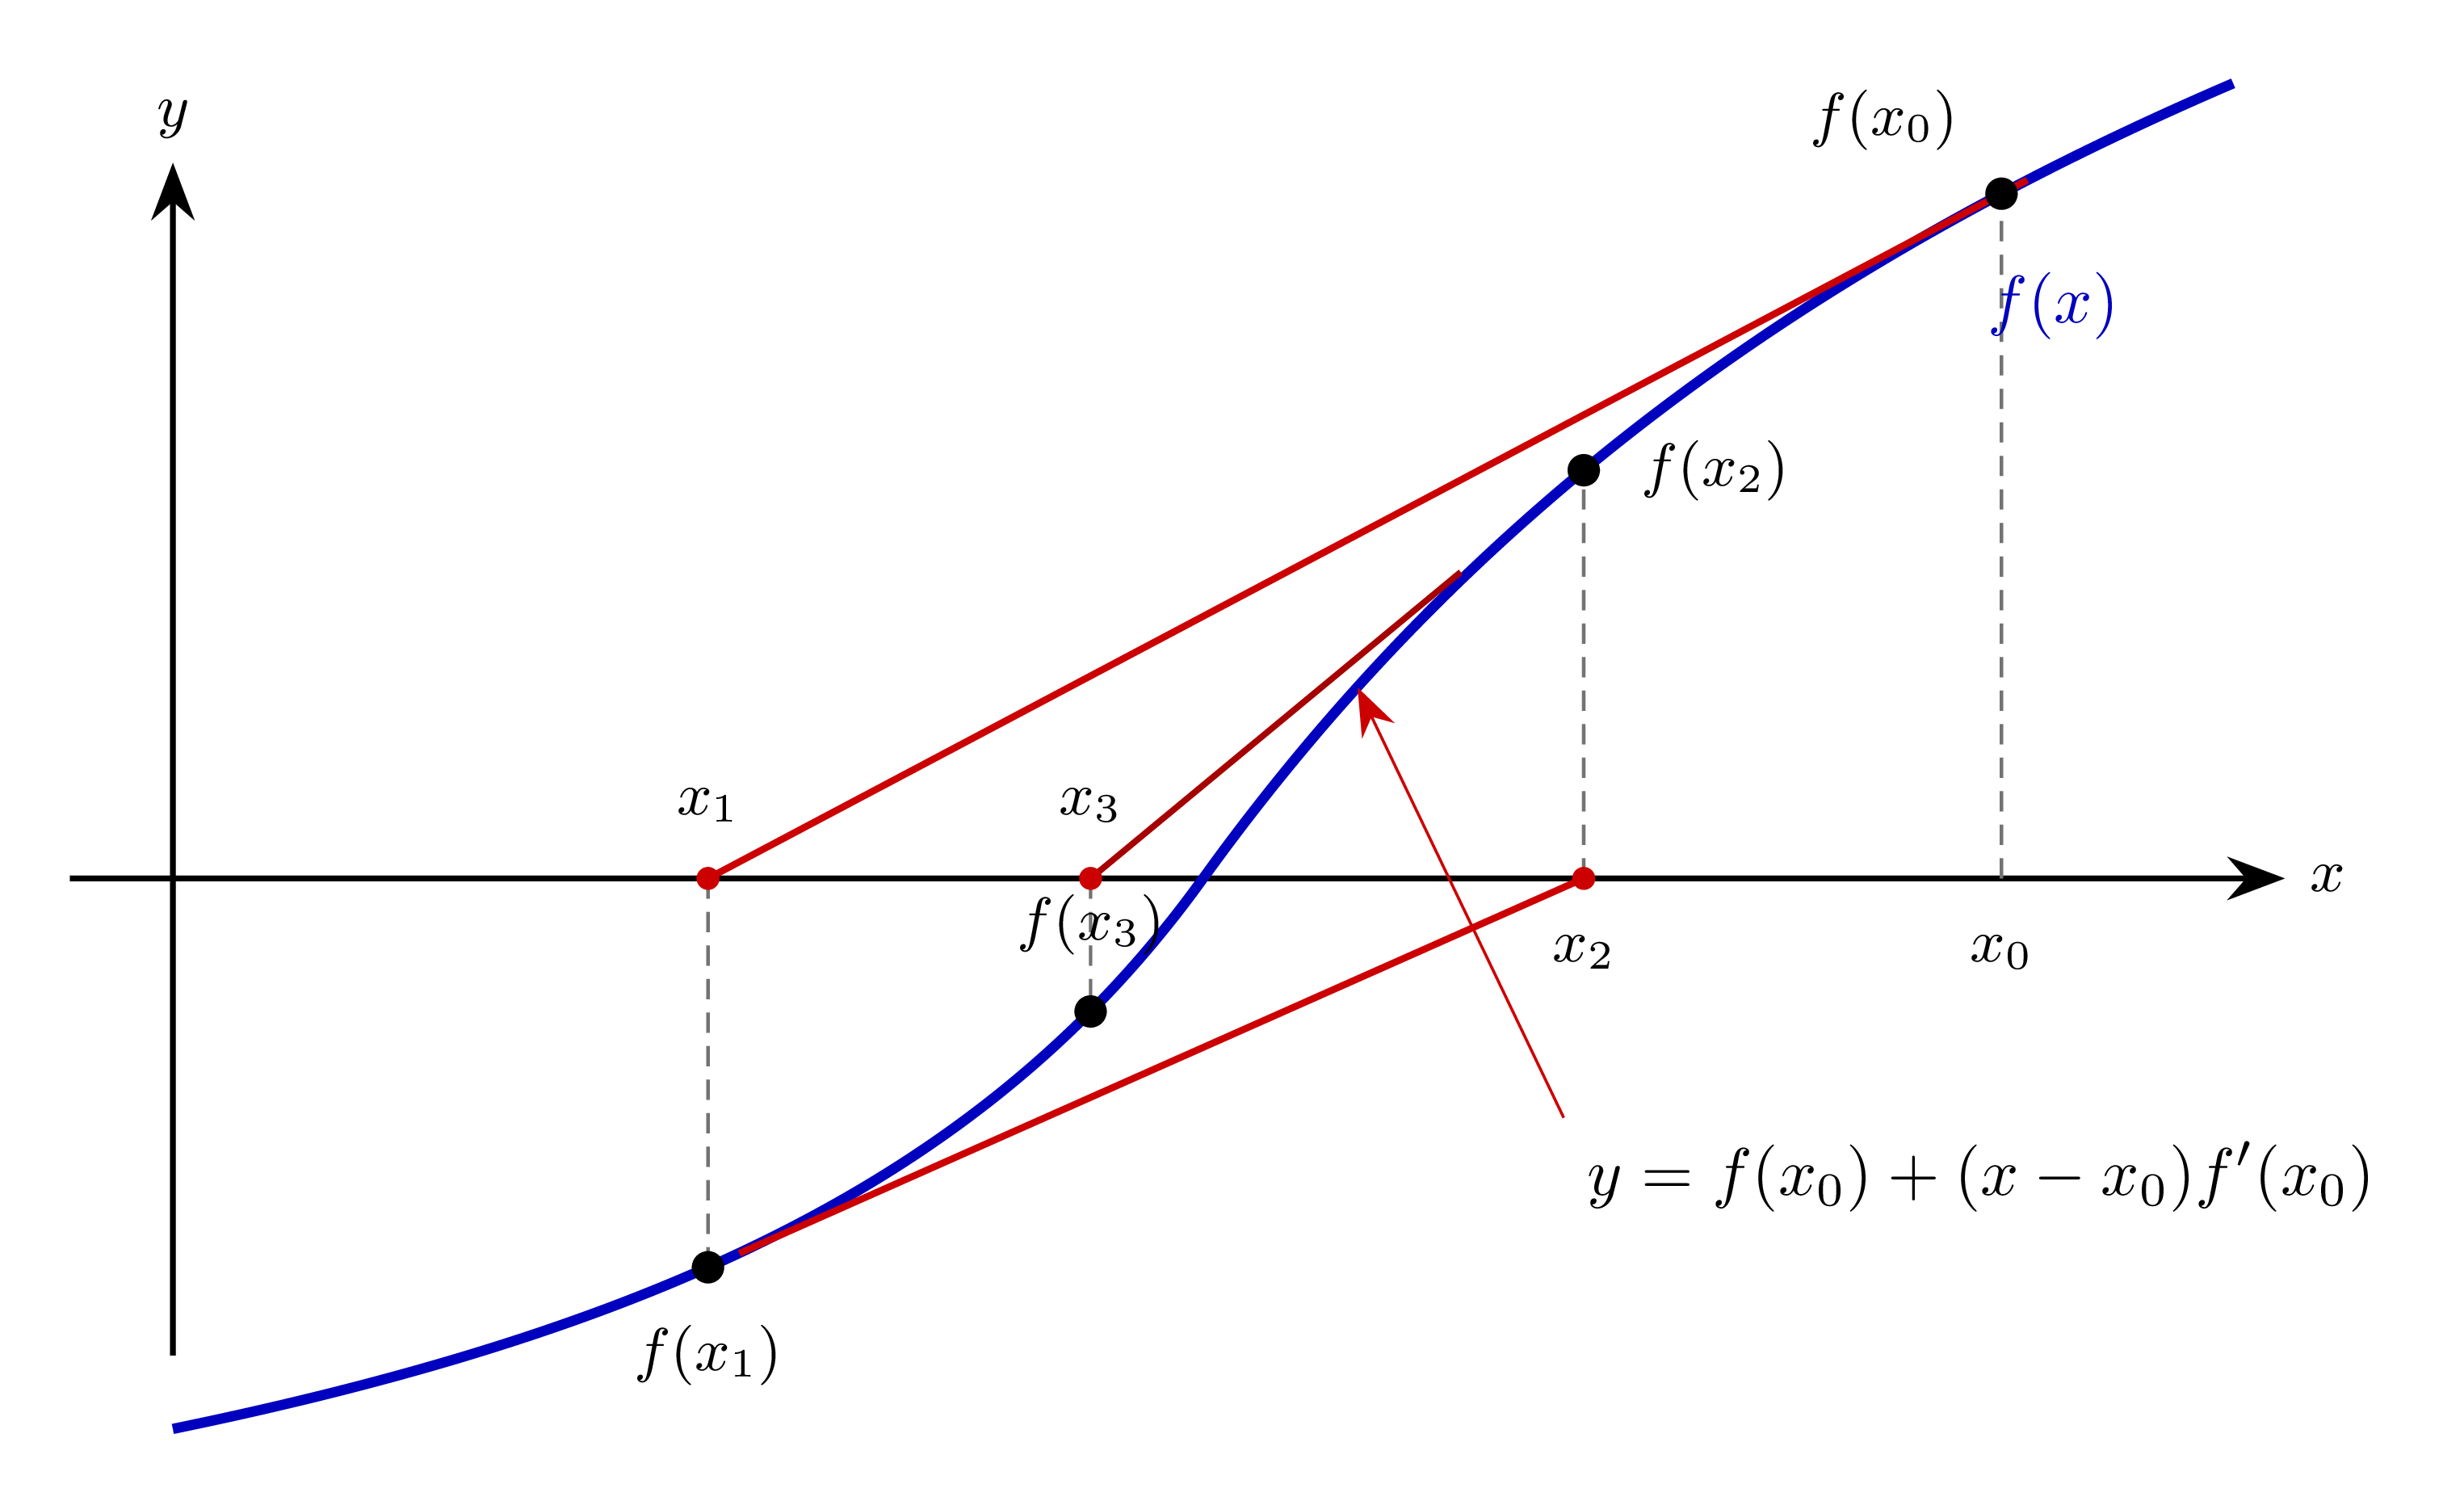
La stessa formula ha una lettura geometrica immediata: il modello lineare non è altro che la retta tangente al grafico di f nel punto (x_k,f(x_k)),
y = f(x_k) + (x - x_k) f'(x_k),
\tag{20.4}
e x_{k+1} è l’ascissa in cui tale tangente incontra l’asse x (Figura 20.1). Ogni iterazione sostituisce dunque la curva con la sua tangente e assume come nuova stima lo zero della tangente.
Figura 20.1: Costruzione grafica del metodo di Newton-Raphson
Lo schema richiede f'(x_k)\neq0 e un punto iniziale adeguato: una derivata piccola produce passi molto grandi e può far divergere il procedimento (Sezione 20.6.4). Il costo è di due valutazioni per iterazione (f e f').
Convergenza locale
Teorema 20.2 (Teorema: convergenza del metodo di Newton per radici semplici) Sia f \in C^2([a,b]) e \alpha una radice semplice di f(x), cioè tale che f'(\alpha) \neq 0. Allora esiste \rho>0 tale che, se x_0 \in (\alpha - \rho, \alpha + \rho), la successione generata dal metodo di Newton-Raphson 20.3 soddisfa:
x_k \in (\alpha - \rho, \alpha + \rho) per k = 1, 2, 3, \ldots;
la convergenza è quadratica, ossia \left\lvert e_{k+1}\right\rvert \leq C \left\lvert e_k\right\rvert^2 per k = 0, 1, 2, \ldots, dove C è una costante positiva.
Dimostrazione. Consideriamo lo sviluppo di f(x) attorno a x_k, valutato nella radice \alpha, tramite la serie di Taylor3:
Poiché \alpha è una radice semplice e f' è continua, esiste \rho>0 tale che 2 \left\lvert f'(x)\right\rvert > \left\lvert f'(\alpha)\right\rvert per ogni x \in (\alpha - \rho, \alpha + \rho). Posto
C = \dfrac{M_2}{\left\lvert f'(\alpha)\right\rvert},
si ha dunque
\left\lvert e_{k+1}\right\rvert \leq C \left\lvert e_k\right\rvert^2 .
\tag{20.7}
Riducendo eventualmente \rho possiamo supporre C\rho < 1: infatti M_2, e quindi C, non cresce al diminuire di \rho, mentre il prodotto C\rho tende a zero. Allora, se x_k \in (\alpha - \rho, \alpha + \rho),
cosicché anche x_{k+1} appartiene all’intorno. Per induzione la successione \{x_k\} vi rimane e, poiché l’errore è ridotto a ogni passo almeno del fattore C\rho < 1, converge ad \alpha. La 20.7 mostra infine che la convergenza è quadratica.
Dalla 20.6 si ricava anche la costante asintotica esatta:
che si annulla se f''(\alpha)=0: in tal caso la convergenza è addirittura cubica. Accade quando la radice coincide con un punto di flesso, come per f(x)=\sin x o f(x)=\arctan x con \alpha=0, oppure per f(x)=x^3+x.
Convergenza globale per funzioni convesse
La convergenza del Teorema 20.2 è soltanto locale. Esiste però una classe di problemi in cui la convergenza è garantita a partire da un estremo dell’intervallo: è la classica condizione di Fourier.
Teorema 20.3 (Teorema: convergenza monotona di Newton per funzioni convesse) Sia f \in C^2([a,b]) con f(a)<0<f(b), f'(x)>0 e f''(x)\ge0 per ogni x\in[a,b]. Allora f ha un’unica radice \alpha\in(a,b) e la successione di Newton generata da x_0=b è monotona decrescente, rimane in [\alpha,b] e converge ad \alpha.
Dimostrazione. L’unicità segue dalla stretta monotonia di f. Per la convessità, il grafico di f sta sopra ogni sua tangente:
f(x) \ge f(x_k) + f'(x_k)(x-x_k), \qquad \forall x \in [a,b].
Procediamo per induzione supponendo f(x_k)\ge0, vero per k=0 essendo x_0=b. Valutando la disuguaglianza in x=x_{k+1}, e osservando che per costruzione il membro destro si annulla proprio in x_{k+1}, si ottiene f(x_{k+1})\ge0; poiché f è crescente e f(\alpha)=0, ciò implica x_{k+1}\ge\alpha. Inoltre
x_{k+1}-x_k = -\dfrac{f(x_k)}{f'(x_k)} \le 0,
perché f(x_k)\ge0 e f'(x_k)>0. La successione è dunque decrescente e limitata inferiormente da \alpha, quindi converge a un limite \mu\ge\alpha. Passando al limite nello schema si ottiene f(\mu)/f'(\mu)=0, cioè f(\mu)=0 e quindi \mu=\alpha.
In pratica la condizione si riassume così: si parte dall’estremo in cui f e f'' hanno lo stesso segno. Le altre tre combinazioni di segni di f' e f'' si riconducono a questa cambiando x in -x oppure f in -f. Si noti la simmetria con la dimostrazione della convergenza della regula falsi (Teorema 20.5), che usa la stessa ipotesi di convessità per ottenere una successione monotona crescente dall’altro estremo: sotto le ipotesi di Fourier, Newton e regula falsi partendo dai due estremi stringono la radice da entrambi i lati, fornendo un bracket a costo nullo.
Quando Newton fallisce
Fuori dall’intorno di convergenza il metodo può comportarsi in modo arbitrariamente cattivo. I modi di fallimento tipici sono quattro.
1. Derivata quasi nulla. Se f'(x_k)\approx0 il passo -f(x_k)/f'(x_k) è enorme e l’iterata viene proiettata lontanissimo dalla radice, spesso fuori dal dominio di definizione di f.
2. Ciclo. Per f(x)=\arctan x, con radice \alpha=0, lo schema è x_{k+1}=x_k-(1+x_k^2)\arctan x_k. Esiste un valore critico x^\ast\approx1.3917452002707 per cui x_1=-x_0: il metodo entra in un ciclo di periodo due e non converge mai.
3. Divergenza. Per \left\lvert x_0\right\rvert>x^\ast nell’esempio precedente le iterate divergono con oscillazioni di ampiezza crescente. Un caso ancora più netto è f(x)=\mathrm{sign}(x)\left\lvert x\right\rvert^{1/3}, che ha la sola radice \alpha=0 e per cui f(x)/f'(x)=3x, cioè x_{k+1}=-2x_k: il metodo diverge per qualunquex_0\neq0.
4. Radice multipla. La convergenza degrada da quadratica a lineare con fattore 1-1/m (cfr. Sezione 21.3).
I primi tre modi di fallimento sono ripresi e analizzati in dettaglio in Tre patologie del metodo di Newton, dove si vede che ciclo e divergenza sono due casi della stessa famiglia.
newton_arctan <-function(x0, n =6) { x <- x0for (k in1:n) x <-c(x, x[k] -atan(x[k])*(1+ x[k]^2)) x}rbind(`x0 = 1.0 (converge)`=newton_arctan(1.0),`x0 = 1.3917452 (ciclo)`=newton_arctan(1.3917452002707),`x0 = 1.5 (diverge)`=newton_arctan(1.5))
Il rimedio non è scegliere meglio il punto iniziale — cosa in generale impossibile — ma imporre una salvaguardia: o mantenendo un bracket e rifiutando i passi che ne escono (metodi ibridi, cfr. il capitolo successivo), oppure accorciando il passo (damping) finché \left\lvert f\right\rvert non diminuisce.
20.7 Metodo delle secanti
Il difetto del metodo di Newton è la necessità di f'. Sostituendo la derivata con il rapporto incrementale costruito sulle ultime due iterate,
si ottiene il metodo delle secanti: geometricamente, la nuova iterata è lo zero della retta secante per (x_{k-1},f(x_{k-1})) e (x_k,f(x_k)) anziché della tangente. Lo schema si scrive nella forma
A differenza della regula falsi (Sezione 20.8), che usa anch’essa una secante ma ne sceglie gli estremi in modo da conservare il cambio di segno, qui si usano sempre le ultime due iterate, qualunque sia il segno di f in esse. Si guadagna in velocità e si risparmia il controllo dei segni, ma si perde la garanzia di convergenza.
Il costo è di una sola valutazione di f per iterazione (il valore f(x_{k-1}) è già disponibile) e nessuna valutazione di derivate: è questa la ragione per cui, a parità di valutazioni, le secanti sono competitive con Newton (Sezione 21.1).
Due avvertenze pratiche:
quando si raggiunge la convergenza si ha f(x_{k}) \approx f(x_{k-1}), e il denominatore della 20.8 è soggetto a cancellazione numerica. Nella regula falsi questo non si verifica, poiché è garantito che f(x_{k}) f(a_k) < 0;
la forma 20.8 è la più compatta, ma vicino alla radice il suo numeratore è la differenza di due prodotti quasi uguali. Conviene allora usare la forma incrementale equivalente
x_{k+1}=x_k-f(x_k)\dfrac{x_k-x_{k-1}}{f(x_k)-f(x_{k-1})},
che calcola una piccola correzione da sommare a x_k anziché ricostruire da zero un numero di ordine \alpha: è la forma usata in tutte le implementazioni.
Convergenza locale
Se x_{k} non è sufficientemente vicino alla radice, non è garantito che il metodo converga. Esaminiamo dunque la convergenza locale dello schema. Sia \alpha una radice di f(x). Sottraendo \alpha da entrambi i membri della 20.8 otteniamo:
dove nell’ultimo passaggio si è applicato il teorema di Lagrange a f' sull’intervallo di estremi \alpha - \theta k e \alpha + \theta h.
Ponendo h=x_{k}-\alpha e k'=\alpha-x_{k-1} nel Lemma 20.1, per cui \alpha+h = x_k, \alpha-k' = x_{k-1}, -k' = x_{k-1}-\alpha e h+k' = x_k - x_{k-1}, otteniamo
del tutto analoga alla 20.6 di Newton, con e_k^2 sostituito da e_ke_{k-1}. Questa relazione permette di dimostrare il seguente teorema.
Teorema 20.4 (Teorema: convergenza del metodo delle secanti) Se \alpha è uno zero semplice di f \in C^{2}([a,b]) (cioè f'(\alpha) \neq 0), allora esiste un intervallo J = (\alpha - \rho, \alpha + \rho) tale che, per ogni scelta di x_0, x_1 \in J, il metodo delle secanti converge. Inoltre, si ha:
\left\lvert e_{k}\right\rvert \leq C q^{p^{k}}, \quad 0 < q < 1, \quad p = \dfrac{1 + \sqrt{5}}{2} \approx 1.618034,
cioè la convergenza è R-convergente di ordine p (il rapporto aureo).
Dimostrazione. Poiché \alpha è uno zero semplice e f'(x) è continua, esiste \rho > 0 tale che:
e, per la continuità di f'', esiste M_2 con \left\lvert f''(x)\right\rvert \leq M_2 sullo stesso intorno.
Definiamo J = (\alpha - \rho, \alpha + \rho) e poniamo M = \dfrac{M_2}{\left\lvert f'(\alpha)\right\rvert}. Allora, per ogni \eta,\zeta \in J:
\left\lvert\dfrac{1}{2} \dfrac{f''(\zeta)}{f'(\eta)}\right\rvert \leq \left\lvert\dfrac{f''(\zeta)}{f'(\alpha)}\right\rvert \leq M.
Supponendo che \rho M < 1 (altrimenti basta ridurre \rho), otteniamo che x_{k} \in J per ogni k. Infatti, dalla relazione 20.12 segue
\left\lvert e_{k+1}\right\rvert \leq \left\lvert e_{k}\right\rvert \left\lvert e_{k-1}\right\rvert M \leq \rho^{2} M < \rho, \quad \implies \quad x_{k+1} \in J.
Definiamo \epsilon_{k} = M \left\lvert e_{k}\right\rvert; moltiplicando per M la relazione precedente otteniamo la ricorrenza
\epsilon_{k+1} \leq \epsilon_{k} \epsilon_{k-1}.
Poniamo E_{0} \geq \epsilon_{0}, E_{1} \geq \epsilon_{1} e E_{k+1} = E_{k} E_{k-1}. Allora \epsilon_{k} \leq E_{k} per ogni k: infatti, se ciò vale fino a k,
Il secondo ramo richiede una valutazione aggiuntiva di f. Per f\in C^2, la differenza in avanti ha errore di troncamento O(h); in aritmetica floating point il contributo dell’arrotondamento cresce come O(\varepsilon_{\rm mach}/h), e il bilanciamento dei due contributi porta alla scelta pratica h\approx\sqrt{\varepsilon_{\rm mach}}\max(1,|x_k|), adattata alla scala del problema. Se D_k è nullo o troppo piccolo, occorre una salvaguardia. Questa variante non conserva automaticamente l’ordine superlineare della secante quando h resta fisso.
20.8 Metodo delle false posizioni (regula falsi)
Sia data una funzione f:[a,b] \to \mathbb{R} continua nell’intervallo [a,b] e tale che f(a)f(b) < 0. In queste condizioni, il Teorema 20.1 garantisce che esiste almeno uno zero di f(x) nell’intervallo [a,b].
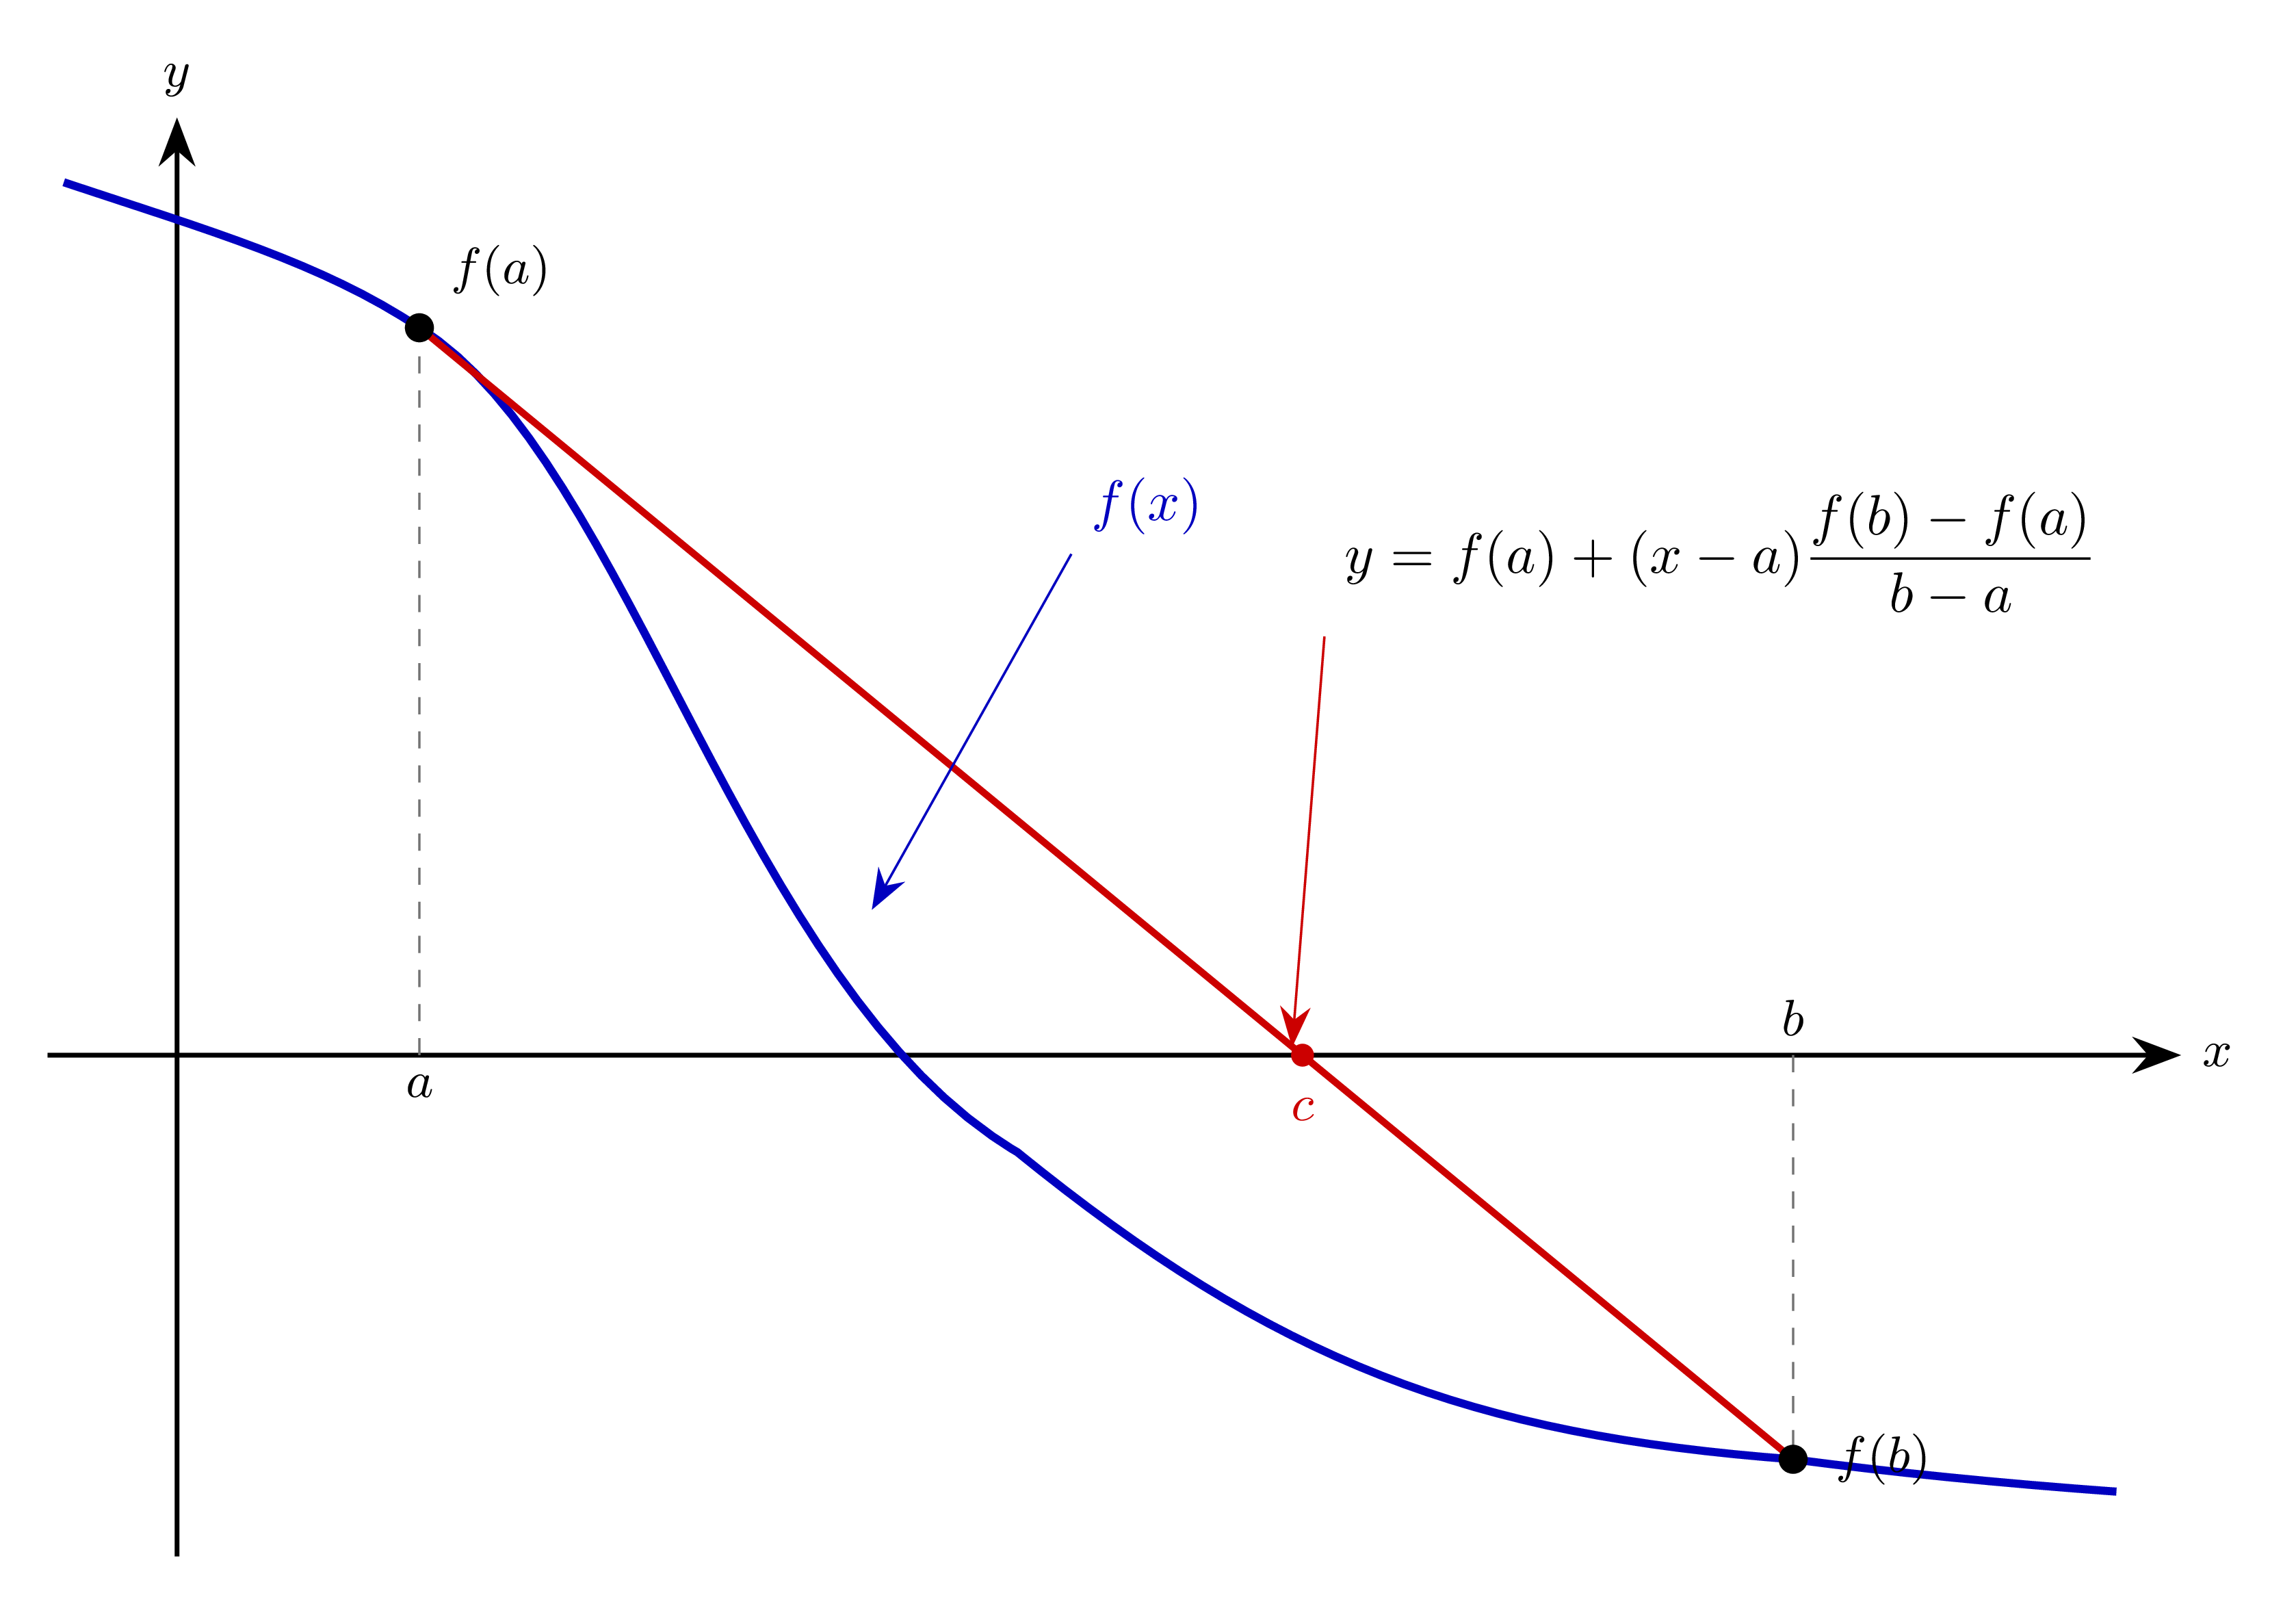
Per stimare la posizione della radice, costruiamo la retta che interpola i punti:
\begin{pmatrix} a \\ f(a) \end{pmatrix}, \qquad \begin{pmatrix} b \\ f(b) \end{pmatrix},
ossia l’equazione della retta diventa:
y = f(a) + (x-a) \dfrac{f(b)-f(a)}{b-a},
\tag{20.13}
Figura 20.2: Costruzione della regula falsi
Lo zero della retta interpolante, ottenuto risolvendo l’20.13, fornisce la seguente stima della radice \hat{x} della funzione f(x):
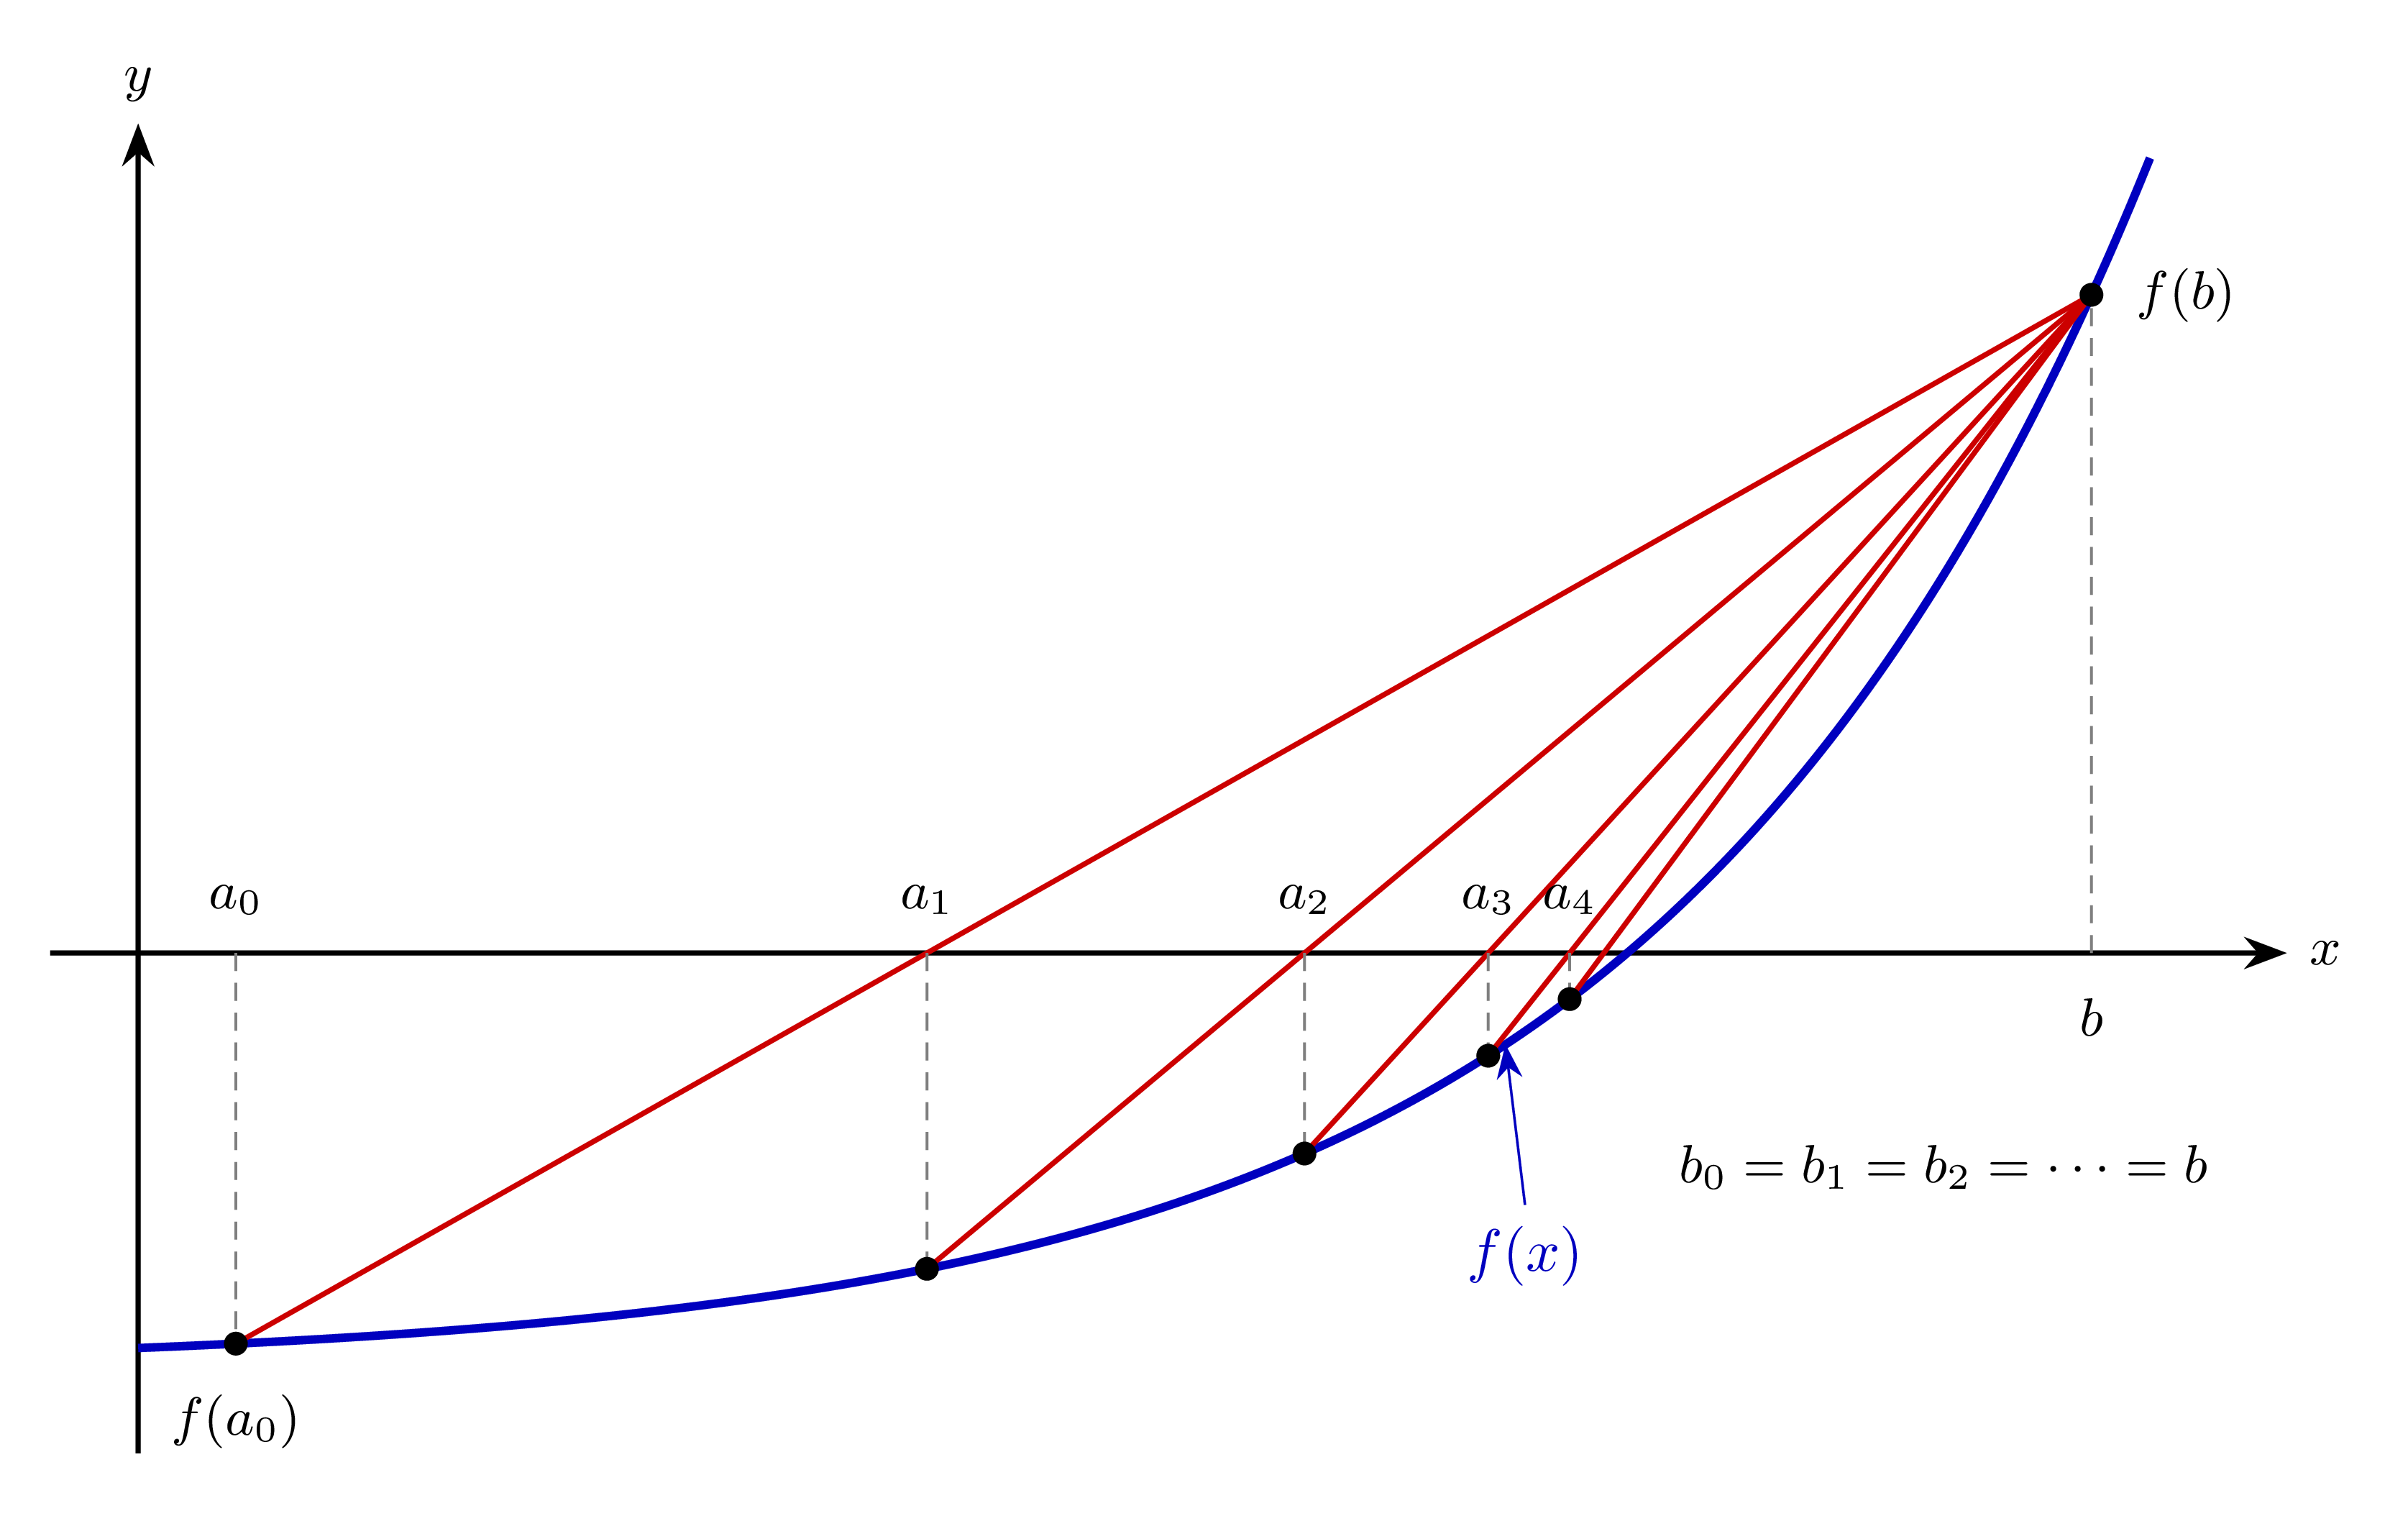
A questo punto, possiamo applicare un procedimento simile a quello del metodo di bisezione, scegliendo come nuovo intervallo [a,\hat{x}] o [\hat{x},b], a seconda del segno di f(\hat{x}). Tuttavia, la regula falsi non garantisce che gli intervalli costruiti diventino sempre più piccoli, come mostrato in Figura 20.3.
Figura 20.3: Andamento della regula falsi
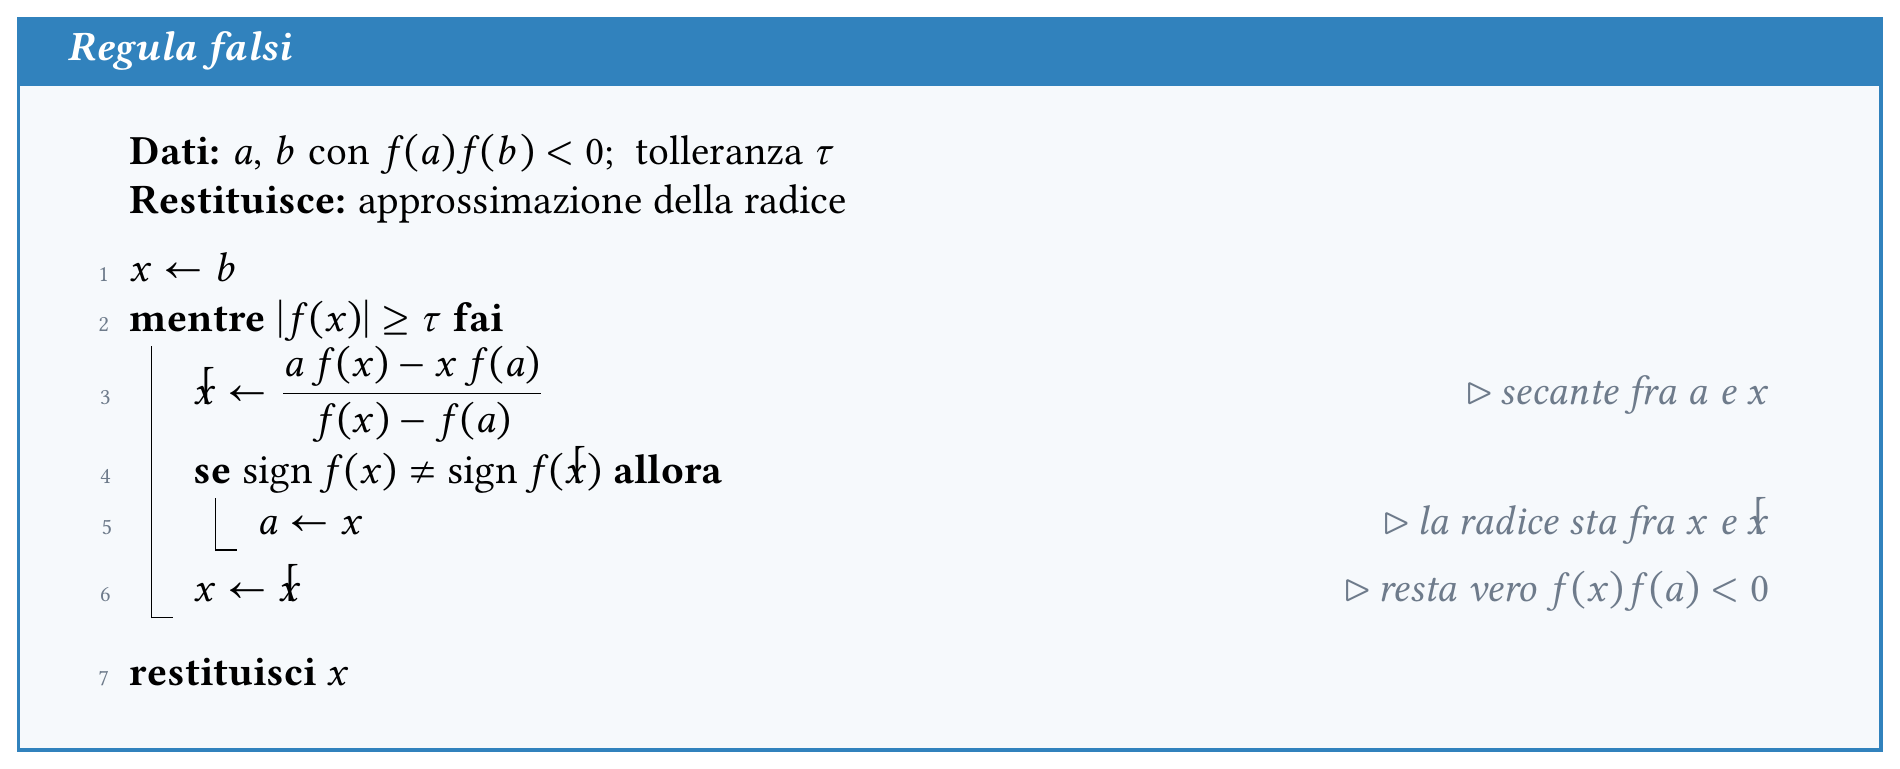
Infatti, il metodo genera una coppia di punti x_{k} e a_k, dove x_k è l’approssimazione corrente della radice e a_k è tale che f(x_{k})f(a_k) < 0; tipicamente solo x_k converge alla radice, mentre a_k resta congelato in uno degli estremi iniziali.
Il metodo delle false posizioni può essere riassunto nel seguente algoritmo.
Si noti che il criterio d’arresto è qui basato sul residuo, con i limiti discussi in Sezione 20.4. Poiché l’ampiezza \left\lvert x_k-a_k\right\rvert non tende a zero, non è utilizzabile il test sul bracket.
Convergenza della regula falsi
Per discutere la convergenza della regula falsi, assumiamo che la funzione f(x) abbia derivata seconda continua e consideriamo le seguenti ipotesi:
x_0 < a_0;
f(x_0) < 0 e f(a_0) > 0;
f''(x) \geq 0 per ogni x \in [x_0, a_0].
Con queste condizioni, è possibile dimostrare il seguente teorema.
Teorema 20.5 (Teorema: convergenza della regula falsi) Sotto le ipotesi a–c, la regula falsi converge, e inoltre:
Poiché \mu - a_0 \leq \eta - a_0 < 0, ne segue che f(\mu) = 0, dimostrando così la convergenza del metodo.
Poiché l’estremo a_k resta congelato in a_0, lo schema è asintoticamente equivalente al metodo delle corde con pendenza m=\bigl(f(a_0)-f(\alpha)\bigr)/(a_0-\alpha): la convergenza della regula falsi è dunque in generale soltanto lineare, con fattore
che può essere molto vicino a 1 se f è fortemente convessa. Le varianti Illinois e Pegasus ovviano al problema dimezzando (o riscalando) il valore f(a_k) dell’estremo congelato ogni volta che esso non viene aggiornato per due passi consecutivi, recuperando convergenza superlineare senza perdere il bracket.
20.9 Metodo delle corde (derivata congelata)
A differenza della falsa posizione, che aggiorna gli estremi di un intervallo, il metodo delle corde nel senso di Newton con pendenza congelata fissa una derivata m=f'(x_0)\neq0 e ripete
\boxed{x_{k+1}=x_k-\frac{f(x_k)}{m}}.
\tag{20.14}
È l’intersezione con l’asse x della retta di pendenza costante m passante per (x_k,f(x_k)). Con e_k=x_k-\alpha, f(\alpha)=0 e f'(\alpha)\neq0,
La convergenza locale è lineare se |1-f'(\alpha)/m|<1; scegliendo m=f'(\alpha) si annulla il termine lineare. Il metodo è lento ma estremamente economico: una sola valutazione di f per iterazione e una sola valutazione di f' in tutto. È il prototipo dei metodi di Newton inesatti, in cui la derivata (o la matrice jacobiana, nel caso di sistemi) viene aggiornata solo ogni tanto.
20.10 Metodo di Müller: interpolazione parabolica su tre punti
Il metodo di Müller6 interpola tre coppie (x_j,f(x_j)) con un polinomio quadratico e ne seleziona uno zero. Non richiede derivate ed è distinto dal metodo della parabola tangente di Taylor descritto in Sezione 20.11. La convergenza locale generica ha ordine circa 1.84, la radice reale di z^3=z^2+z+1.
Costruzione del metodo
Il metodo parte da tre punti distinti x_{k-2}, x_{k-1}, x_k, e costruisce una parabola che interpola la funzione f(x) in questi punti. La parabola ha la seguente forma generale:
P(x) = a(x - x_k)^2 + b(x - x_k) + c
I coefficienti a, b e c sono determinati imponendo che la parabola passi attraverso i punti (x_{k-2}, f(x_{k-2})), (x_{k-1}, f(x_{k-1})) e (x_k, f(x_k)). Posto
a = \dfrac{\delta_2-\delta_1}{h_2+h_1}, \qquad
b = a\,h_2 + \delta_2, \qquad
c = f(x_k).
La nuova iterata x_{k+1} è lo zero di P(x) più vicino a x_k. Scrivendo la formula risolutiva in forma razionalizzata, per evitare la cancellazione numerica, si ottiene
dove il segno va scelto in modo da rendere massimo il modulo del denominatore. Se il radicando è negativo la radice quadrata è complessa e il metodo produce iterate complesse: questa è una delle ragioni per cui il metodo è usato nella ricerca delle radici complesse dei polinomi, dove è un ingrediente classico degli algoritmi di deflazione.
Avvertenze: se i tre punti sono troppo vicini tra loro, i rapporti \delta_1,\delta_2 e la loro differenza sono soggetti a cancellazione e il metodo diventa instabile; inoltre se a=0 la parabola degenera in una retta e la 20.15 va sostituita dal passo delle secanti.
Esempio numerico
Cerchiamo uno zero di f(x)=x^3-2x-5 (la cubica di Wallis, la cui radice reale vale \alpha=2.0945514815423266\ldots) partendo da tre valori iniziali.
# Esempio in Rf <-function(x) x^3-2*x -5# Inizializzazione dei puntix0 <-3; x1 <-4; x2 <-2# Iterazione del metodo di Mullerfor (i in1:5) { h1 <- x1 - x0 h2 <- x2 - x1 delta1 <- (f(x1) -f(x0)) / h1 delta2 <- (f(x2) -f(x1)) / h2 a <- (delta2 - delta1) / (h2 + h1) b <- a*h2 + delta2 c <-f(x2) radice <-sqrt(b^2-4*a*c)# Scelta del segno per garantire stabilitàif (abs(b + radice) >abs(b - radice)) { denominatore <- b + radice } else { denominatore <- b - radice }# Nuovo punto dx <--2*c / denominatore x3 <- x2 + dx# Aggiornamento dei punti x0 <- x1 x1 <- x2 x2 <- x3print(x3) # Stampa dell'approssimazione della radice}
In questo esempio il discriminante b^2-4ac resta positivo a ogni passo e le iterate restano reali. In generale non è così: se la parabola interpolante non interseca l’asse reale il radicando diventa negativo e occorre passare all’aritmetica complessa (in R basta sqrt(as.complex(b^2-4*a*c))), altrimenti sqrt restituisce NaN e l’iterazione si arresta.
20.11 Metodo della parabola tangente (Taylor quadratico)
Questa costruzione è comunemente chiamata metodo di Newton di secondo ordine mediante approssimazione quadratica o quadratic Taylor method; come osservato in Sezione 20.10 non va attribuita a Müller, che usa tre valori della funzione anziché le derivate. Si cerca lo zero del polinomio di Taylor di grado due tangente a f in x_k. La formula razionalizzata che ricaveremo seleziona il ramo che tende al passo di Newton quando f''\to 0.
Consideriamo l’espansione di Taylor attorno alla radice \alpha a partire da un punto x_0, con h=\alpha-x_0:
Quando f(x_0) \approx 0, abbiamo \sqrt{1 - 2 f(x_0) f''(x_0)/f'(x_0)^2} \approx 1, e la 20.20 calcola h come differenza di due quantità quasi uguali: è il caso tipico di cancellazione numerica. Per evitarla riscriviamo l’espressione usando l’identità:
Il fattore fra parentesi tende a 1 quando f''\to0: in tal caso si ritrova esattamente il passo di Newton. Su radici semplici e per f\in C^3 il metodo ha ordine locale tre, al prezzo di tre valutazioni per iterazione (f, f', f''). Si ribadisce che l’ordine \approx1.84 citato in Sezione 20.10 appartiene al metodo di Müller interpolatorio, non a questa costruzione.
20.12 Metodo di Halley
Il metodo presentato in 20.21 presenta una limitazione: se il termine sotto radice è negativo non possiamo applicarlo nel campo reale, poiché la parabola tangente non interseca l’asse x. Per ottenere un passo razionale senza radice quadrata, utilizziamo lo sviluppo di Taylor della funzione g(z) = \sqrt{1 + z}:
Questo è il metodo di Halley7. Rispetto alla parabola tangente il passo è sempre definito (salvo annullamento del denominatore) e non richiede radici quadrate, pur conservando l’ordine tre.
Vale il seguente teorema.
Teorema 20.6 (Teorema: convergenza del metodo di Halley) Sia f \in C^{3}([a,b]) e \alpha una radice semplice di f(x), cioè f'(\alpha) \neq 0. Se x_0 \in (\alpha - \rho, \alpha + \rho) con \rhosufficientemente piccolo, allora la successione generata dallo schema 20.22 soddisfa:
x_k \in (\alpha - \rho, \alpha + \rho) per k = 1, 2, 3, \ldots
\left\lvert e_{k+1}\right\rvert \leq C \left\lvert e_k\right\rvert^{3} per k = 0, 1, 2, \ldots,
cioè la convergenza è cubica.
Dimostrazione. Sviluppando con la serie di Taylor con resto di Lagrange ai tre ordini successivi,
Poiché \alpha è supposto zero semplice si ha \left\lvert f'(\alpha)\right\rvert>0. Inoltre, per la continuità di f', esiste \rho tale che 2f'(x)^2>\tfrac32 f'(\alpha)^2 per ogni x\in(\alpha-\rho,\alpha+\rho) e M_1M_2\,\rho<\tfrac12 f'(\alpha)^2. Se x_k\in(\alpha-\rho,\alpha+\rho), il denominatore è allora maggiore di \tfrac32 f'(\alpha)^2-\tfrac12 f'(\alpha)^2=f'(\alpha)^2 e quindi
Errore \lvert x_k-\alpha\rvert: metodi che usano le derivate
k
corde
Newton
parabola tangente
Halley
1
2.65e-01
2.65e-01
9.46e-02
7.38e-02
2
1.28e-01
3.26e-02
7.59e-05
8.49e-05
3
6.69e-02
5.85e-04
3.91e-14
1.39e-13
4
3.59e-02
1.92e-07
0.00e+00
0.00e+00
5
1.95e-02
2.09e-14
0.00e+00
0.00e+00
6
1.07e-02
0.00e+00
0.00e+00
0.00e+00
7
5.90e-03
0.00e+00
0.00e+00
0.00e+00
La lettura delle tabelle conferma la teoria:
bisezione: l’errore non decresce in modo monotono (il punto medio può capitare dalla parte sbagliata), ma è sempre maggiorato da 2^{-k}(b-a);
regula falsi e corde: decrescita lineare, con un fattore costante per iterazione;
secanti: superlineare, raggiunge la precisione di macchina alla sesta iterazione;
Müller: superlineare con ordine più alto delle secanti, alla quarta — e con una sola valutazione per iterazione, come le secanti;
Newton: quadratico, raddoppia le cifre esatte a ogni passo;
parabola tangente e Halley: cubici, sono alla precisione di macchina già alla quarta iterazione.
Il confronto per iterazione però non è equo, perché il costo di un’iterazione non è lo stesso:
Costo e ordine dei metodi; \nu è il numero di valutazioni per iterazione
Metodo
f
f'
f''
\nu
Ordine p
Efficienza p^{1/\nu}
bisezione
1
–
–
1
1 (fattore 1/2)
1
regula falsi
1
–
–
1
1
1
corde
1
–
–
1
1
1
secanti
1
–
–
1
1.618
1.618
Müller
1
–
–
1
1.839
\mathbf{1.839}
Newton
1
1
–
2
2
1.414
parabola tangente
1
1
1
3
3
1.442
Halley
1
1
1
3
3
1.442
Per i metodi lineari l’indice p^{1/\nu} vale 1 e non discrimina: fra di essi il confronto va fatto sul fattore di riduzione asintotico, che per la bisezione è 1/2 e per regula falsi e corde dipende da f.
Fra i metodi superlineari, invece, l’ordinamento si ribalta rispetto a quello per iterazione: i metodi senza derivate sono i più efficienti, perché riutilizzano i valori già calcolati e spendono una sola valutazione per passo. Contando le valutazioni totali necessarie per raggiungere la precisione di macchina su questo problema si ottiene
dove i primi addendi di Müller e secanti sono le valutazioni nei punti iniziali. Newton e Halley tornano competitivi solo quando f' e f'' si ottengono insieme a f con poco lavoro aggiuntivo — come accade per i polinomi (schema di Horner esteso alle derivate) o con la differenziazione automatica — oppure quando la robustezza conta più della velocità, nel qual caso la scelta corretta è comunque un metodo ibrido.
In sintesi
Bisezione: convergenza garantita se f(a)f(b)<0, ma solo lineare con fattore 1/2; è il metodo di sicurezza e l’unico con una maggiorazione rigorosa dell’errore a ogni passo.
Newton-Raphson: convergenza quadratica per radici semplici, ma soltanto locale, e richiede f'. Sotto le ipotesi di Fourier (convessità e monotonia) la convergenza è globale e monotona a partire dall’estremo opportuno.
Il metodo delle secanti è la variante di Newton senza derivata, con ordine \varphi\approx1.618 ma una sola valutazione per iterazione. Il metodo di Müller fa lo stesso con una parabola interpolante anziché una retta, salendo a p\approx1.839 sempre con una sola valutazione: è il più efficiente dei metodi del capitolo.
La regula falsi conserva il bracket, e dunque la convergenza, ma è in generale soltanto lineare perché un estremo resta congelato; le varianti Illinois e Pegasus correggono il difetto.
Parabola tangente e Halley salgono a ordine tre usando la derivata seconda, ma al prezzo di tre valutazioni per iterazione.
Il confronto fra metodi va fatto a parità di valutazioni di funzione, non di iterazioni: l’indice di efficienza p^{1/\nu} è il criterio corretto, e ribalta l’ordinamento a favore dei metodi senza derivate.
L’accuratezza raggiungibile non dipende dal metodo ma dal condizionamento della radice1/\left\lvert f'(\alpha)\right\rvert e, per radici multiple, degrada come \epsilon_f^{1/m}: nessun metodo può fare meglio (Sezione 20.4).
Tutti i metodi aperti possono fallire (cicli, divergenza, derivata nulla). La soluzione pratica è combinarli con un passo di sicurezza, come fanno i metodi ibridi di Capitolo 22.