7 Interpolazione di Lagrange

Il metodo più noto per costruire un polinomio che interpola un insieme di punti è quello dei polinomi interpolatori di Lagrange.
La costruzione di questo polinomio può essere ottenuta attraverso una dimostrazione alternativa rispetto a quella che si basa sul determinante di Vandermonde1, comunemente utilizzata per dimostrare l’esistenza e l’unicità del polinomio interpolatore.
Questa dimostrazione, inoltre, fornisce l’algoritmo stesso per l’interpolazione secondo il metodo di Lagrange.
Teorema 7.1 (Lagrange) Sia f(x) una funzione sull’intervallo [a,b] e siano \{x_i\}_{i=0}^{n} punti distinti di [a,b], allora esiste un unico polinomio p_n(x)\in\mathbb{R}_n[x] tale che
p_n(x_i)=f(x_i), \qquad \forall\; i=1,2,\ldots,n.
I punti \{x_i\}_i sono detti nodi di interpolazione e p_n(x) si dice polinomio interpolatore di Lagrange nei nodi \{x_i\}_i.
Dimostrazione. Come prima cosa si dimostra l’unicità di questo polinomio, l’esistenza si dimostra esibendo il polinomio cercato. Siano dunque p(x) e q(x) due polinomi di grado n che soddisfano
p(x_i)=f(x_i)\qquad e \qquad q(x_i)=f(x_i), \qquad i=0,1,2,\ldots,n.
Allora il polinomio p(x)-q(x) ha anche grado n ed ha come gli n+1 punti x_i, infatti p(x_i)-q(x_i)=f(x_i)-f(x_i)=0 e quindi deve essere il polinomio nullo, pertanto p(x)\equiv q(x).
Costruiamo ora il polinomio interpolatore, sia \mathcal{L}_i\in\mathbb{R}[x] definito come \mathcal{L}_i(x_j)=\delta_{ij}, dove \delta_{ij} è il delta di Kronecker2, ovvero una funzione che vale 1 se e solo se i=j e zero in tutti gli altri casi. Senza perdita di generalità si può supporre n\geq 1. Tale polinomio \mathcal{L}_i prende il nome di polinomio caratteristico di Lagrange, ed è facilmente scrivibile come
\mathcal{L}_i(x)=\prod_{0\leq k\leq n\atop k\neq i}\dfrac{x-x_k}{x_i-x_k}.
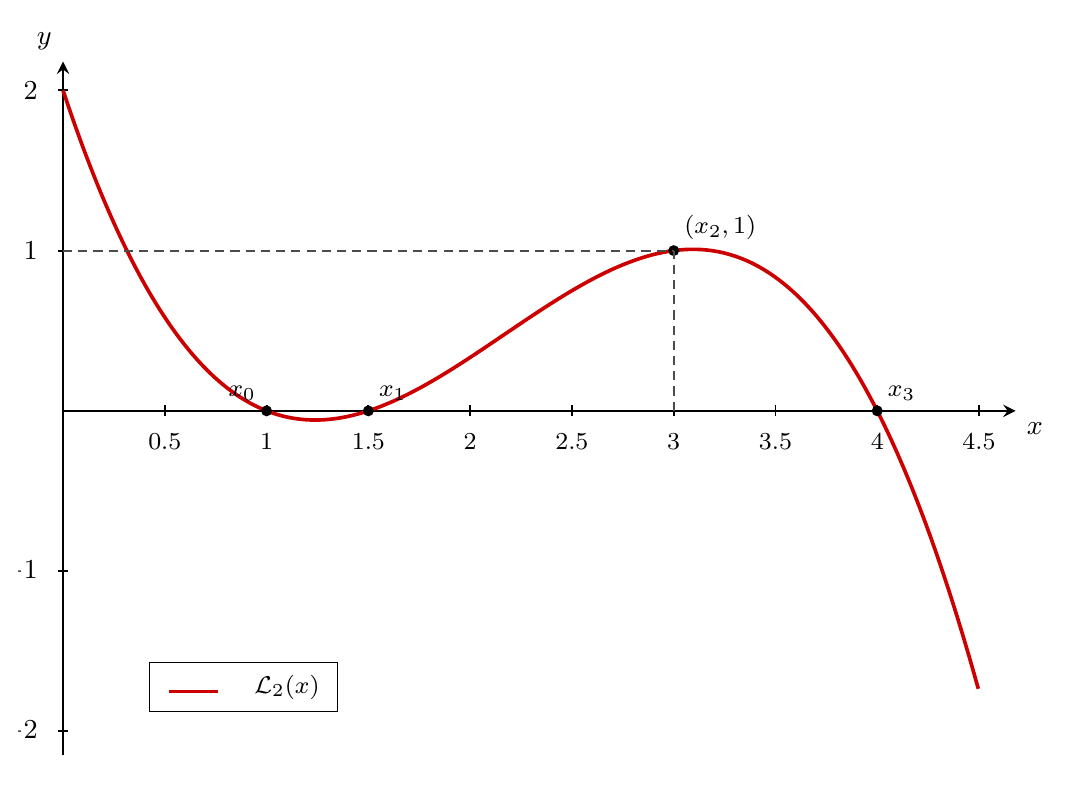
Ad esempio se ci sono solo quattro nodi \{x_0,x_1,x_2,x_3\}, il polinomio \mathcal{L}_2(x) sarà definito come
\begin{aligned} \mathcal{L}_2(x) &= \dfrac{x-x_0}{x_2-x_0}\cdot\dfrac{x-x_1}{x_2-x_1}\cdot\dfrac{x-x_3}{x_2-x_3}, \\ \mathcal{L}_2(x_0) &=\dfrac{x_0-x_0}{x_2-x_0}\cdot \, \cdots = 0, \\ \mathcal{L}_2(x_2) &= \dfrac{x_2-x_0}{x_2-x_0}\cdot\dfrac{x_2-x_1}{x_2-x_1}\cdot\dfrac{x_2-x_3}{x_2-x_3} = 1. \end{aligned}
Il grafico di \mathcal{L}_2(x) per x_i=\{1,1.5,3,4\} è disegnato in Figura 7.1.
Si sfrutta questa costruzione per scrivere il polinomio interpolatore di Lagrange nel modo seguente:
p_n(x) = \sum_{i=0}^n f(x_i)\mathcal{L}_i(x) \tag{7.1}
che con l’ausilio dell’esempio precedente è un polinomio che vale f(x_i) nel nodo x_i, questo polinomio ha il giusto grado e quindi è il polinomio cercato.
Un altro modo per scrivere un generico polinomio caratteristico di Lagrange è usare il polinomio
\begin{aligned} \omega_{n+1}(x) &= \prod_{i=0}^n(x-x_i) \in \mathbb{R}_{n+1}[x]\\ \omega^\prime_{n+1}(x) &= \sum_{i=0}^n \prod_{j=0\atop j\neq i}^n(x-x_j)\\ &= (x-x_1)(x-x_2)\cdots (x-x_n)\\ &+ (x-x_0)(x-x_2)\cdots (x-x_n)\\ &+ \ldots (x-x_0)(x-x_1)\cdots (x-x_{n-1}). \end{aligned}
Il polinomio caratteristico \mathcal{L}_i(x) si riscrive in modo più compatto come
\mathcal{L}_i(x)=\dfrac{\omega_{n+1}(x)}{(x-x_i)\omega^\prime_{n+1}(x_i)}.
In pratica, la derivata di \omega_{n+1}(x) valutata su un nodo x_i non è altro che il polinomio
\prod_{j\neq i}^n(x_i-x_j)
Infatti di tutti gli addendi di \omega^\prime_{n+1}(x) sopravvive solo quello che non contiene (x-x_i) (che azzera tutto il termine).
Esempio 7.1 Supponiamo di voler interpolare i dati \{(-1,1),(2,7),(0,1)\}, e svolgiamolo con il metodo di Lagrange. Abbiamo bisogno di calcolare i polinomi caratteristici \mathcal{L}_0, \mathcal{L}_1 ed \mathcal{L}_2:
\begin{aligned} \mathcal{L}_0(x) &= \dfrac{x-x_1}{x_0-x_1}\dfrac{x-x_2}{x_0-x_2} &= \dfrac{x}{-1}\dfrac{x-2}{-1-2}&=& \dfrac{x(x-2)}{3}\\ \mathcal{L}_1(x) &= \dfrac{x-x_0}{x_1-x_0}\dfrac{x-x_2}{x_1-x_2} &=\dfrac{x+1}{1}\dfrac{x-2}{0-2}&=& -\dfrac{(x+1)(x-2)}{2}\\ \mathcal{L}_2(x) &= \dfrac{x-x_0}{x_2-x_0}\dfrac{x-x_1}{x_2-x_1} &=\dfrac{x+1}{2+1}\dfrac{x}{2}&=& \dfrac{x(x+1)}{6} \end{aligned}
Ora basta calcolare il polinomio interpolatore usando la 7.1, ovvero
\begin{aligned} p_n(x) &= p_2(x)= \sum_{i=0}^n f(x_i)L_i(x) \\ &= 1\cdot \dfrac{x(x-2)}{3} +1\cdot \dfrac{(x+1)(x-2)}{-2}+7\cdot\dfrac{x(x+1)}{6}\\ &= \left(\dfrac{1}{3}-\dfrac{1}{2}+\dfrac{7}{6}\right)x^2+\left(-\dfrac{2}{3}+1-\dfrac{1}{2}+\dfrac{7}{6}\right)x+1 \\ & = x^2+x+1, \end{aligned}
che è proprio il polinomio calcolato con il metodo del sistema lineare.
7.1 Derivazione pratica della interpolazione di Lagrange
L’interpolazione di Lagrange3 permette di costruire un polinomio di grado n che passa esattamente per un insieme di punti dati. I polinomi di Lagrange sono definiti come:
\ell_k (x ) = \prod_{i=0\atop i\neq k}^n (x-x_i),
Questi polinomi hanno una proprietà fondamentale:
\ell_k (x_i) = \begin{cases} 0 & i \neq k \\ \text{non nullo} & i = k \end{cases}
Da questa proprietà possiamo costruire i polinomi di Lagrange normalizzati, detti \mathcal{L}_k(x), come: \mathcal{L}_k(x) = \dfrac{\ell_k (x)}{\ell_k (x_k)}
Tali polinomi soddisfano:
\mathcal{L}_k (x_i) = \begin{cases} 0 & i \neq k \\ 1 & i = k \end{cases}
Definizione 7.1 (Polinomi elementari di Lagrange) I polinomi di Lagrange \mathcal{L}_k(x), detti anche polinomi elementari di Lagrange, hanno la forma esplicita:
\mathcal{L}_k(x ) = \dfrac{\omega_{n+1}(x)}{(x -x_k)\omega_{n+1}'(x_k)} = \prod_{i=0\atop i\neq k}^{n} \left(\dfrac{x - x_i}{x_k - x_i}\right).
Questi polinomi sono fondamentali nell’interpolazione poiché soddisfano la proprietà \delta_{ik}, ossia L_k(x_i) = \delta_{ik}, con \delta_{ik} simbolo di Kronecker.
Si ha quindi che la matrice dei coefficienti del problema di interpolazione soddisfa \bm{M}=\bm{I} ed il problema della interpolazione si riduce a a_k=f(x_k),\quad k=0,1\ldots n.
Polinomio interpolante
Utilizzando i polinomi \mathcal{L}_k(x), possiamo scrivere il polinomio interpolante di grado n che passa per i punti (x_i, f(x_i)) come:
\boxed{ p(x) = \sum_{k=0}^n f(x_k)\mathcal{L}_k(x ) = \sum_{k=0}^n f(x_k ) \dfrac{\omega_{n+1}(x)} {(x-x_k) \omega_{n+1}'(x_k )} }
Stabilità
In questa sezione vedremo che il processo di interpolazione con nodi equispaziati non è stabile rispetto alla variazione dei dati. Consideriamo un tipo di errore dato dall’inesattezza della misurazione del valore della funzione, ad esempio indichiamo con \hat{f}(x_i) il valore misurato effettivamente (quindi con errori di arrotondamento, misurazione, ecc.) di f(x_i). Se interpoliamo questi dati otterremo un polinomio \hat{p}_n, ci chiediamo quanto sia grande la differenza tra i due polinomi. Si ha, usando il metodo di interpolazione di Lagrange, che
\begin{aligned} \max_{[a,b]}|\hat{p}_n(x)-p_n(x)| &=\max_{[a,b]} \bigg\lvert \sum_{i=0}^n \left(\hat{f}(x_i)-f(x_i)\right) \mathcal{L}_i(x) \bigg\rvert \\ & \leq \max \sum_{i=0}^n|\mathcal{L}_i(x)|\cdot \max_{0\leq i \leq n}|\hat{f}(x_i)-f(x_i)|, \\ & \leq \Lambda_n \max_{0\leq i \leq n}|\hat{f}(x_i)-f(x_i)|. \end{aligned}
La costante \Lambda_n=\max \sum_{i=0}^n|\mathcal{L}_i(x)| è detta costante di Lebesgue4 che dipende dai nodi di interpolazione. Quindi a piccole variazioni sui dati corrispondono piccole variazioni sul polinomio interpolatore fatta salva la costante di Lebesgue. Se essa è piccola, anche la variazione è piccola, ma se è grande può causare grandi differenze. Questa costante ha il ruolo di numero di condizionamento del problema. Nel caso dell’interpolazione di Lagrange su nodi equispaziati si può approssimare bene con
\Lambda_n \approx \dfrac{2^{n+1}}{ne(\ln(n)+\gamma)},
dove e è il numero di Nepero e \gamma\approx 0.5477 è la costante di Eulero-Mascheroni.
7.2 Polinomio di miglior approssimazione
Fissati i nodi e il grado n, accanto al polinomio interpolante ha senso considerare il polinomio di miglior approssimazione p_n^\star(x), cioè quello che rende minimo l’errore in norma infinito fra tutti i polinomi di grado n:
E_n^\star := \|f-p_n^\star\|_{\infty} \leq \|f-p_n\|_{\infty}.
Il polinomio di miglior approssimazione in generale non interpola f nei nodi, quindi non è calcolabile con le formule viste finora. La costante di Lebesgue permette però di confrontare i due errori: se E_n:=\|f-p_n\|_{\infty} è l’errore del polinomio interpolante, vale
E_n \leq (1+\Lambda_n)\, E_n^\star. \tag{7.2}
L’interpolazione sui nodi dati è quindi lontana dalla miglior approssimazione al più di un fattore 1+\Lambda_n: minimizzare \Lambda_n significa scegliere i nodi in modo che il problema sia ben condizionato.
Non è possibile spingere \Lambda_n sotto una soglia che cresce con n. Il teorema di Natanson5 afferma infatti che, per ogni scelta dei nodi, esiste una costante C>0 tale che
\Lambda_n > \dfrac{2}{\pi}\ln(n+1) - C, \tag{7.3}
e quindi \Lambda_n\to\infty per n\to\infty. Nessuna successione di nodi rende l’interpolazione polinomiale convergente per tutte le funzioni continue: è la sostanza del teorema di Faber6, discusso nel capitolo sul fenomeno di Runge7. Il meglio che si può fare è avvicinarsi alla crescita logaritmica di 7.3, ed è quello che fanno i nodi di Chebyshev8.
In sintesi
- La base di Lagrange \ell_i rende il polinomio interpolante immediato da scrivere, ma costosa da valutare e da aggiornare.
- La costante di Lebesgue \Lambda_n è il numero di condizionamento dell’interpolazione: lega l’errore sui dati all’errore sul polinomio.
- Su nodi equispaziati \Lambda_n cresce esponenzialmente (fenomeno di Runge), sui nodi di Chebyshev solo come \log n.
- Il polinomio interpolante non è quello di miglior approssimazione, ma su buoni nodi gli è vicino a meno del fattore 1+\Lambda_n.