
alpha <- 2.09455148154232659148
f     <- function(x) x^3 - 2*x - 5
df    <- function(x) 3*x^2 - 2
ddf   <- function(x) 6*x
dddf  <- function(x) 6
EPS   <- .Machine$double.eps

# formattazione uniforme delle tabelle delle iterate
tabella <- function(st, didascalia) {
  knitr::kable(
    data.frame(
      k                   = st$k,
      passo               = st$tipo,
      `$x_k$`             = formatC(st$x,   format = "f", digits = 12),
      `$f(x_k)$`          = formatC(st$fx,  format = "e", digits = 2),
      `$\\lvert x_k-\\alpha\\rvert$` = formatC(st$err, format = "e", digits = 2),
      `$b-a$`             = formatC(st$amp, format = "e", digits = 2),
      check.names = FALSE),
    align = "r", caption = didascalia)
}22 Metodi ibridi e algoritmi con salvaguardia
Nel capitolo precedente abbiamo visto due famiglie di metodi con difetti complementari: i metodi di confinamento (bisezione, regula falsi) convergono sempre ma lentamente, mentre i metodi aperti (Newton, secanti, Halley) sono rapidi ma possono ciclare o divergere (Sezione 20.6.4). I metodi di questo capitolo risolvono il dilemma nel modo più semplice possibile: propongono il candidato di un metodo veloce e lo accettano solo se supera un test di sicurezza, ripiegando altrimenti su un passo di bisezione.
Tutti mantengono quindi un intervallo [a,b] tale che f(a)f(b)\le0, supponendo f continua, e conservano il cambio di segno dopo ogni valutazione accettata. La differenza fra i metodi riguarda quale candidato proporre, quando rifiutarlo e come imporre la riduzione dell’intervallo.
Nel seguito, quando l’intervallo è descritto da più di due punti, useremo la convenzione usuale: b è il miglior estremo (quello con \left\lvert f\right\rvert più piccolo, cioè l’iterata corrente), a è il contropunto (l’estremo che garantisce il cambio di segno, f(a)f(b)\le0) e c è il valore precedente di b.
22.1 Lo schema generale
Tutti gli algoritmi del capitolo hanno la stessa struttura.
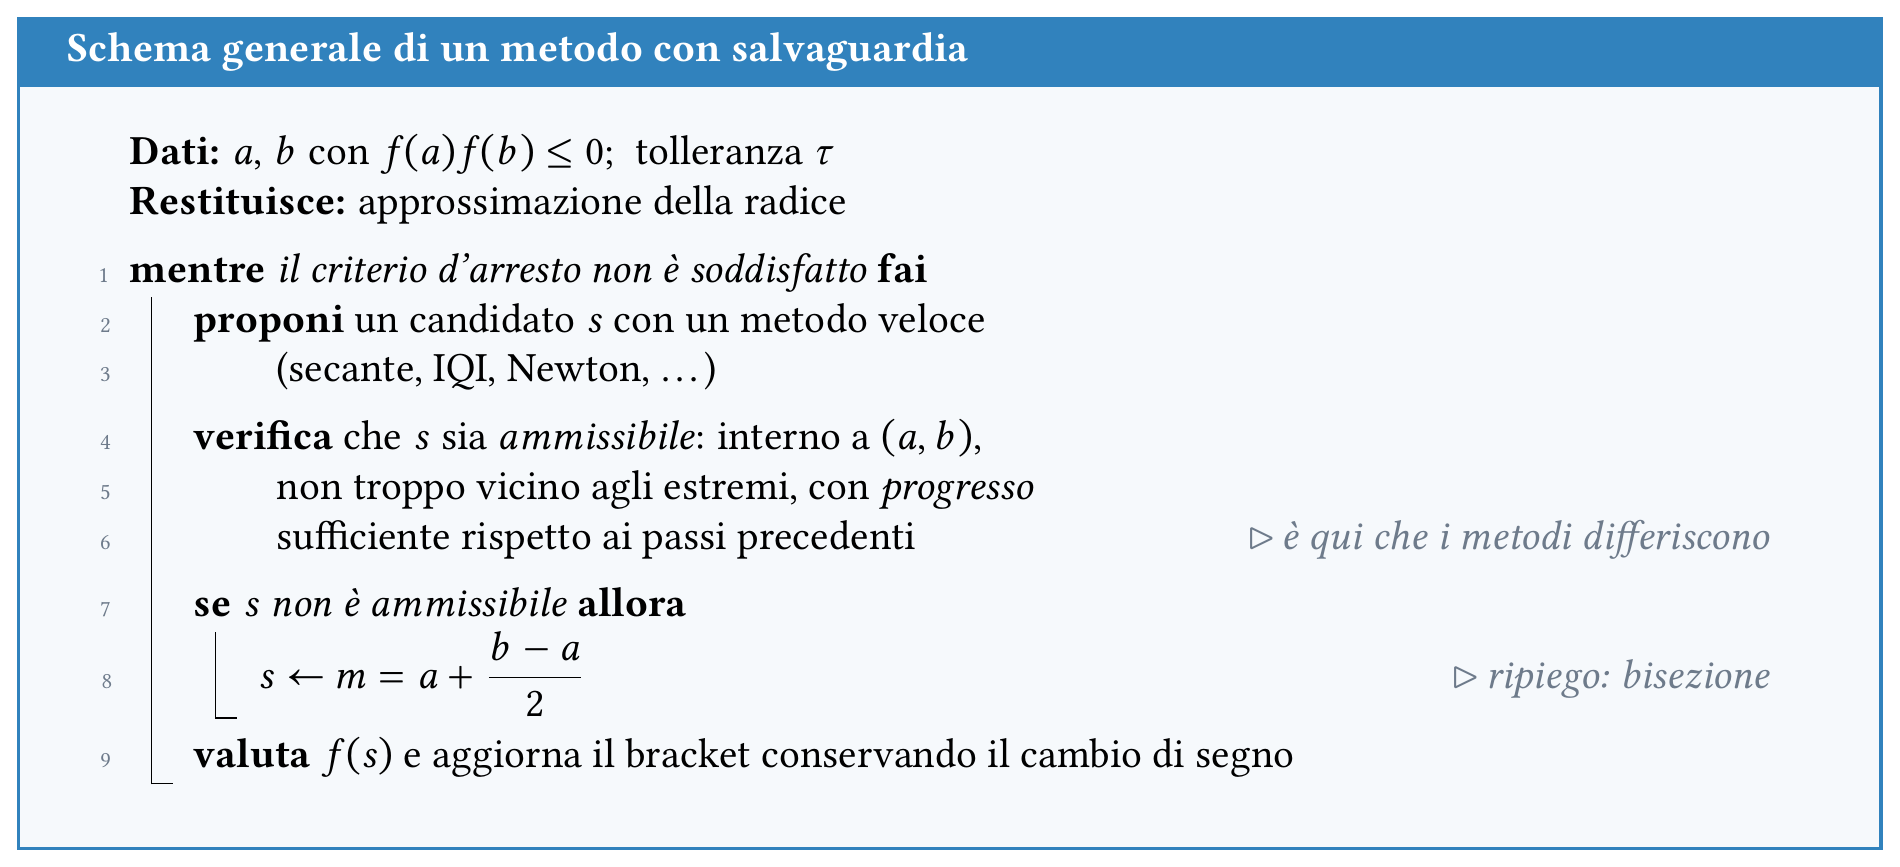
Il punto 2 è ciò che distingue un algoritmo dall’altro, ed è anche la parte più delicata: un test troppo permissivo lascia sopravvivere il cattivo comportamento del metodo veloce, uno troppo restrittivo riduce l’algoritmo a una bisezione mascherata.
Il criterio d’arresto è sempre quello discusso in Sezione 20.4, cioè b-a\le2\varepsilon_{\rm mach}\left\lvert b\right\rvert+\tau: è l’unico che fornisce una maggiorazione rigorosa dell’errore. Fa eccezione la famiglia che vedremo in Sezione 22.8, dove — come nel metodo di Newton — l’intervallo può non restringersi e ci si arresta sull’incremento \left\lvert x_{k+1}-x_k\right\rvert.
Il problema di riferimento
Per confrontare i metodi useremo lo stesso problema del capitolo precedente, la cubica di Wallis
f(x)=x^3-2x-5,\qquad \alpha = 2.0945514815423266\ldots,
sull’intervallo di partenza [2,3]. Ogni metodo sarà accompagnato dalla tabella delle iterate, con il tipo di passo effettivamente eseguito, il valore di f, l’errore e l’ampiezza del bracket. Alla fine del capitolo (Sezione 22.13) i dieci metodi vengono confrontati su cinque problemi diversi, contando le valutazioni di funzione.
22.2 Metodo di Dekker
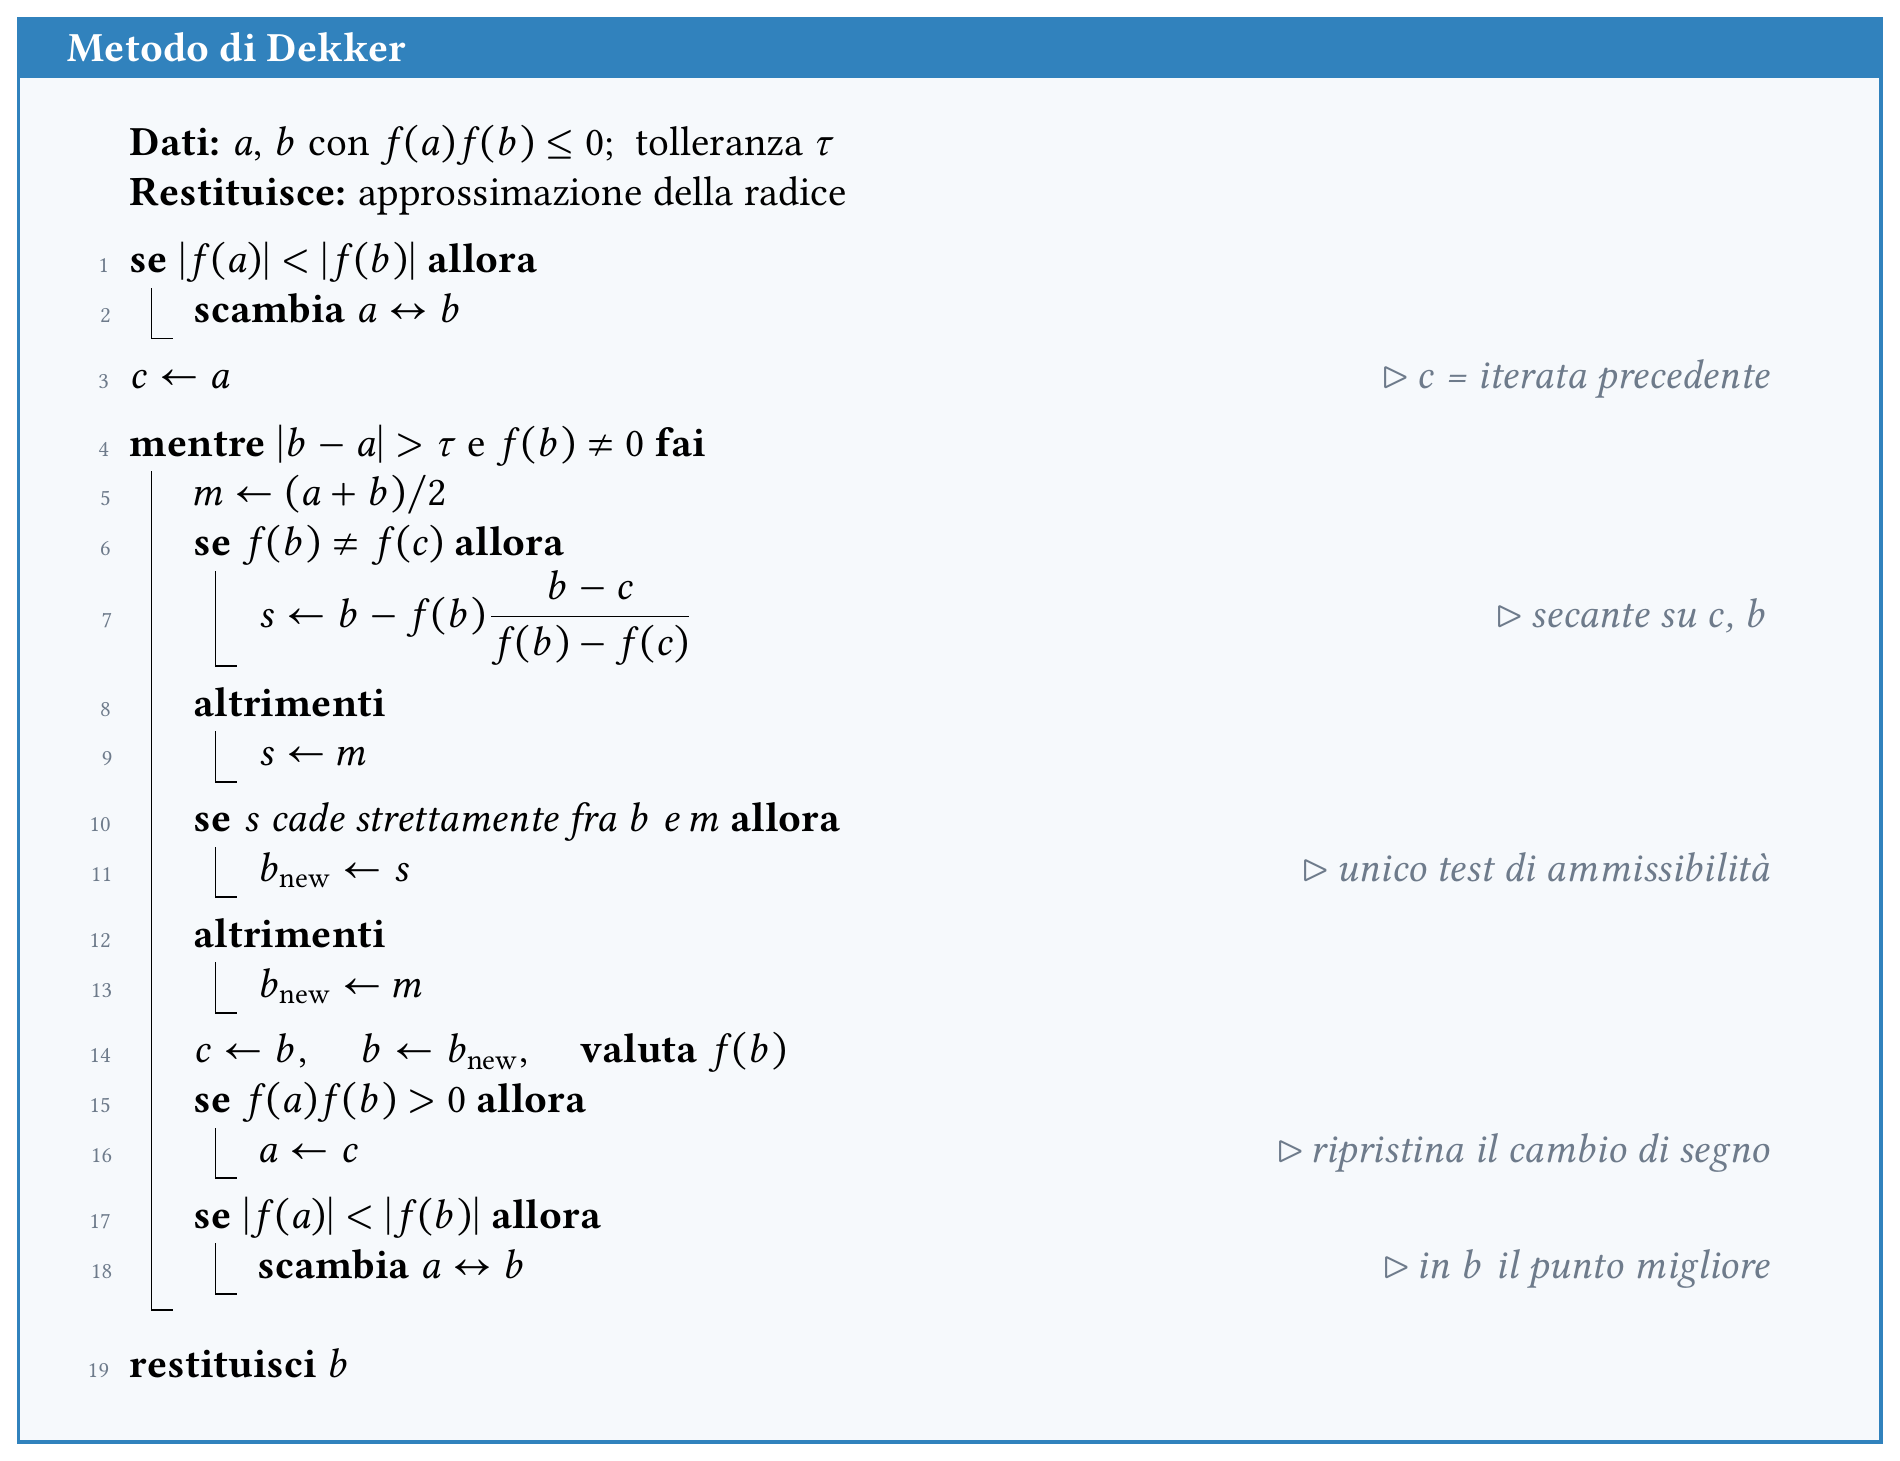
È il capostipite di tutta la famiglia [5]. L’idea è la più semplice possibile: usare la secante, ma solo quando cade dalla parte giusta.
Come funziona
Si mantengono tre punti: il miglior estremo b (l’iterata corrente, quella con \left\lvert f\right\rvert minore), il contropunto a con f(a)f(b)\le0, e il valore precedente c di b. A ogni passo si calcolano due candidati:
m=\frac{a+b}{2} \qquad\text{(bisezione)}, \qquad s=b-f(b)\,\frac{b-c}{f(b)-f(c)} \qquad\text{(secante)}.
La secante è costruita sulle ultime due iterate c e b, esattamente come nel metodo delle secanti di Sezione 20.7: non sugli estremi del bracket, come farebbe la regula falsi. È questa la ragione della sua rapidità, perché entrambi i punti convergono alla radice invece che restare uno congelato.
Il test di ammissibilità è minimale: si accetta s solo se cade nell’intervallo aperto fra b e m. In altre parole, la secante è accettata quando si muove nella stessa direzione della bisezione ma senza superarla; in tutti gli altri casi (secante che esce dal bracket, denominatore nullo, passo che supera il punto medio) si usa m. Qualunque sia il candidato scelto, il nuovo punto diventa b, il vecchio b diventa c, e il bracket viene aggiornato; se il nuovo b ha lo stesso segno di a, il contropunto diventa il vecchio b. Infine si scambiano a e b se necessario, per mantenere in b il punto con \left\lvert f\right\rvert minore.
Poiché il candidato di ripiego è il punto medio, l’ampiezza del bracket non può mai aumentare e la convergenza è sempre garantita. Il difetto, notato dallo stesso Dekker e poi corretto da Brent, è che la garanzia di velocità è debole: esistono funzioni per cui la secante viene accettata molte volte di seguito con passi minuscoli, e il bracket si riduce molto più lentamente della bisezione. Nel caso peggiore il numero di valutazioni può superare di molto quello della sola bisezione.
Esempio numerico
dekker <- function(f, a, b, tol = 1e-12, nmax = 60) {
  fa <- f(a); fb <- f(b)
  if (fa*fb > 0) stop("gli estremi non racchiudono una radice")
  if (abs(fa) < abs(fb)) { t<-a;a<-b;b<-t; t<-fa;fa<-fb;fb<-t }
  c <- a; fc <- fa                       # c = iterata precedente
  st <- data.frame()
  for (k in 1:nmax) {
    m <- (a + b)/2
    s <- if (fb != fc) b - fb*(b - c)/(fb - fc) else m
    usa <- if (is.finite(s) && ((s > b && s < m) || (s < b && s > m)))
             "secante" else "bisezione"
    xn <- if (usa == "secante") s else m
    c <- b; fc <- fb
    b <- xn; fb <- f(b)
    if (fa*fb > 0) { a <- c; fa <- fc }               # ripristina il bracket
    if (abs(fa) < abs(fb)) { t<-a;a<-b;b<-t; t<-fa;fa<-fb;fb<-t }
    st <- rbind(st, data.frame(k=k, tipo=usa, x=b, fx=fb,
                               err=abs(b-alpha), amp=abs(b-a)))
    if (abs(b-a) < tol || fb == 0) break
  }
  st
}

tabella(dekker(f, 2, 3), "Metodo di Dekker su $x^3-2x-5$, $[2,3]$")| k | passo | x_k | f(x_k) | \lvert x_k-\alpha\rvert | b-a |
|---|---|---|---|---|---|
| 1 | secante | 2.058823529412 | -3.91e-01 | 3.57e-02 | 9.41e-01 |
| 2 | secante | 2.096558636819 | 2.24e-02 | 2.01e-03 | 3.77e-02 |
| 3 | secante | 2.094510553557 | -4.57e-04 | 4.09e-05 | 2.05e-03 |
| 4 | secante | 2.094551435331 | -5.16e-07 | 4.62e-08 | 2.01e-03 |
| 5 | secante | 2.094551481543 | 1.19e-11 | 1.06e-12 | 4.62e-08 |
| 6 | secante | 2.094551481542 | -8.88e-16 | 0.00e+00 | 1.06e-12 |
| 7 | bisezione | 2.094551481542 | -8.88e-16 | 0.00e+00 | 5.32e-13 |
Sei passi di secante portano alla precisione di macchina; la bisezione interviene solo all’ultimo passo, quando la secante degenera perché f(b) e f(c) coincidono in aritmetica finita. Si osservi la colonna b-a: il bracket si restringe molto più lentamente dell’errore, perché il contropunto resta a lungo fermo. È esattamente il motivo per cui l’arresto va controllato su b-a e non su \left\lvert f\right\rvert.
22.3 Metodo di Brent–Dekker
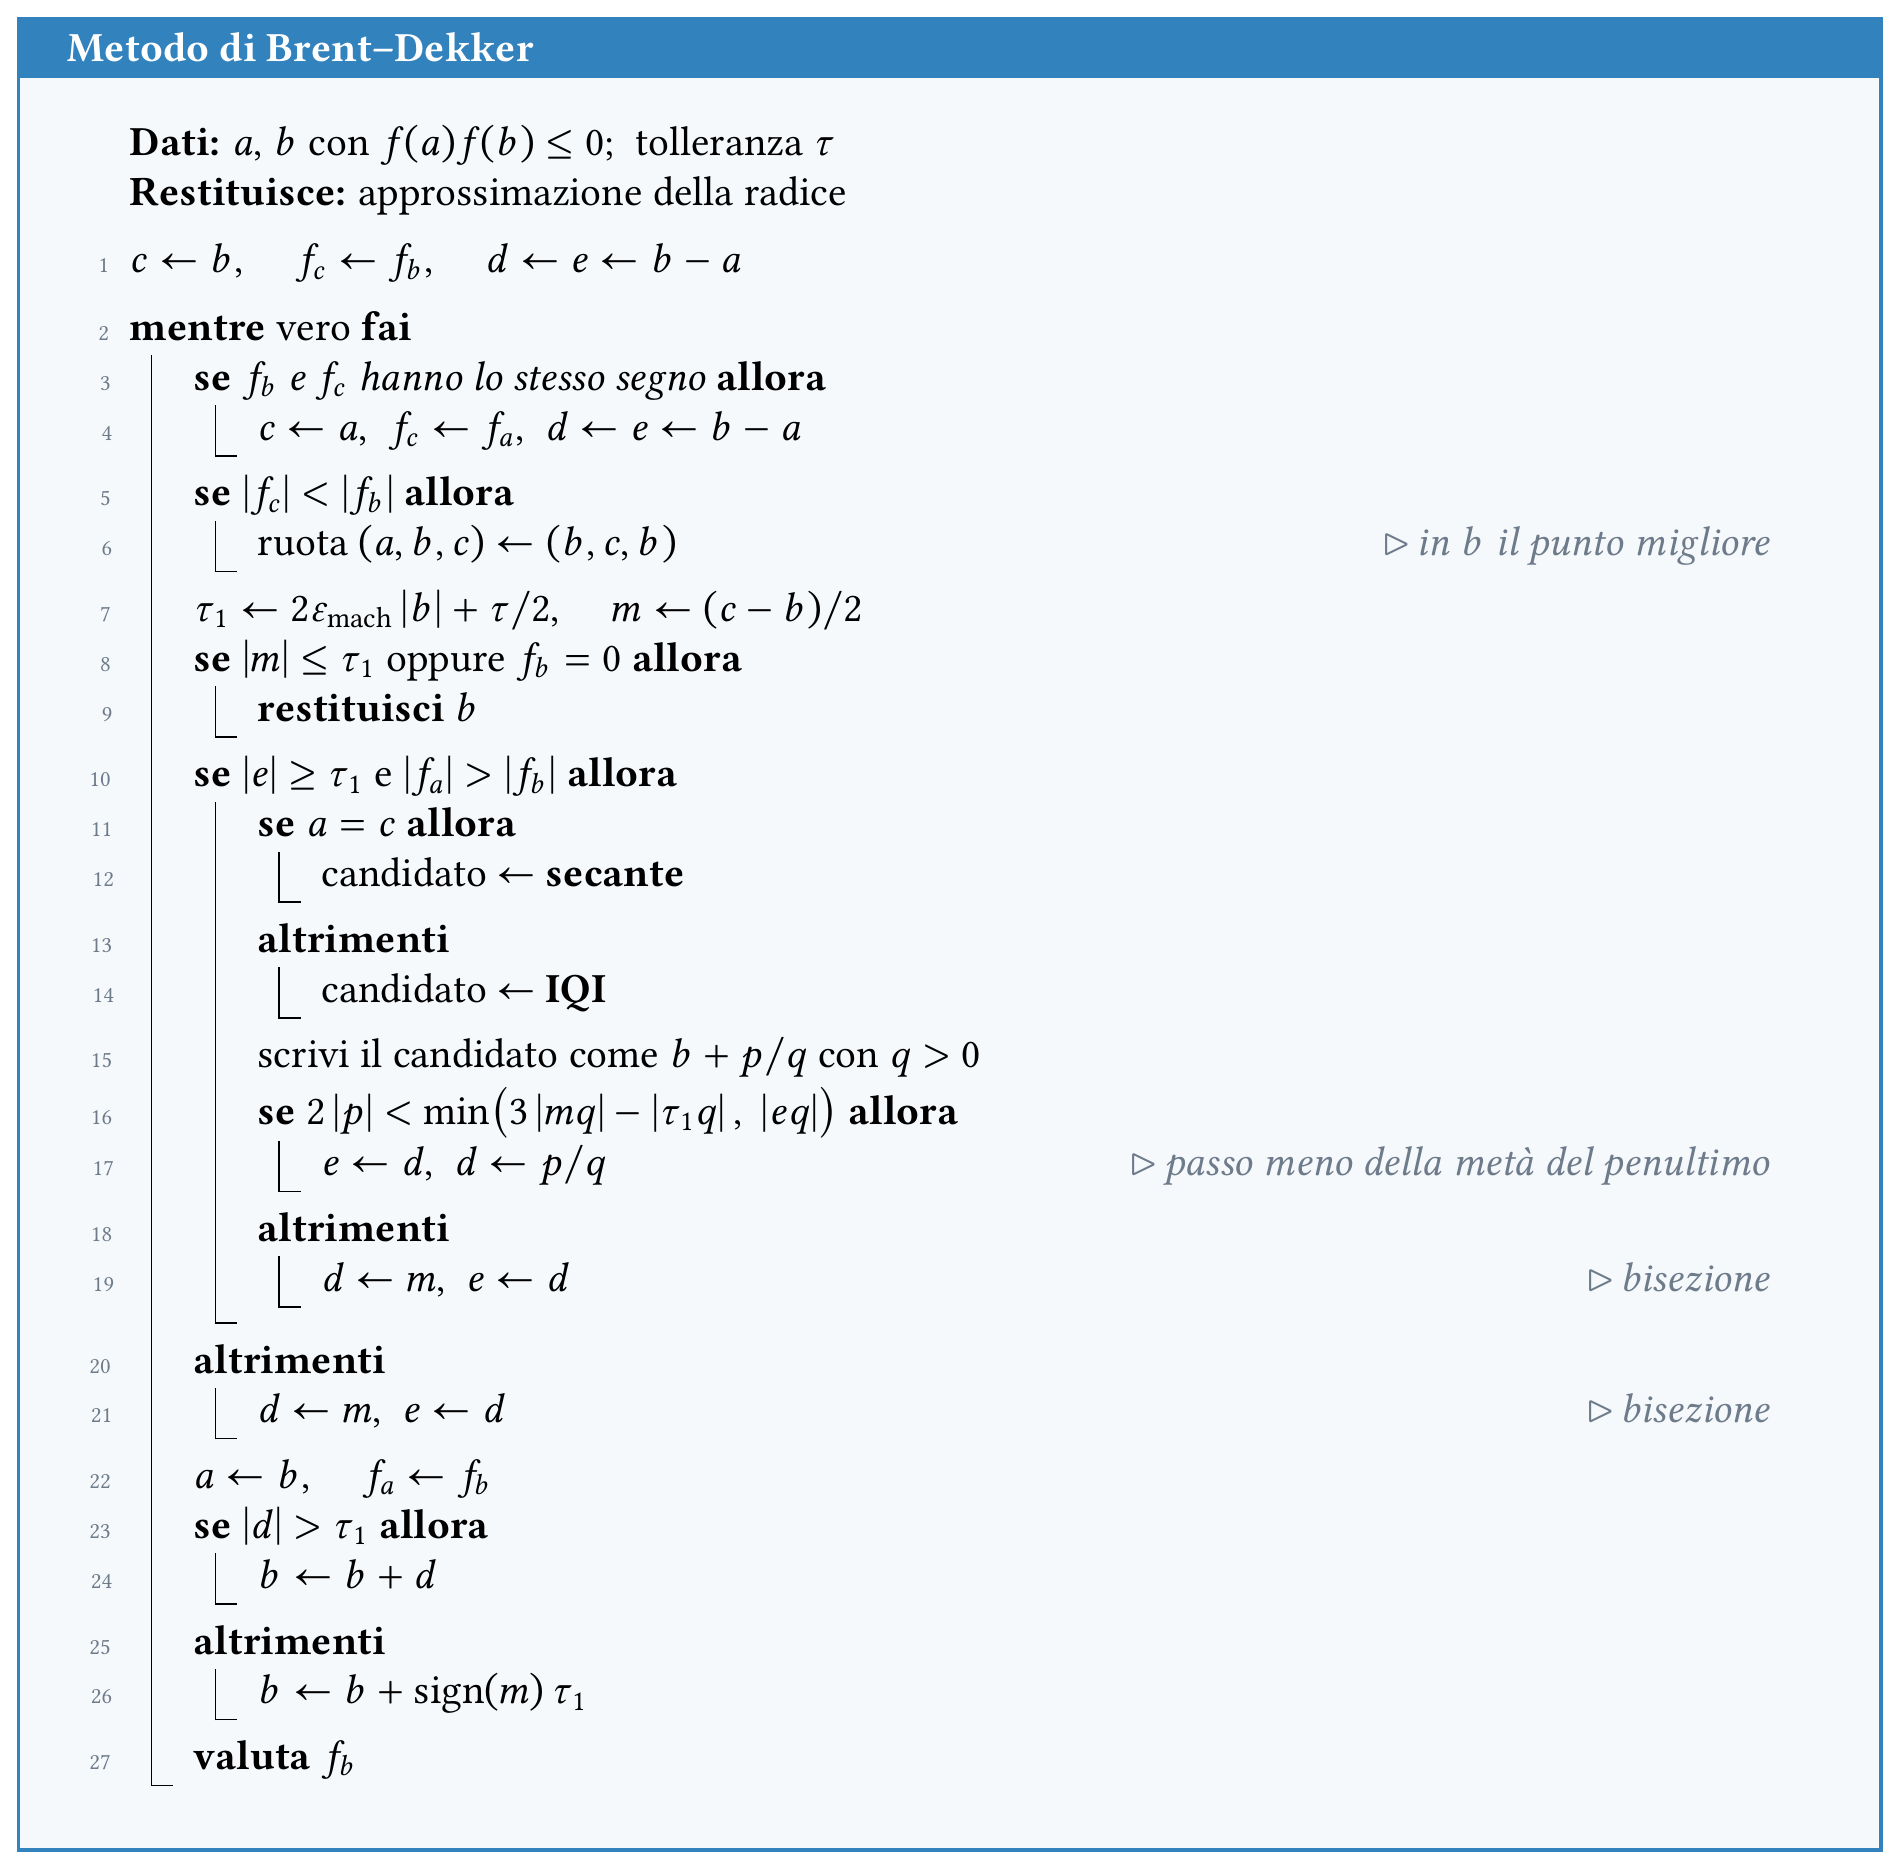
Brent [2] corregge il punto debole di Dekker in due modi: sostituisce la secante con un’interpolazione di grado più alto, e introduce un test di progresso che impedisce le sequenze di passi inutilmente piccoli. È l’algoritmo alla base di uniroot in R, di brentq in SciPy e della routine zeroin della maggior parte delle librerie numeriche; una variante con garanzie migliori è analizzata in [3].
Come funziona
L’interpolazione quadratica inversa (IQI). Dati tre punti distinti a,b,c con valori di f a due a due distinti, invece di interpolare y=f(x) con una parabola — che potrebbe non intersecare l’asse x — si interpola la funzione inversa x=f^{-1}(y), che vicino a una radice semplice è regolare e ben definita:
P(y)=\sum_{j\in\{a,b,c\}}x_j \prod_{\substack{\ell\in\{a,b,c\}\\\ell\ne j}} \frac{y-f(x_\ell)}{f(x_j)-f(x_\ell)},\qquad s=P(0).
Valutare l’interpolante in y=0 dà direttamente una stima di f^{-1}(0)=\alpha. Il candidato esiste sempre, senza radici quadrate e senza casi degeneri, purché i tre valori di f siano distinti; se non lo sono si ripiega sulla secante.
Il test di progresso. È la vera novità rispetto a Dekker. Detta e la lunghezza del passo penultimo e d quella del passo precedente, il candidato interpolatorio s=b+p/q viene accettato solo se soddisfa entrambe le condizioni
2\left\lvert p\right\rvert < 3\,\left\lvert m\,q\right\rvert - \left\lvert\tau_1 q\right\rvert \qquad\text{e}\qquad 2\left\lvert p\right\rvert < \left\lvert e\,q\right\rvert,
dove m=(c-b)/2 è il semipasso di bisezione e \tau_1=2\varepsilon_{\rm mach}\left\lvert b\right\rvert+\tau/2. La prima impone di restare ragionevolmente dentro il bracket; la seconda, che è quella decisiva, impone che ogni passo sia meno della metà del penultimo. Una successione di passi interpolatori che si accorciano troppo lentamente viene così interrotta da una bisezione, e questo garantisce che l’ampiezza del bracket si dimezzi almeno ogni due iterazioni.
Il risultato è un algoritmo che nel caso peggiore richiede al più circa il quadrato del numero di valutazioni della bisezione, e che su funzioni regolari converge superlinearmente: la combinazione che ne ha fatto lo standard di fatto.
Esempio numerico
brent <- function(f, x1, x2, tol = 1e-12, nmax = 60) {
  a <- x1; b <- x2; c <- x2
  fa <- f(a); fb <- f(b); fc <- fb
  if (fa*fb > 0) stop("gli estremi non racchiudono una radice")
  d <- 0; e <- 0; st <- data.frame()
  for (k in 1:nmax) {
    if (fb*fc > 0) { c<-a; fc<-fa; d<-b-a; e<-d }        # c = contropunto
    if (abs(fc) < abs(fb)) { a<-b;b<-c;c<-a; fa<-fb;fb<-fc;fc<-fa }
    tol1 <- 2*EPS*abs(b) + 0.5*tol
    xm   <- 0.5*(c-b)
    if (abs(xm) <= tol1 || fb == 0) {
      st <- rbind(st, data.frame(k=k,tipo="arresto",x=b,fx=fb,
                                 err=abs(b-alpha),amp=abs(c-b))); break
    }
    tipo <- "bisezione"
    if (abs(e) >= tol1 && abs(fa) > abs(fb)) {
      s <- fb/fa
      if (a == c) {                                      # solo due punti: secante
        p <- 2*xm*s; q <- 1 - s; tipo <- "secante"
      } else {                                           # tre punti distinti: IQI
        q <- fa/fc; r <- fb/fc
        p <- s*(2*xm*q*(q-r) - (b-a)*(r-1))
        q <- (q-1)*(r-1)*(s-1); tipo <- "IQI"
      }
      if (p > 0) q <- -q
      p <- abs(p)
      min1 <- 3*xm*q - abs(tol1*q); min2 <- abs(e*q)
      if (2*p < min(min1, min2)) { e <- d; d <- p/q }     # candidato accettato
      else { d <- xm; e <- d; tipo <- "bisezione" }       # test di progresso fallito
    } else { d <- xm; e <- d }
    a <- b; fa <- fb
    b  <- b + if (abs(d) > tol1) d else sign(xm)*tol1
    fb <- f(b)
    st <- rbind(st, data.frame(k=k,tipo=tipo,x=b,fx=fb,
                               err=abs(b-alpha),amp=abs(c-b)))
  }
  st
}

tabella(brent(f, 2, 3), "Metodo di Brent--Dekker su $x^3-2x-5$, $[2,3]$")| k | passo | x_k | f(x_k) | \lvert x_k-\alpha\rvert | b-a |
|---|---|---|---|---|---|
| 1 | secante | 2.058823529412 | -3.91e-01 | 3.57e-02 | 9.41e-01 |
| 2 | IQI | 2.095658932291 | 1.24e-02 | 1.11e-03 | 9.04e-01 |
| 3 | secante | 2.094528891117 | -2.52e-04 | 2.26e-05 | 3.57e-02 |
| 4 | secante | 2.094551467464 | -1.57e-07 | 1.41e-08 | 1.11e-03 |
| 5 | IQI | 2.094551481542 | 3.55e-15 | 4.44e-16 | 1.11e-03 |
| 6 | secante | 2.094551481542 | -5.59e-12 | 5.00e-13 | 1.41e-08 |
| 7 | arresto | 2.094551481542 | 3.55e-15 | 4.44e-16 | 5.01e-13 |
Si riconoscono i tre tipi di passo che l’algoritmo alterna. Il primo è necessariamente una secante, perché servono tre punti distinti per l’IQI; da lì in poi Brent usa l’IQI quando ha tre valori distinti e la secante altrimenti, senza mai dover ricorrere alla bisezione su questo problema.
22.4 Metodo di Ridders
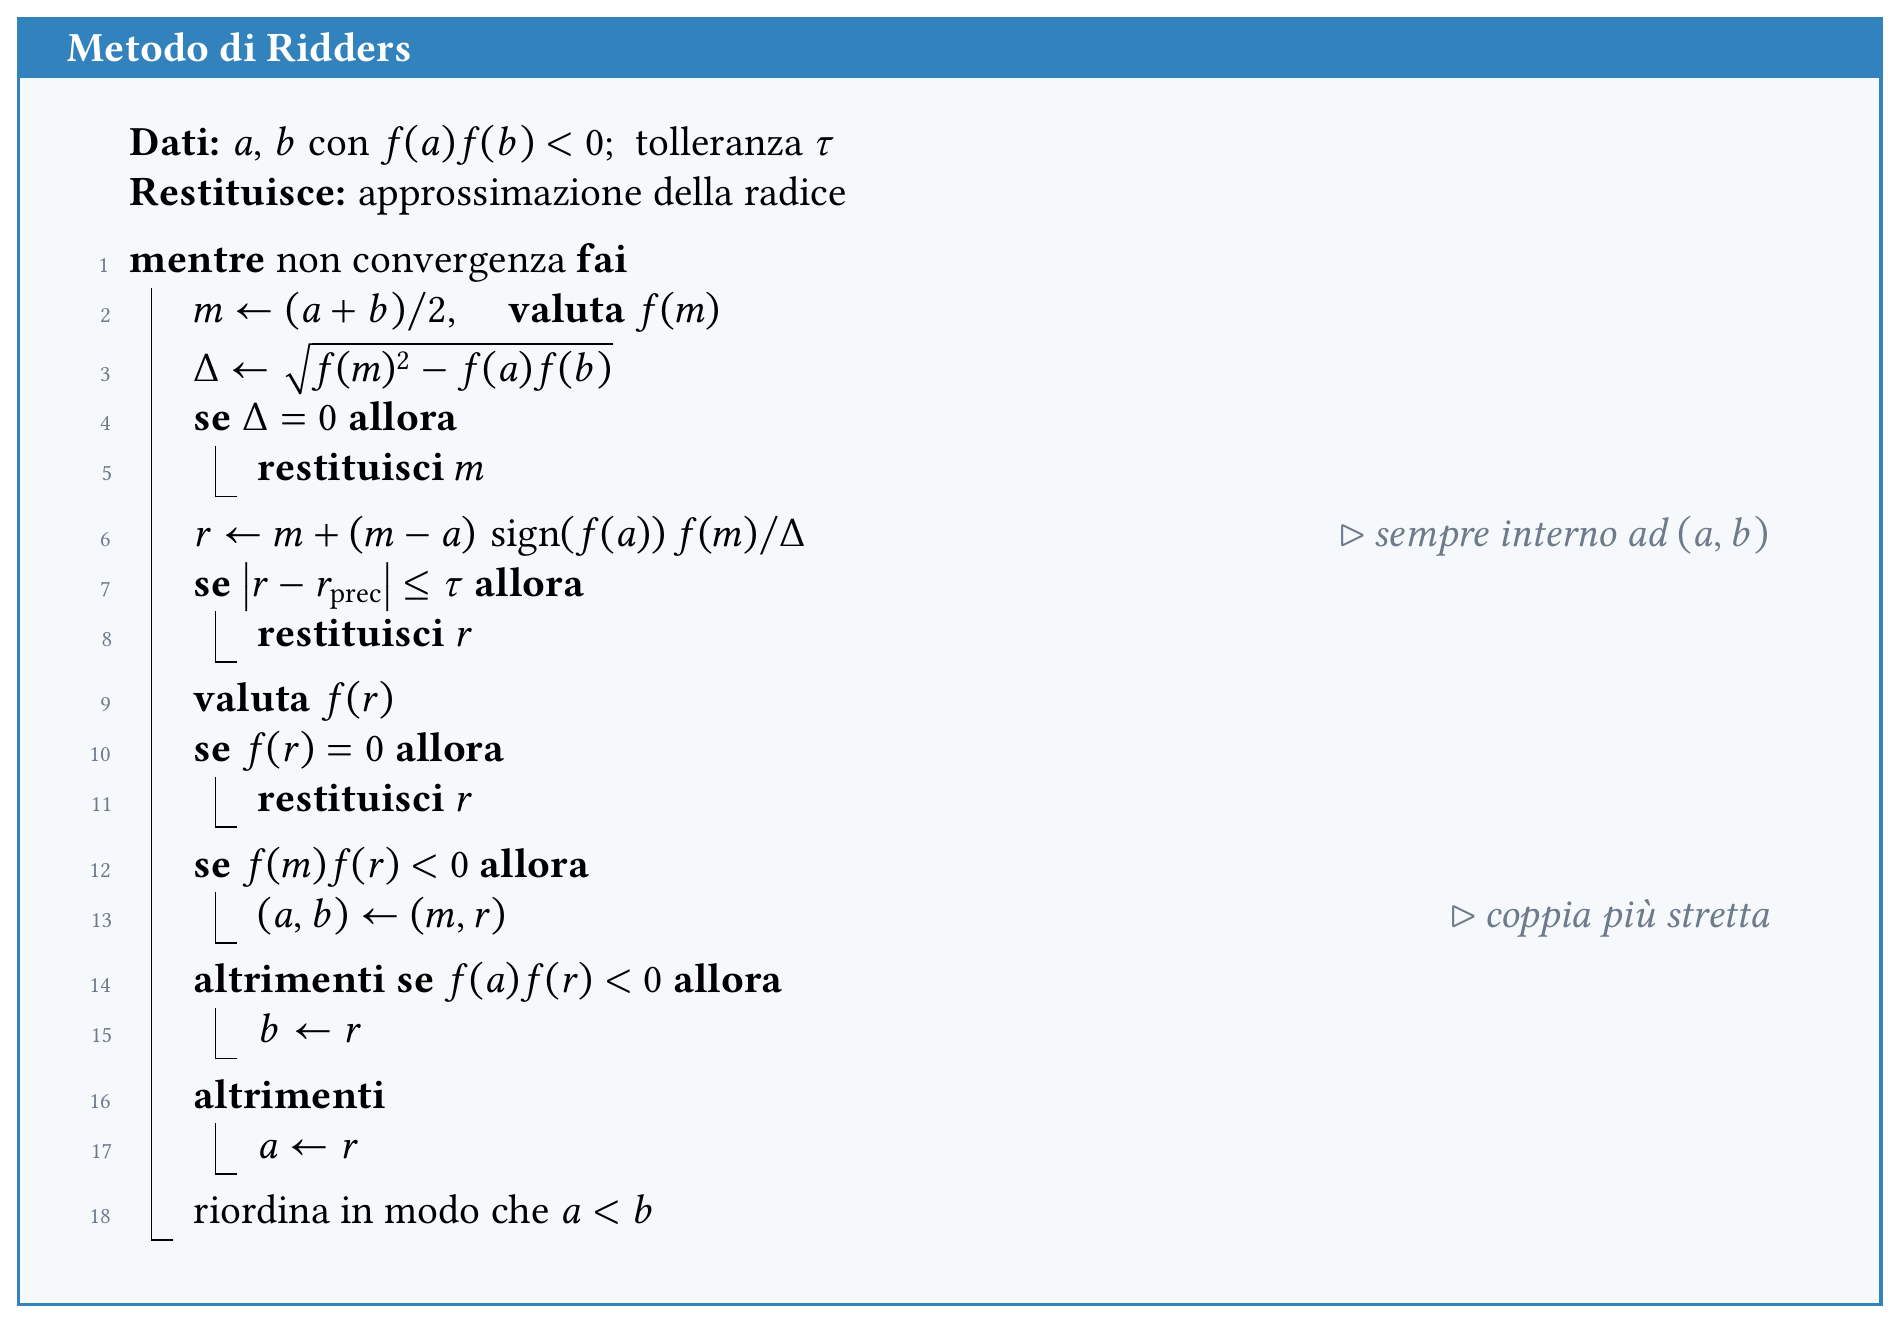
Ridders [9] ottiene la salvaguardia in un modo completamente diverso: non serve nessun test di ammissibilità, perché il candidato cade automaticamente dentro il bracket. È il motivo per cui l’algoritmo sta in poche righe e non ha casi particolari.
Come funziona
L’idea è di trasformare la funzione in modo da renderla localmente lineare. Dato [a,b] si valuta il punto medio m=(a+b)/2 e si cerca un fattore e^{Q} tale che i tre punti
\bigl(a,\;f(a)e^{-Q}\bigr),\qquad \bigl(m,\;f(m)\bigr),\qquad \bigl(b,\;f(b)e^{Q}\bigr)
siano allineati. Imponendo l’allineamento si ottiene un’equazione di secondo grado in e^{Q} la cui soluzione, sostituita nello zero della retta, dà il candidato in forma chiusa:
\Delta=\sqrt{f(m)^2-f(a)f(b)},\qquad r=m+(m-a)\frac{\operatorname{sign}(f(a))\,f(m)}{\Delta}.
Due osservazioni rendono il metodo elegante.
- Il candidato è sempre interno. Se f(a)f(b)<0 allora -f(a)f(b)>0 e quindi \Delta>\left\lvert f(m)\right\rvert: il fattore moltiplicativo f(m)/\Delta ha modulo minore di 1 e r dista da m meno di \left\lvert m-a\right\rvert, cioè resta in (a,b). Non serve verificare nulla.
- Il segno. Poiché per ipotesi f(a) e f(b) hanno segno opposto, si ha \operatorname{sign}(f(a))=\operatorname{sign}(f(a)-f(b)), che è la forma in cui la regola compare di solito in letteratura.
Dopo aver valutato f(r) si dispone di quattro punti a<m<b e r, e si sceglie come nuovo bracket la coppia più stretta con cambio di segno: (m,r) se f(m)f(r)<0, altrimenti (a,r) o (r,b) secondo il segno.
Il prezzo è che ogni iterazione richiede due nuove valutazioni di f (in m e in r). In cambio l’ordine per iterazione è 2, cioè \sqrt2\approx1.414 per valutazione: la stessa efficienza del metodo di Newton (Sezione 21.1), ma senza derivate e con il bracket sempre conservato.
Una conseguenza visibile nelle tabelle: il bracket di Ridders si dimezza soltanto, perché uno dei due estremi è sempre il punto medio. L’accuratezza non sta nell’ampiezza dell’intervallo ma nell’iterata r, e per questo il criterio d’arresto naturale è \left\lvert r_k-r_{k-1}\right\rvert\le\tau e non b-a\le\tau.
Esempio numerico
ridders <- function(f, a, b, tol = 1e-12, nmax = 60) {
  fa <- f(a); fb <- f(b)
  if (fa*fb > 0) stop("gli estremi non racchiudono una radice")
  ans <- NA; st <- data.frame()
  for (k in 1:nmax) {
    m  <- 0.5*(a+b); fm <- f(m)
    dd <- sqrt(fm^2 - fa*fb)
    if (dd == 0) break
    r <- m + (m-a)*sign(fa-fb)*fm/dd          # sempre interno ad (a,b)
    if (!is.na(ans) && abs(r-ans) <= tol) break
    ans <- r; fr <- f(r)
    if (fm*fr < 0)      { a<-m; fa<-fm; b<-r; fb<-fr }   # coppia piu' stretta
    else if (fa*fr < 0) { b<-r; fb<-fr }
    else                { a<-r; fa<-fr }
    if (a > b) { t<-a;a<-b;b<-t; t<-fa;fa<-fb;fb<-t }
    st <- rbind(st, data.frame(k=k, tipo="esponenziale", x=r, fx=fr,
                               err=abs(r-alpha), amp=b-a))
    if (fr == 0) break
  }
  st
}

tabella(ridders(f, 2, 3), "Metodo di Ridders su $x^3-2x-5$, $[2,3]$")| k | passo | x_k | f(x_k) | \lvert x_k-\alpha\rvert | b-a |
|---|---|---|---|---|---|
| 1 | esponenziale | 2.092522337716 | -2.26e-02 | 2.03e-03 | 4.07e-01 |
| 2 | esponenziale | 2.094540948859 | -1.18e-04 | 1.05e-05 | 2.02e-01 |
| 3 | esponenziale | 2.094551467368 | -1.58e-07 | 1.42e-08 | 1.01e-01 |
| 4 | esponenziale | 2.094551481537 | -5.43e-11 | 4.87e-12 | 5.04e-02 |
| 5 | esponenziale | 2.094551481542 | -7.11e-15 | 4.44e-16 | 2.52e-02 |
Cinque iterazioni (dieci valutazioni di f) portano alla precisione di macchina. Si noti la colonna b-a: si dimezza esattamente a ogni passo, come previsto, mentre l’errore cala molto più in fretta.
22.5 Metodo TOMS 748 (Alefeld–Potra–Shi)
L’algoritmo 748 della collezione ACM TOMS [1] è, fra quelli senza derivate, quello con le garanzie teoriche più forti. L’idea è di spingere l’interpolazione inversa fino al grado tre e di organizzare il lavoro in cicli che contengono più valutazioni, al termine dei quali una contrazione protetta garantisce la riduzione dell’intervallo.
Come funziona
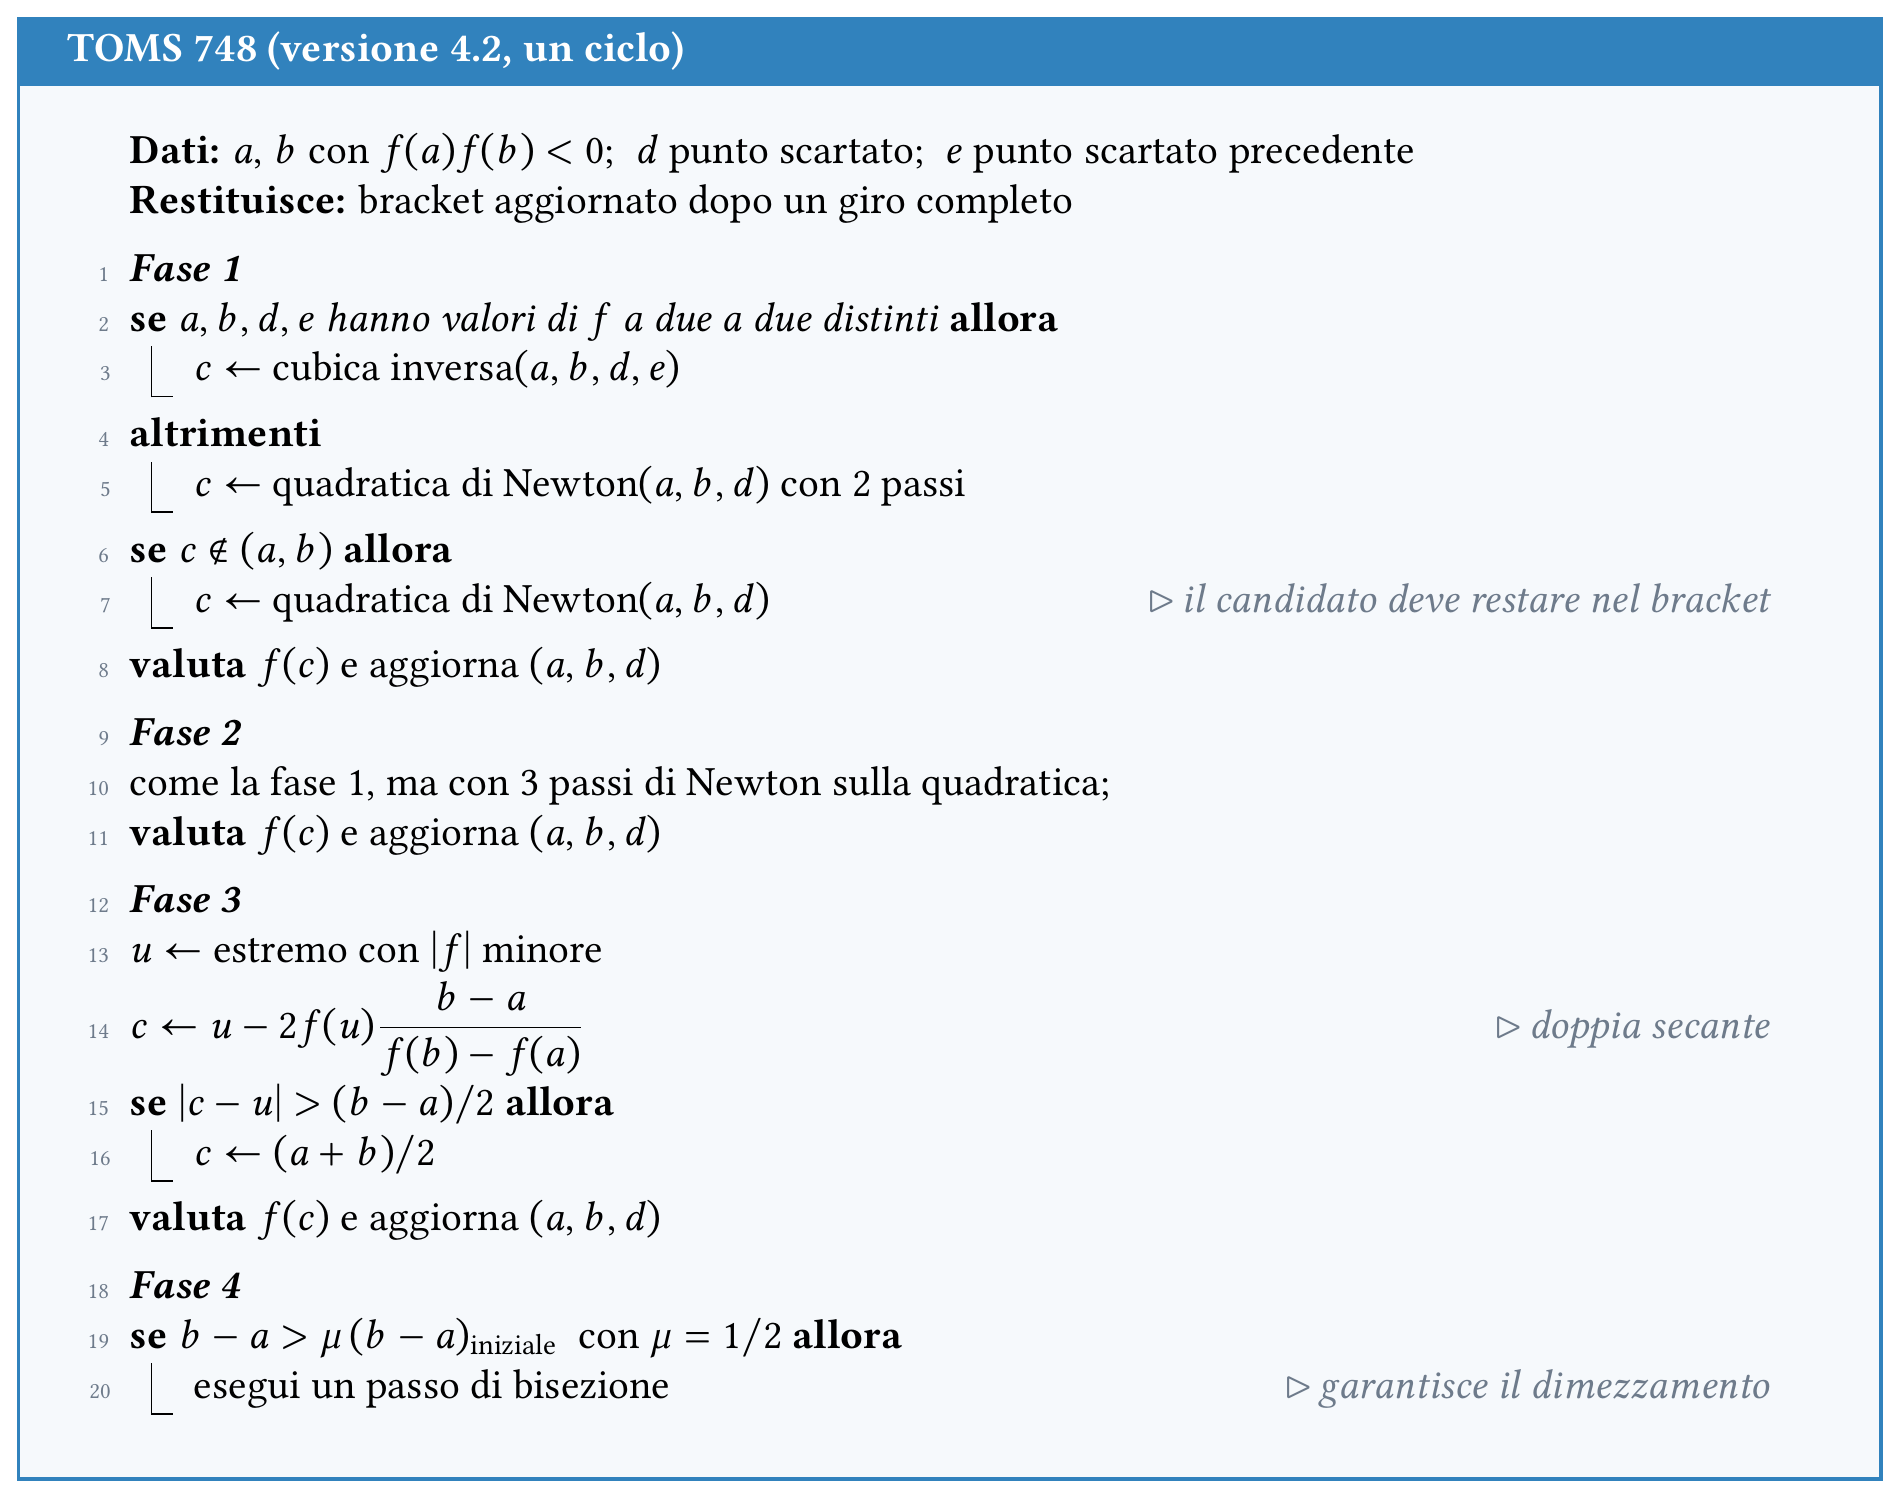
Un ciclo dell’algoritmo 4.2 della memoria originale si compone di quattro fasi.
Prima interpolazione. Con i punti a,b e un terzo punto d (l’estremo scartato al passo precedente) si costruisce la quadratica di Newton: il polinomio di secondo grado che interpola f nei tre punti, di cui si cerca lo zero con due passi di Newton partendo dall’estremo opportuno. Se sono disponibili quattro punti a,b,d,e con valori di f distinti si usa invece l’interpolazione cubica inversa
s=\sum_{j=0}^{3}x_j\prod_{\substack{\ell=0\\\ell\ne j}}^{3}\frac{-f_\ell}{f_j-f_\ell}.
Seconda interpolazione. Dopo aver aggiornato il bracket si ripete, questa volta con tre passi di Newton sulla quadratica (o di nuovo con la cubica inversa). Due interpolazioni consecutive per ciclo sono ciò che fa salire l’ordine.
Secante di lunghezza doppia. Detto u l’estremo con \left\lvert f\right\rvert minore, si propone
c = u - 2f(u)\,\frac{b-a}{f(b)-f(a)} ,
cioè un passo di secante raddoppiato, pensato per saltare oltre la radice e ribaltare il bracket; se \left\lvert c-u\right\rvert>(b-a)/2 si usa il punto medio.
Contrazione garantita. Se al termine delle tre fasi l’intervallo non si è ridotto almeno di un fattore \mu=1/2 rispetto all’inizio del ciclo, si esegue un passo di bisezione. È questa la salvaguardia che rende l’algoritmo robusto.
Gli autori dimostrano per l’algoritmo 4.2 un R-ordine almeno 2+\sqrt7\approx4.65 con asintoticamente tre valutazioni per ciclo, cioè un’efficienza di 4.65^{1/3}\approx1.67; la variante più semplice 4.1 ha R-ordine 1+\sqrt3\approx2.73 con due valutazioni, cioè 2.73^{1/2}\approx1.65. Sono i valori più alti fra i metodi senza derivate di questo capitolo. Va però sottolineato che non basta applicare ripetutamente la sola formula cubica per ottenere TOMS 748: sono i test di ammissibilità e la contrazione protetta a fare la differenza.
Esempio numerico
toms748 <- function(f, a, b, tol = 1e-12, nmax = 20) {
  bracket <- function(a,b,c,fa,fb) {          # valuta f(c) e aggiorna (a,b,d)
    if (!is.finite(c) || c <= a || c >= b) c <- 0.5*(a+b)
    fc <- f(c)
    if (fc == 0) return(list(a=c,b=c,d=c,fa=0,fb=0,fd=0))
    if (fa*fc < 0) list(a=a,b=c,d=b,fa=fa,fb=fc,fd=fb)
    else           list(a=c,b=b,d=a,fa=fc,fb=fb,fd=fa)
  }
  newton_quad <- function(a,b,d,fa,fb,fd,kk) {        # kk passi di Newton
    A1 <- (fb-fa)/(b-a); A2 <- ((fd-fb)/(d-b) - A1)/(d-a)
    if (!is.finite(A1) || A1 == 0) return(0.5*(a+b))
    if (!is.finite(A2) || A2 == 0) {
      r <- a - fa/A1
      return(if (!is.finite(r) || r <= a || r >= b) 0.5*(a+b) else r)
    }
    r <- if (A2*fa > 0) a else b
    for (i in 1:kk) {
      pr  <- fa + A1*(r-a) + A2*(r-a)*(r-b)
      dpr <- A1 + A2*(2*r - a - b)
      if (dpr == 0) return(0.5*(a+b))
      r <- r - pr/dpr
    }
    if (!is.finite(r) || r <= a || r >= b) 0.5*(a+b) else r
  }
  ipzero <- function(a,b,c,d,fa,fb,fc,fd) {           # cubica inversa
    q11<-(c-d)*fc/(fd-fc); q21<-(b-c)*fb/(fc-fb); q31<-(a-b)*fa/(fb-fa)
    d21<-(b-c)*fc/(fc-fb); d31<-(a-b)*fb/(fb-fa)
    q22<-(d21-q11)*fb/(fd-fb); d32<-(d31-q21)*fc/(fc-fa)
    q32<-d32; q33<-(d32-q22)*fa/(fd-fa)
    a + q31 + q32 + q33
  }
  fa <- f(a); fb <- f(b)
  if (fa*fb > 0) stop("gli estremi non racchiudono una radice")
  migliore <- function(a,b,fa,fb) if (abs(fa) < abs(fb)) c(a,fa) else c(b,fb)
  st <- data.frame()
  B <- bracket(a, b, a - fa*(b-a)/(fb-fa), fa, fb)     # passo iniziale: secante
  a<-B$a; b<-B$b; d<-B$d; fa<-B$fa; fb<-B$fb; fd<-B$fd
  mb <- migliore(a,b,fa,fb)
  st <- rbind(st, data.frame(k=1,tipo="secante",x=mb[1],fx=mb[2],
                             err=abs(mb[1]-alpha),amp=b-a))
  e <- NA; fe <- NA
  for (k in 2:nmax) {
    ab0 <- b - a
    for (passi in c(2,3)) {                            # fasi 1 e 2
      quattro <- !is.na(e) && length(unique(c(fa,fb,fd,fe))) == 4
      cc <- if (quattro) ipzero(a,b,d,e,fa,fb,fd,fe)
            else         newton_quad(a,b,d,fa,fb,fd,passi)
      if (!is.finite(cc) || cc <= a || cc >= b)
        cc <- newton_quad(a,b,d,fa,fb,fd,passi)
      if (passi == 2) { e<-d; fe<-fd }
      B <- bracket(a,b,cc,fa,fb); a<-B$a;b<-B$b;d<-B$d;fa<-B$fa;fb<-B$fb;fd<-B$fd
      if (b - a < tol) break
    }
    if (b - a < tol) {
      mb <- migliore(a,b,fa,fb)
      st <- rbind(st, data.frame(k=k,tipo="ciclo APS",x=mb[1],fx=mb[2],
                                 err=abs(mb[1]-alpha),amp=b-a))
      break
    }
    u  <- if (abs(fa) < abs(fb)) a  else b             # fase 3
    fu <- if (abs(fa) < abs(fb)) fa else fb
    cc <- u - 2*fu*(b-a)/(fb-fa)
    if (!is.finite(cc) || abs(cc-u) > 0.5*(b-a)) cc <- 0.5*(a+b)
    e<-d; fe<-fd
    B <- bracket(a,b,cc,fa,fb); a<-B$a;b<-B$b;d<-B$d;fa<-B$fa;fb<-B$fb;fd<-B$fd
    if ((b-a) > 0.5*ab0) {                             # fase 4: contrazione
      e<-d; fe<-fd
      B <- bracket(a,b,0.5*(a+b),fa,fb)
      a<-B$a;b<-B$b;d<-B$d;fa<-B$fa;fb<-B$fb;fd<-B$fd
    }
    mb <- migliore(a,b,fa,fb)
    st <- rbind(st, data.frame(k=k,tipo="ciclo APS",x=mb[1],fx=mb[2],
                               err=abs(mb[1]-alpha),amp=b-a))
    if (b-a < tol) break
  }
  st
}

tabella(toms748(f, 2, 3), "TOMS 748 su $x^3-2x-5$, $[2,3]$ (una riga per ciclo)")| k | passo | x_k | f(x_k) | \lvert x_k-\alpha\rvert | b-a |
|---|---|---|---|---|---|
| 1 | secante | 2.058823529412 | -3.91e-01 | 3.57e-02 | 9.41e-01 |
| 2 | ciclo APS | 2.103044127440 | 9.52e-02 | 8.49e-03 | 1.91e-02 |
| 3 | ciclo APS | 2.094601424679 | 5.57e-04 | 4.99e-05 | 9.99e-05 |
| 4 | ciclo APS | 2.094551481542 | -2.31e-12 | 2.07e-13 | 4.14e-13 |
Quattro cicli, dodici valutazioni di f in tutto. La colonna b-a mostra l’effetto della contrazione garantita: l’ampiezza del bracket crolla di diversi ordini di grandezza per ciclo, cosa che nessuno dei metodi precedenti riesce a fare.
22.6 Metodo di Chandrupatla
Chandrupatla [4] riprende l’interpolazione quadratica inversa di Brent ma la riscrive in coordinate normalizzate, ottenendo un test di ammissibilità sorprendentemente semplice.
Come funziona
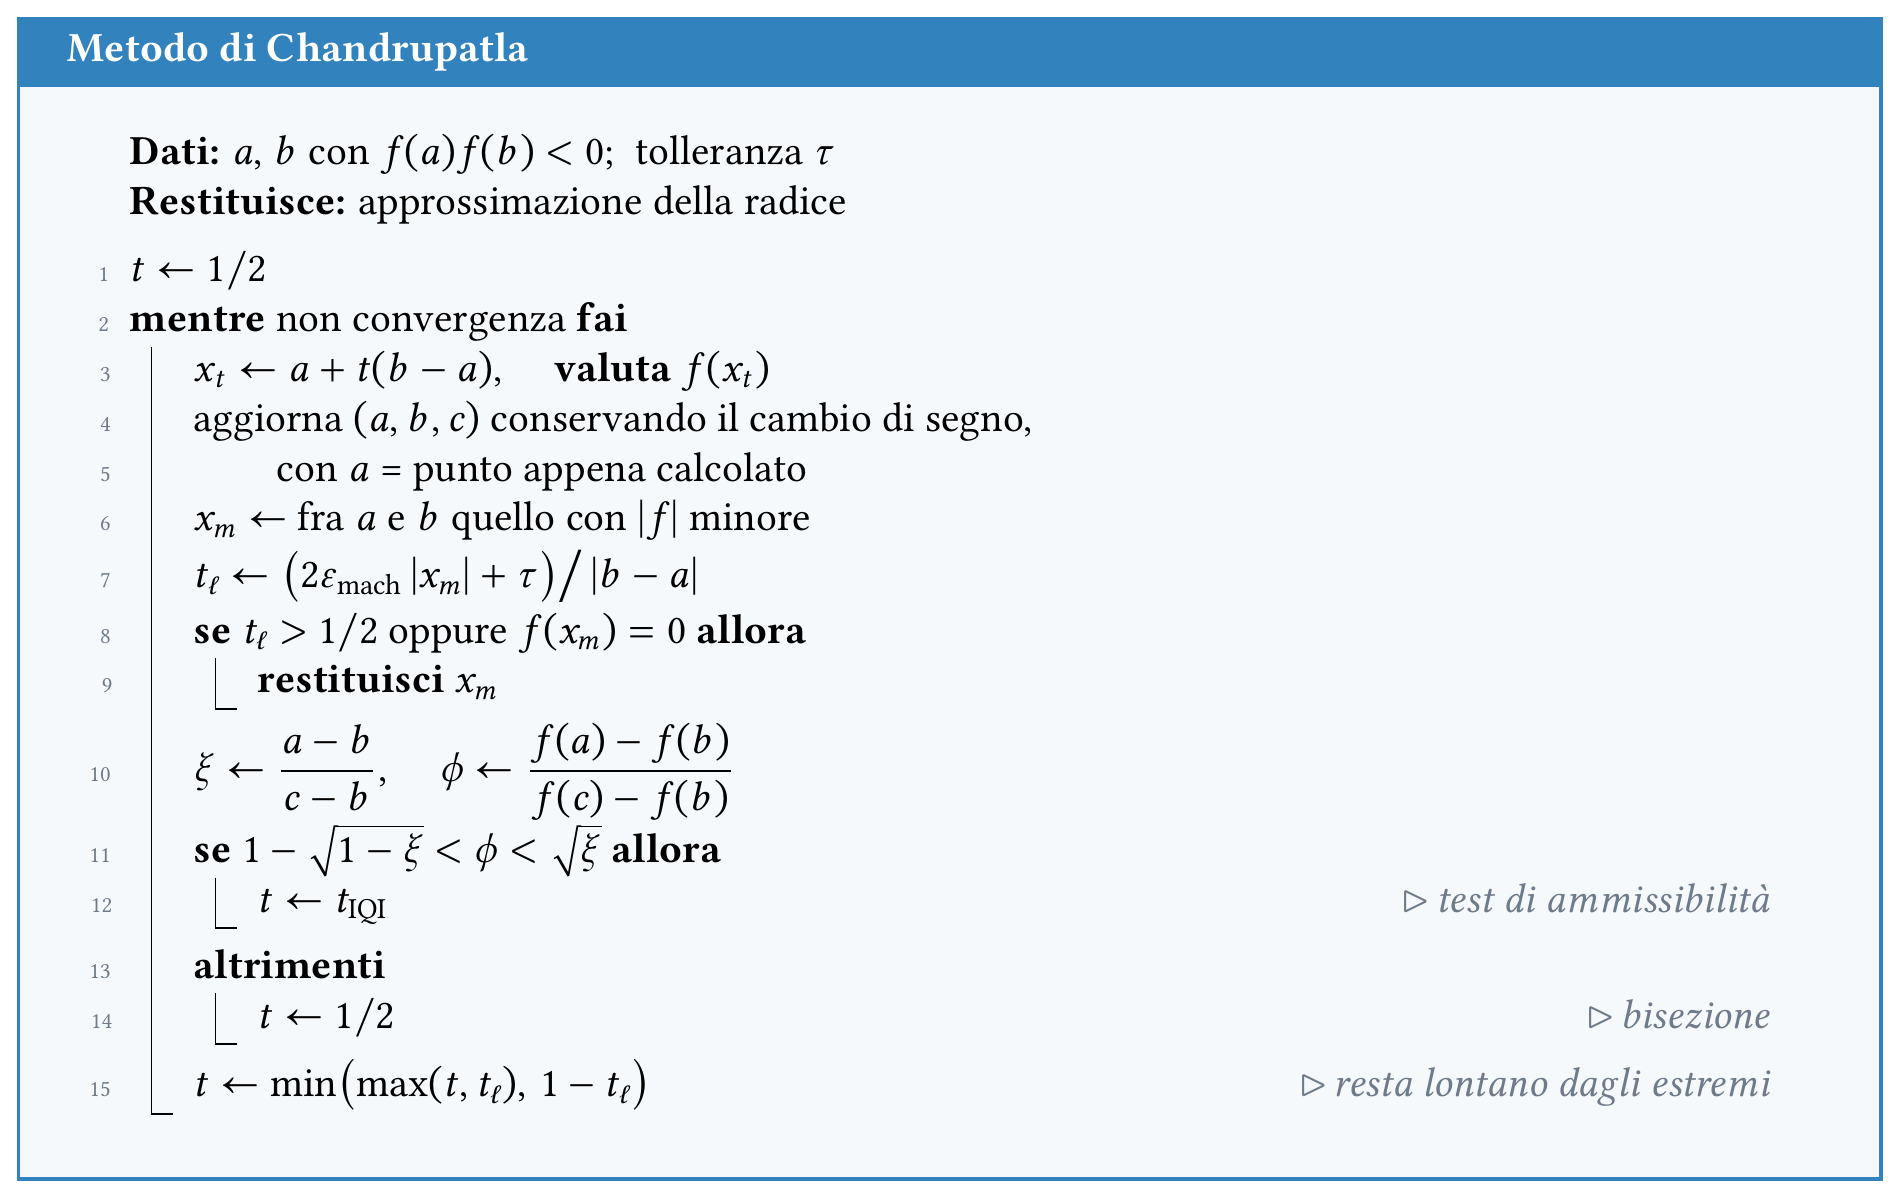
Si parametrizza il bracket con
x=a+t\,(b-a),\qquad 0<t<1,
cosicché il candidato è individuato dal solo numero t: verificare che cada dentro l’intervallo significa verificare 0<t<1, senza confronti fra numeri di scala diversa. Con tre punti a,b,c l’interpolazione quadratica inversa fornisce
t_{\rm IQI}= \frac{f(b)}{f(a)-f(b)}\cdot\frac{f(c)}{f(a)-f(c)} +\frac{c-a}{b-a}\cdot\frac{f(a)}{f(b)-f(a)}\cdot\frac{f(c)}{f(b)-f(c)} .
Il contributo originale è il criterio con cui si decide se fidarsi. Definite le due quantità adimensionali
\xi=\frac{a-b}{c-b},\qquad \phi=\frac{f(a)-f(b)}{f(c)-f(b)},
che misurano quanto la configurazione dei tre punti sia «geometricamente sana», l’IQI viene accettata solo se
1-\sqrt{1-\xi}\;<\;\phi\;<\;\sqrt{\xi},
altrimenti si pone t=1/2, cioè si bisseca. La condizione ha un’interpretazione diretta: \phi confronta le variazioni di f con le distanze \xi, e le due disuguaglianze delimitano la regione in cui la parabola inversa non è troppo distorta. Infine t viene comunque confinato in [t_\ell,1-t_\ell], con t_\ell proporzionale alla tolleranza, in modo che il nuovo punto non si incolli mai a un estremo.
Il metodo è senza derivate, usa una sola valutazione per iterazione e conserva il cambio di segno. Nei confronti sperimentali si comporta come Brent, e spesso un poco meglio, con un’implementazione molto più breve.
Esempio numerico
chandrupatla <- function(f, a, b, tol = 1e-12, nmax = 60) {
  fa <- f(a); fb <- f(b)
  if (fa*fb > 0) stop("gli estremi non racchiudono una radice")
  c <- a; fc <- fa; t <- 0.5; st <- data.frame()
  for (k in 1:nmax) {
    xt <- a + t*(b-a); ft <- f(xt)
    if (sign(ft) == sign(fa)) { c<-a; fc<-fa; a<-xt; fa<-ft }
    else { c<-b; fc<-fb; b<-a; fb<-fa; a<-xt; fa<-ft }
    if (abs(fa) < abs(fb)) { xm<-a; fm<-fa } else { xm<-b; fm<-fb }
    st <- rbind(st, data.frame(k=k, tipo=if (t==0.5) "bisezione" else "IQI",
                               x=xm, fx=fm, err=abs(xm-alpha), amp=abs(b-a)))
    tola <- 2*EPS*abs(xm) + tol
    tl   <- tola/abs(b-a)
    if (tl > 0.5 || fm == 0) break
    xi <- (a-b)/(c-b); phi <- (fa-fb)/(fc-fb)
    t  <- if (1 - sqrt(1-xi) < phi && phi < sqrt(xi))      # test di ammissibilita'
            fa/(fb-fa)*fc/(fb-fc) + (c-a)/(b-a)*fa/(fc-fa)*fb/(fc-fb)
          else 0.5
    t  <- min(max(t, tl), 1-tl)
  }
  st
}

tabella(chandrupatla(f, 2, 3), "Metodo di Chandrupatla su $x^3-2x-5$, $[2,3]$")| k | passo | x_k | f(x_k) | \lvert x_k-\alpha\rvert | b-a |
|---|---|---|---|---|---|
| 1 | bisezione | 2.000000000000 | -1.00e+00 | 9.46e-02 | 5.00e-01 |
| 2 | IQI | 2.084497813674 | -1.12e-01 | 1.01e-02 | 4.16e-01 |
| 3 | IQI | 2.094728156313 | 1.97e-03 | 1.77e-04 | 1.02e-02 |
| 4 | IQI | 2.094551168821 | -3.49e-06 | 3.13e-07 | 1.77e-04 |
| 5 | IQI | 2.094551481543 | 3.39e-12 | 3.04e-13 | 3.13e-07 |
| 6 | IQI | 2.094551481543 | 3.39e-12 | 3.04e-13 | 1.00e-12 |
Il primo passo è per forza una bisezione (t è inizializzato a 1/2 e non ci sono ancora tre punti); da lì in poi il test di ammissibilità è sempre superato e l’IQI porta alla precisione di macchina in cinque passi, con una sola valutazione ciascuno.
22.7 Metodo ITP (Interpolate–Truncate–Project)
ITP [7] è il più recente ed è l’unico che riesce a essere contemporaneamente superlineare sui problemi regolari e minmax-ottimale nel caso peggiore: non spende mai, nemmeno sulla funzione più ostile, più iterazioni della bisezione (a meno di un margine fissato dall’utente).
Come funziona
Il nome descrive le tre fasi di cui si compone ogni passo.
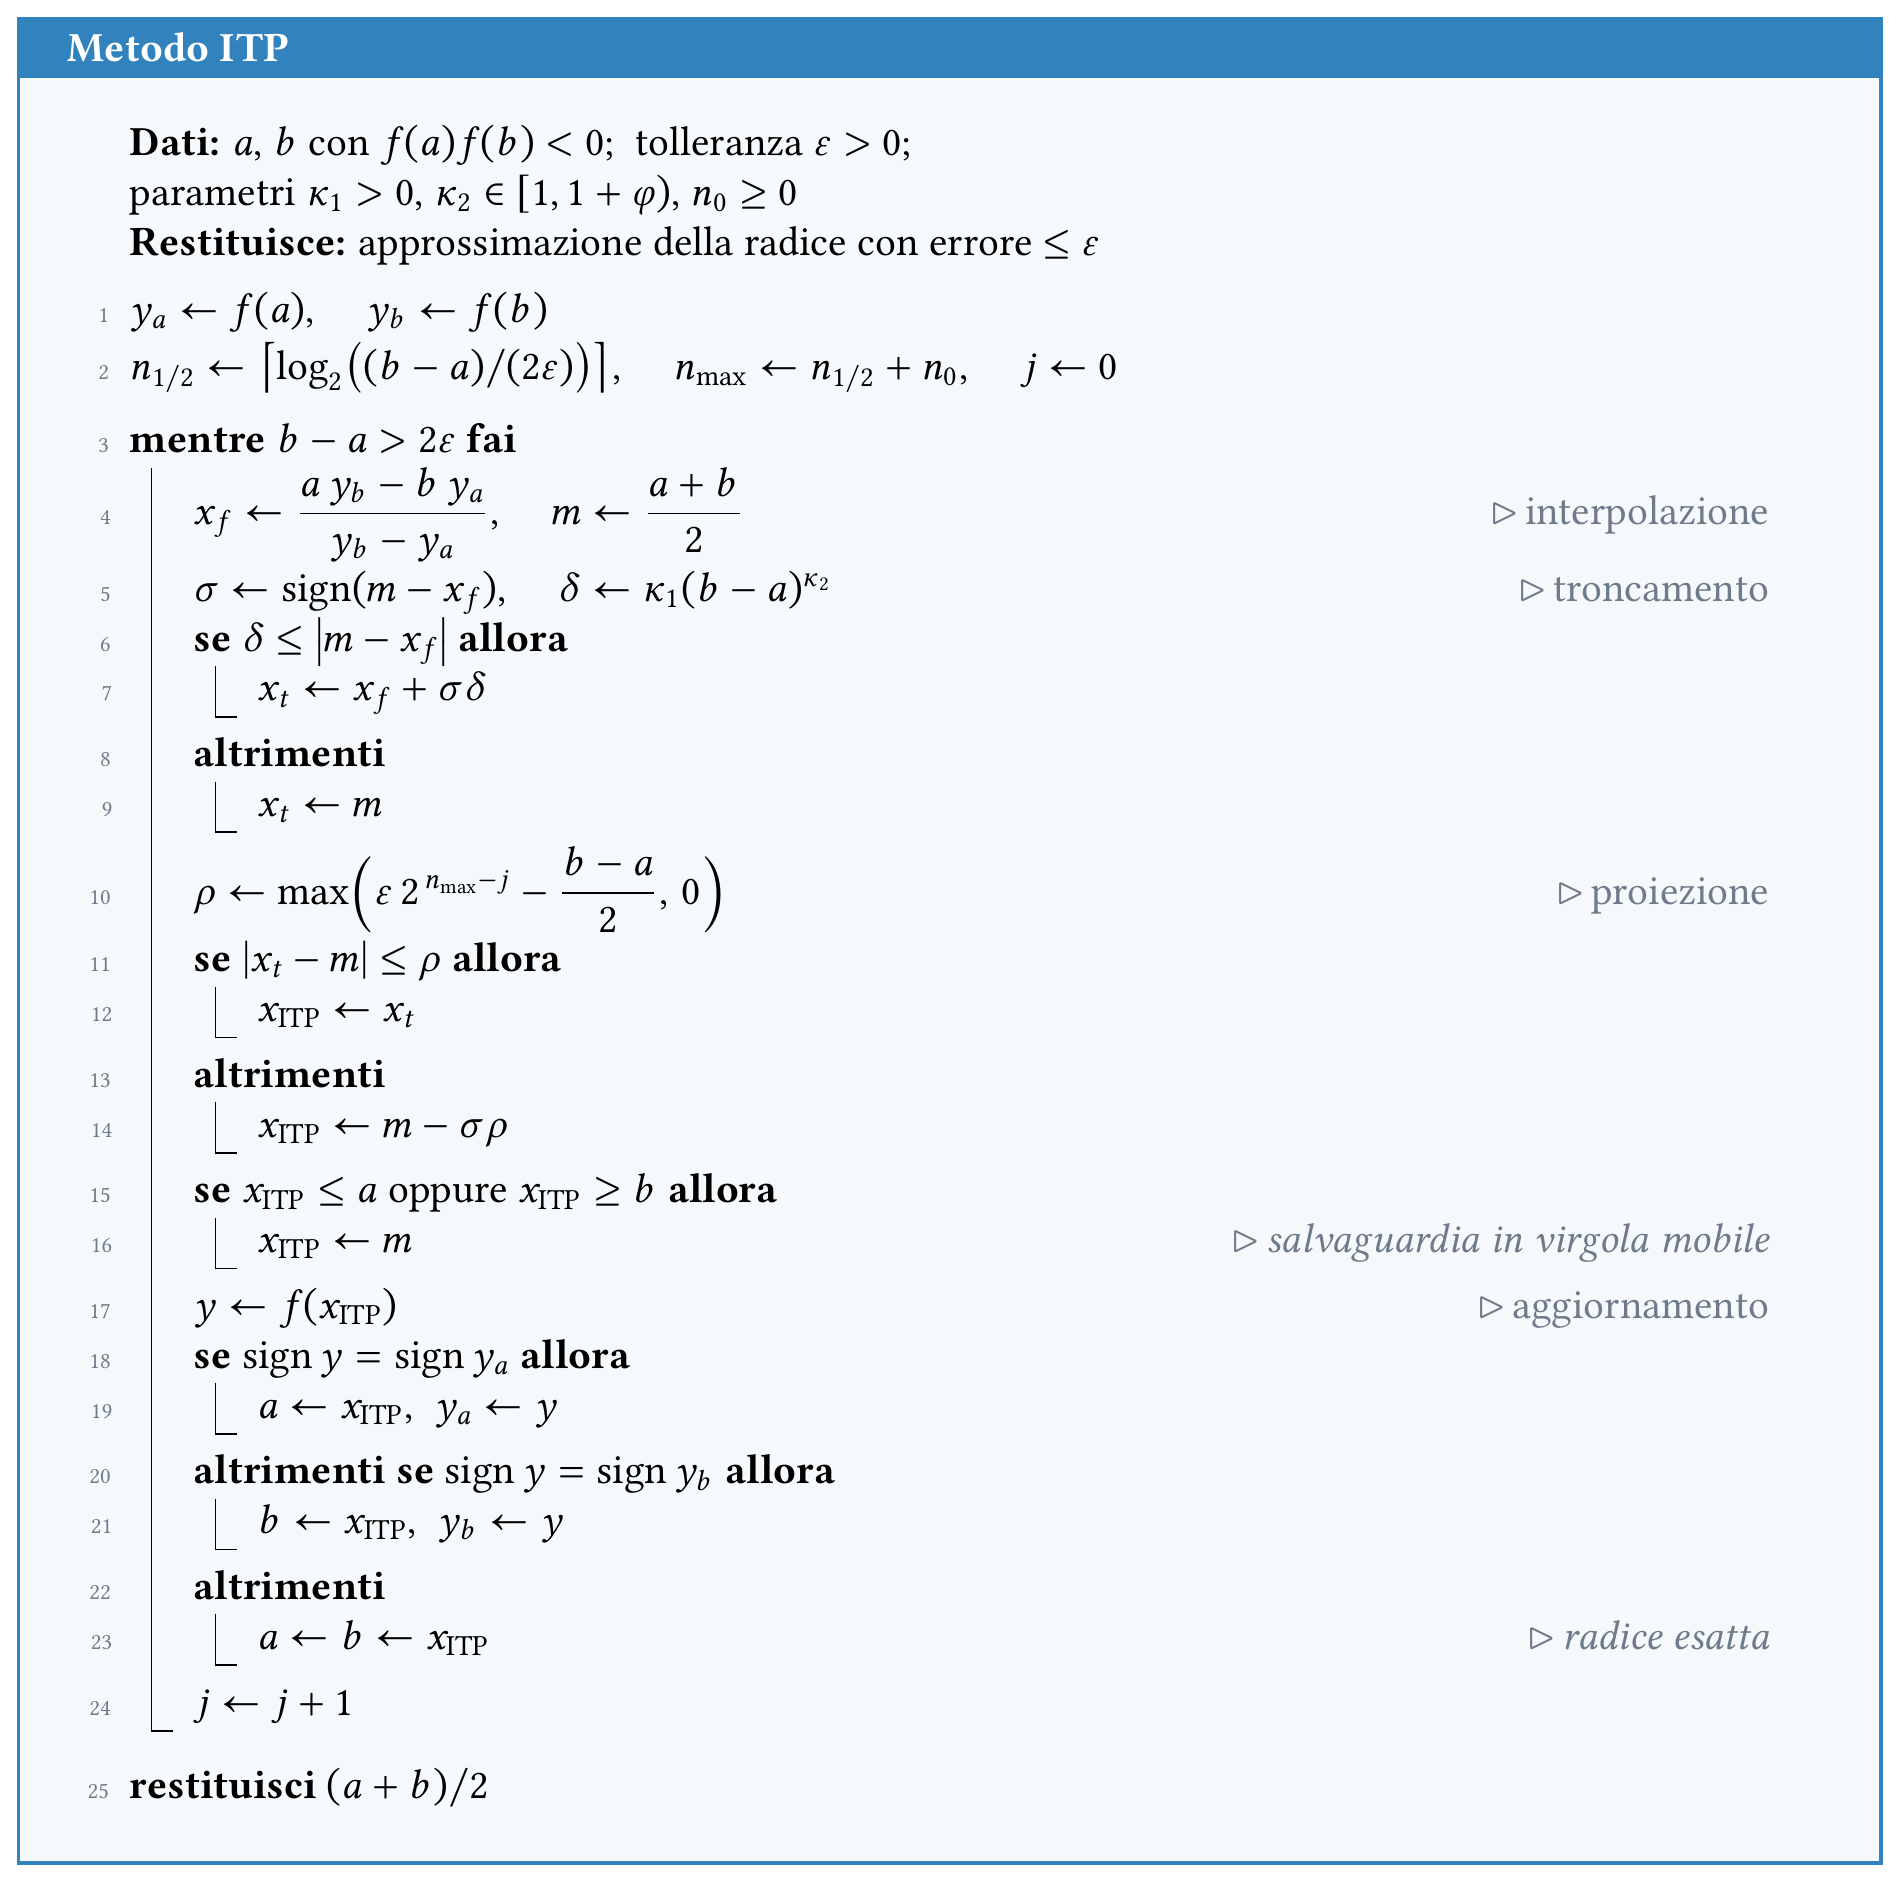
Interpolazione. Si parte dal candidato della falsa posizione e dal punto medio:
x_f=\frac{a f(b)-b f(a)}{f(b)-f(a)},\qquad m=\frac{a+b}{2}.
Troncamento. La falsa posizione ha il difetto noto di incollarsi a un estremo (Sezione 20.8). Lo si corregge spostando x_f verso il centro di una quantità \delta:
x_t=x_f+\sigma\min\{\delta,|m-x_f|\},\qquad \sigma=\operatorname{sign}(m-x_f),\qquad \delta=\kappa_1(b-a)^{\kappa_2}.
Il minimo impedisce di oltrepassare il punto medio. L’esponente \kappa_2 controlla quanto rapidamente il correttivo svanisce al restringersi dell’intervallo: con \kappa_2>1 la correzione diventa trascurabile vicino alla radice, e l’ordine superlineare della falsa posizione non viene distrutto.
Proiezione. È la fase che fornisce la garanzia. Si fissa
n_{1/2}=\Bigl\lceil\log_2\frac{b_0-a_0}{2\varepsilon}\Bigr\rceil,
il numero di passi che impiegherebbe la bisezione, e si concede uno slack di n_0\ge0 iterazioni in più. Detta j l’iterazione corrente, il raggio ammesso attorno al punto medio è
\rho_j=\max\Bigl\{\varepsilon\,2^{\,n_{1/2}+n_0-j}-\frac{b-a}{2},\;0\Bigr\},
e il candidato finale è il troncato proiettato su [m-\rho_j,\,m+\rho_j]:
x_{\rm ITP}=\begin{cases} x_t, & |x_t-m|\le\rho_j,\\[1mm] m-\sigma\rho_j, &\text{altrimenti.}\end{cases}
Il significato di \rho_j è un budget: misura di quanto l’algoritmo è in anticipo sulla tabella di marcia della bisezione. Finché l’interpolazione lavora bene il bracket si restringe più in fretta di 2^{-j}, il budget resta ampio e il candidato interpolatorio passa indisturbato; se invece l’interpolazione è inefficace il budget si azzera, \rho_j=0, e il candidato viene forzato nel punto medio. Da qui la garanzia: al più n_{1/2}+n_0 iterazioni, sempre.
I parametri raccomandati sono \kappa_1=0.2/(b_0-a_0), \kappa_2=2 e n_0=1. Una salvaguardia di aritmetica finita è necessaria in più: se il candidato arrotonda esattamente su un estremo, il bracket smetterebbe di restringersi, e in quel caso si usa il punto medio.
Esempio numerico
itp <- function(f, a, b, eps = 1e-12, k1 = NULL, k2 = 2, n0 = 1, nmax = 80) {
  ya <- f(a); yb <- f(b)
  if (ya*yb > 0) stop("gli estremi non racchiudono una radice")
  if (is.null(k1)) k1 <- 0.2/(b-a)
  n12    <- ceiling(log2((b-a)/(2*eps)))
  nmaxit <- n12 + n0
  j <- 0; st <- data.frame()
  while (b - a > 2*eps && j < nmax) {
    xf <- (a*yb - b*ya)/(yb - ya)                       # interpolazione
    m  <- 0.5*(a+b)
    sg <- sign(m - xf)
    dl <- k1*(b-a)^k2                                   # troncamento
    xt <- if (dl <= abs(m-xf)) xf + sg*dl else m
    r  <- max(eps*2^(nmaxit - j) - 0.5*(b-a), 0)        # proiezione
    xi <- if (abs(xt-m) <= r) xt else m - sg*r
    tipo <- if (abs(xt-m) <= r) {
              if (dl <= abs(m-xf)) "falsa pos. troncata" else "punto medio"
            } else "proiezione"
    if (xi <= a || xi >= b) { xi <- m; tipo <- "punto medio" }   # salvaguardia fp
    y <- f(xi)
    if (y*ya > 0) { a <- xi; ya <- y } else if (y*yb > 0) { b <- xi; yb <- y }
    else { a <- xi; b <- xi }
    j <- j + 1
    st <- rbind(st, data.frame(k=j, tipo=tipo, x=xi, fx=y,
                               err=abs(xi-alpha), amp=b-a))
  }
  st
}

tabella(itp(f, 2, 3), "Metodo ITP su $x^3-2x-5$, $[2,3]$")| k | passo | x_k | f(x_k) | \lvert x_k-\alpha\rvert | b-a |
|---|---|---|---|---|---|
| 1 | falsa pos. troncata | 2.258823529412 | 2.01e+00 | 1.64e-01 | 2.59e-01 |
| 2 | falsa pos. troncata | 2.099456956203 | 5.49e-02 | 4.91e-03 | 9.95e-02 |
| 3 | falsa pos. troncata | 2.092302285104 | -2.51e-02 | 2.25e-03 | 7.15e-03 |
| 4 | falsa pos. troncata | 2.094555514511 | 4.50e-05 | 4.03e-06 | 2.25e-03 |
| 5 | falsa pos. troncata | 2.094550461022 | -1.14e-05 | 1.02e-06 | 5.05e-06 |
| 6 | falsa pos. troncata | 2.094551481545 | 3.11e-11 | 2.79e-12 | 1.02e-06 |
| 7 | falsa pos. troncata | 2.094551481542 | -2.33e-12 | 2.08e-13 | 3.00e-12 |
| 8 | falsa pos. troncata | 2.094551481542 | -8.88e-16 | 0.00e+00 | 2.79e-12 |
| 9 | punto medio | 2.094551481544 | 1.56e-11 | 1.39e-12 | 1.39e-12 |
Su questo problema la falsa posizione troncata è sempre accettata e il budget non diventa mai vincolante: nove valutazioni portano alla precisione di macchina. Vedremo in Sezione 22.13 un caso opposto, in cui il budget si esaurisce e ITP si riduce di fatto alla bisezione — comportamento non brillante ma, per costruzione, mai peggiore di essa.
22.8 Gli ibridi con derivate: uno schema comune
I quattro metodi che seguono differiscono soltanto per la formula del candidato: condividono bracket, test di ammissibilità e criterio d’arresto. Conviene quindi scrivere una volta sola il driver e passargli il passo come argomento.
Il test di ammissibilità
Rispetto ai metodi senza derivate c’è una differenza importante: un passo di tipo Newton non restringe il bracket. Se tutte le iterate arrivano alla radice dallo stesso lato, uno dei due estremi non si muove mai, esattamente come nella regula falsi. Perciò qui non si può usare b-a\le\tau come criterio d’arresto: si usa l’incremento \left\lvert x_{k+1}-x_k\right\rvert, come nella classica routine rtsafe [8].
Il candidato c viene rifiutato in due casi:
- esce dal bracket, c<a oppure c>b: il modello locale sta mentendo, e accettare il passo significherebbe perdere la radice;
- progredisce troppo lentamente, \left\lvert c-x_k\right\rvert>\tfrac12\left\lvert x_k-x_{k-1}\right\rvert: il passo non dimezza nemmeno l’incremento precedente, quindi non sta facendo meglio di una bisezione e tanto vale eseguire quest’ultima, che almeno riduce l’intervallo.
In entrambi i casi si ripiega sul punto medio. Si noti che il confronto c<a, c>b è non stretto: dopo l’aggiornamento del bracket l’iterata corrente è uno degli estremi, e un test stretto rifiuterebbe sistematicamente il candidato una volta raggiunta la convergenza, degradando il metodo a bisezione proprio quando sta per finire.
ibrido <- function(f, passo, a, b, df = NULL, ddf = NULL, dddf = NULL,
                   tol = 1e-12, nmax = 60) {
  fa <- f(a); fb <- f(b)
  if (fa*fb > 0) stop("gli estremi non racchiudono una radice")
  amp0 <- b - a
  x <- 0.5*(a+b); fx <- f(x)
  if (sign(fx) == sign(fa)) { a<-x; fa<-fx } else { b<-x; fb<-fx }
  dxold <- amp0; dx <- dxold; st <- data.frame()
  for (k in 1:nmax) {
    cand  <- tryCatch(passo(x, f, df, ddf, dddf), error = function(e) NA)
    fuori <- !is.finite(cand) || cand < a || cand > b
    lento <- is.finite(cand) && abs(cand - x) > 0.5*abs(dxold)
    if (fuori || lento) { dxold<-dx; dx <- 0.5*(a+b) - x; tipo <- "bisezione" }
    else                { dxold<-dx; dx <- cand - x;      tipo <- "alto ordine" }
    x <- x + dx; fx <- f(x)
    if (sign(fx) == sign(fa)) { a<-x; fa<-fx } else { b<-x; fb<-fx }
    st <- rbind(st, data.frame(k=k, tipo=tipo, x=x, fx=fx,
                               err=abs(x-alpha), amp=b-a))
    if (abs(dx) <= tol*max(1,abs(x)) || fx == 0) break
  }
  st
}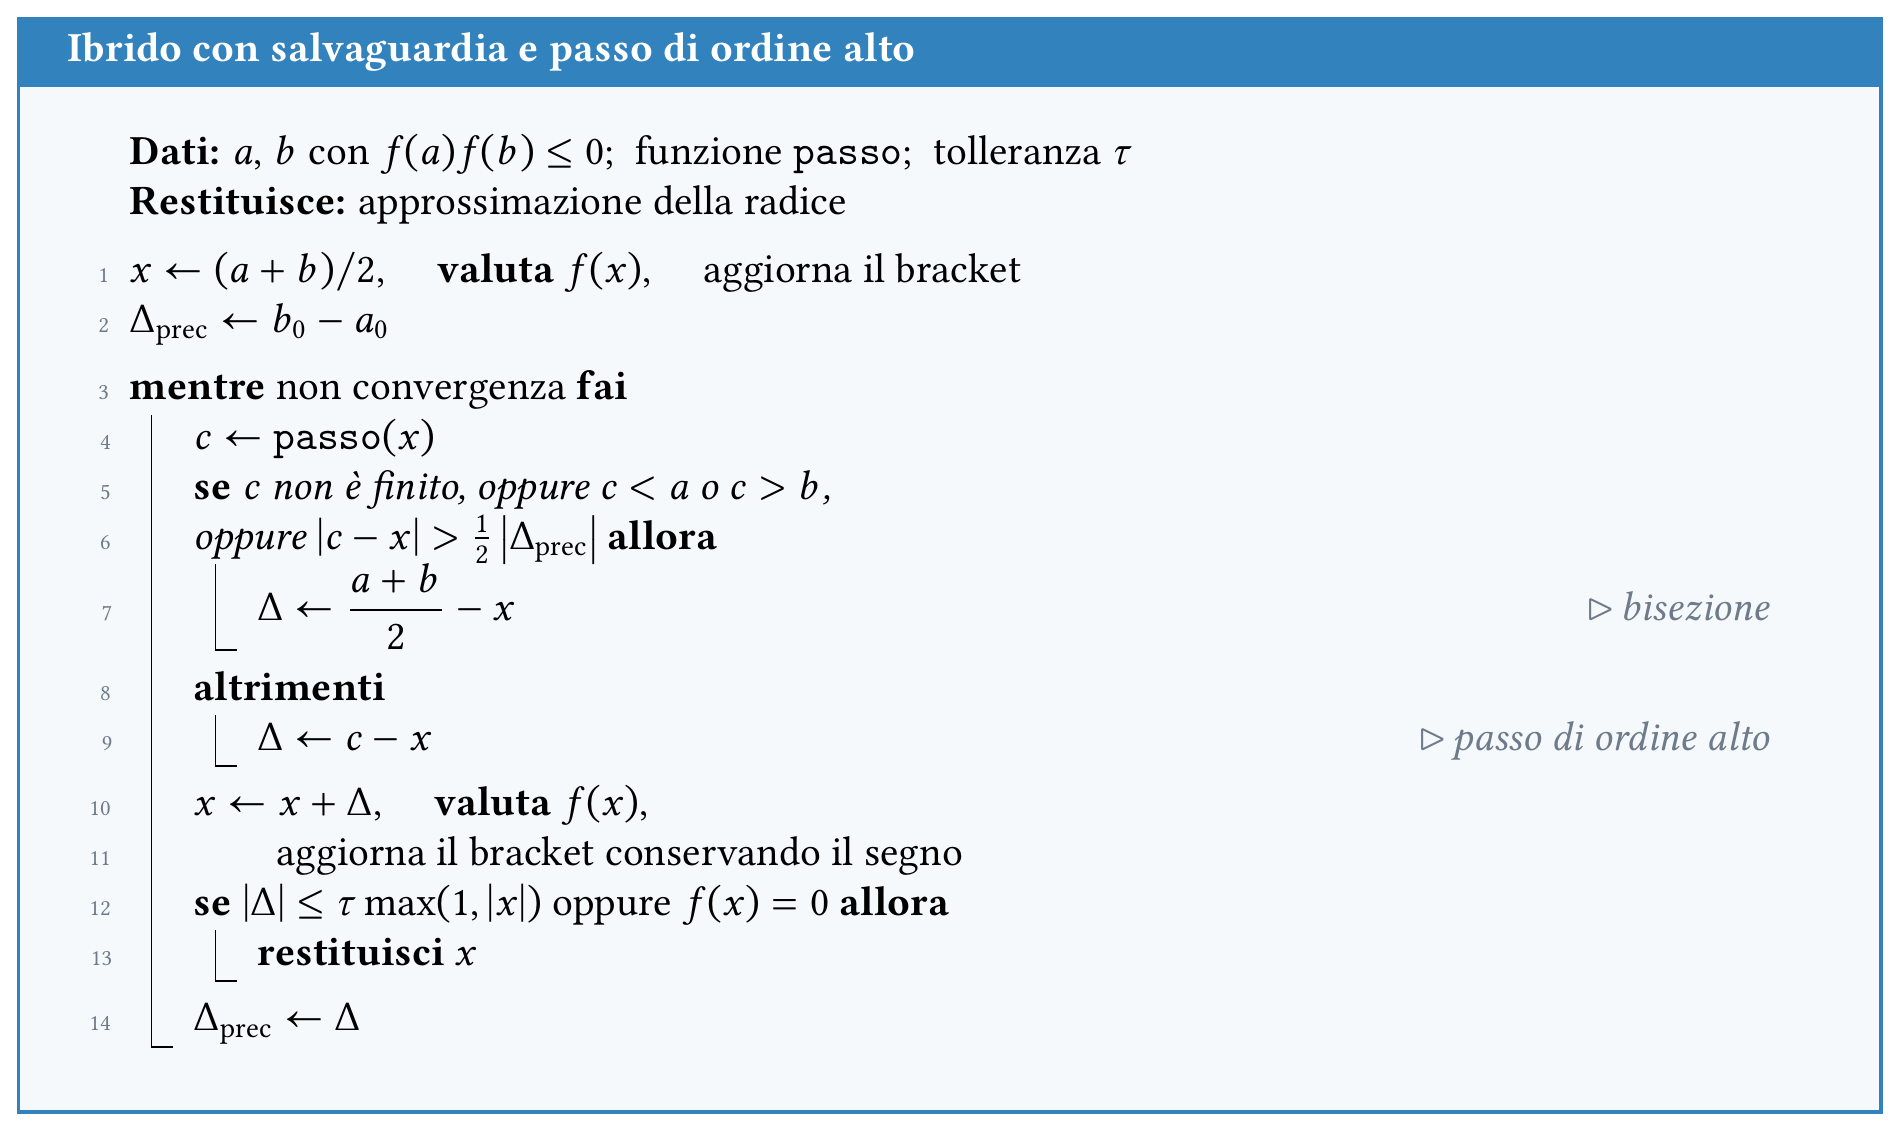
passo è un qualunque metodo di ordine alto (Newton, Halley, Chebyshev, Householder) e viene accettato solo se resta nel bracket e dimezza almeno il passo precedente.
passo_newton      <- function(x,f,df,ddf,dddf) x - f(x)/df(x)
passo_halley      <- function(x,f,df,ddf,dddf)
  x - 2*f(x)*df(x)/(2*df(x)^2 - f(x)*ddf(x))
passo_chebyshev   <- function(x,f,df,ddf,dddf) {
  u <- f(x)/df(x); x - u*(1 + 0.5*f(x)*ddf(x)/df(x)^2)
}
passo_householder <- function(x,f,df,ddf,dddf)
  x - (6*f(x)*df(x)^2 - 3*f(x)^2*ddf(x)) /
      (6*df(x)^3 - 6*f(x)*df(x)*ddf(x) + f(x)^2*dddf(x))
22.9 Metodo Newton–Bisection
Il candidato è il passo di Newton (Sezione 20.6)
n=x-\frac{f(x)}{f'(x)} .
È l’ibrido più semplice e quello che chiarisce meglio il meccanismo: vicino a una radice semplice i passi di Newton vengono accettati e si recupera la convergenza quadratica locale; lontano, dove Newton ciclerebbe o divergerebbe, il test li rifiuta e la bisezione riporta l’iterata nella regione buona. Il costo è di due valutazioni per iterazione (f e f').
tabella(ibrido(f, passo_newton, 2, 3, df, ddf, dddf),
"Newton--Bisection su $x^3-2x-5$, $[2,3]$")| k | passo | x_k | f(x_k) | \lvert x_k-\alpha\rvert | b-a |
|---|---|---|---|---|---|
| 1 | alto ordine | 2.164179104478 | 8.08e-01 | 6.96e-02 | 1.64e-01 |
| 2 | alto ordine | 2.097135355811 | 2.89e-02 | 2.58e-03 | 9.71e-02 |
| 3 | alto ordine | 2.094555232390 | 4.19e-05 | 3.75e-06 | 9.46e-02 |
| 4 | alto ordine | 2.094551481550 | 8.84e-11 | 7.92e-12 | 9.46e-02 |
| 5 | alto ordine | 2.094551481542 | -8.88e-16 | 0.00e+00 | 7.92e-12 |
| 6 | alto ordine | 2.094551481542 | -8.88e-16 | 0.00e+00 | 7.92e-12 |
La prova decisiva è il caso in cui il metodo di Newton puro fallisce in modo spettacolare, f(x)=\arctan x a partire da x_0=20 (Sezione 20.6.4):
alpha_sv <- alpha; alpha <- 0
cat("Newton puro da x0 = 20:\n")
Newton puro da x0 = 20:x <- 20; for (k in 1:5) x <- c(x, x[k] - atan(x[k])*(1 + x[k]^2)); print(x)[1] 2.000000e+01 -5.898560e+02 5.453492e+05 -4.671628e+11 3.428122e+23
[6] -1.846004e+47tab_at <- ibrido(atan, passo_newton, -5, 20, function(x) 1/(1+x^2))
alpha <- alpha_sv
tabella(tab_at, "Newton--Bisection su $\\arctan x$, $[-5,20]$")| k | passo | x_k | f(x_k) | \lvert x_k-\alpha\rvert | b-a |
|---|---|---|---|---|---|
| 1 | bisezione | 1.250000000000 | 8.96e-01 | 1.25e+00 | 6.25e+00 |
| 2 | alto ordine | -1.046141922964 | -8.08e-01 | 1.05e+00 | 2.30e+00 |
| 3 | alto ordine | 0.646028604063 | 5.74e-01 | 6.46e-01 | 1.69e+00 |
| 4 | alto ordine | -0.166934309609 | -1.65e-01 | 1.67e-01 | 8.13e-01 |
| 5 | alto ordine | 0.003084231094 | 3.08e-03 | 3.08e-03 | 1.70e-01 |
| 6 | alto ordine | -0.000000019559 | -1.96e-08 | 1.96e-08 | 3.08e-03 |
| 7 | alto ordine | 0.000000000000 | 6.62e-24 | 6.62e-24 | 1.96e-08 |
| 8 | alto ordine | 0.000000000000 | 0.00e+00 | 0.00e+00 | 1.96e-08 |
Newton puro diverge a 10^{47} in cinque passi; l’ibrido parte con una bisezione, poi accetta i passi di Newton e converge esattamente a zero. È il capitolo intero in una tabella.
22.10 Metodo Halley–Bisection
Il candidato è il passo di Halley (Sezione 20.12),
h=x-\frac{2f(x)f'(x)}{2f'(x)^2-f(x)f''(x)},
che su radici semplici ha ordine locale tre. Oltre ai test comuni va verificato che il denominatore non sia troppo piccolo: si annulla quando 2f'^2=ff'', cioè quando la parabola tangente degenera. Il costo è di tre valutazioni per iterazione.
tabella(ibrido(f, passo_halley, 2, 3, df, ddf, dddf),
"Halley--Bisection su $x^3-2x-5$, $[2,3]$")| k | passo | x_k | f(x_k) | \lvert x_k-\alpha\rvert | b-a |
|---|---|---|---|---|---|
| 1 | alto ordine | 2.104745673833 | 1.14e-01 | 1.02e-02 | 1.05e-01 |
| 2 | alto ordine | 2.094551719900 | 2.66e-06 | 2.38e-07 | 9.46e-02 |
| 3 | alto ordine | 2.094551481542 | -8.88e-16 | 0.00e+00 | 2.38e-07 |
| 4 | alto ordine | 2.094551481542 | -8.88e-16 | 0.00e+00 | 2.38e-07 |
22.11 Metodo Chebyshev–Bisection
Posti u=f(x)/f'(x) e L=f(x)f''(x)/f'(x)^2 (il grado di convessità logaritmica), lo sviluppo di Taylor dell’inversa locale fino al secondo ordine in f(x) dà il passo di Chebyshev [10]
c=x-u\left(1+\frac{L}{2}\right) =x-\frac{f(x)}{f'(x)}-\frac{f''(x)f(x)^2}{2f'(x)^3}.
Ha lo stesso ordine tre di Halley e lo stesso costo, ma una proprietà numerica diversa: il termine correttivo è additivo anziché al denominatore, quindi quando f'' è grande il passo di Chebyshev si allunga senza limite mentre quello di Halley resta controllato. Halley è infatti l’approssimante razionale di Chebyshev, e in presenza di forte convessità è il più robusto dei due; il test di ammissibilità del driver rende comunque sicuri entrambi.
tabella(ibrido(f, passo_chebyshev, 2, 3, df, ddf, dddf),
"Chebyshev--Bisection su $x^3-2x-5$, $[2,3]$")| k | passo | x_k | f(x_k) | \lvert x_k-\alpha\rvert | b-a |
|---|---|---|---|---|---|
| 1 | alto ordine | 2.113682534088 | 2.16e-01 | 1.91e-02 | 1.14e-01 |
| 2 | alto ordine | 2.094555161991 | 4.11e-05 | 3.68e-06 | 9.46e-02 |
| 3 | alto ordine | 2.094551481542 | -8.88e-16 | 0.00e+00 | 3.68e-06 |
| 4 | alto ordine | 2.094551481542 | -8.88e-16 | 0.00e+00 | 3.68e-06 |
22.12 Metodo Householder–Bisection
La famiglia di Householder [6] generalizza Newton e Halley. Posto g=1/f, il metodo di ordine locale d+1 è
H_d(x)=x+d\,\frac{g^{(d-1)}(x)}{g^{(d)}(x)} ,
dove le derivate siano definite e il denominatore non si annulli. Svolgendo le derivate si trovano i primi tre membri della famiglia:
\begin{aligned} d=1:\quad & H_1=x-\frac{f}{f'} && \text{(Newton, ordine 2)},\\[1mm] d=2:\quad & H_2=x-\frac{2ff'}{2f'^2-ff''} && \text{(Halley, ordine 3)},\\[1mm] d=3:\quad & H_3=x-\frac{6ff'^2-3f^2f''}{6f'^3-6ff'f''+f^2f'''} && \text{(ordine 4)}. \end{aligned}
Householder–Bisection designa dunque una famiglia di ibridi, non un singolo algoritmo: occorre specificare d. In pratica si usa raramente d>2: l’indice di efficienza (d+1)^{1/(d+1)} vale 1.414 per d=1, 1.442 per d=2, 1.414 per d=3 e poi decresce, mentre il costo e la fragilità numerica delle derivate alte crescono. Il massimo è in d=2, cioè Halley: è la ragione teorica per cui la famiglia di Householder si ferma, in pratica, a Halley.
Nella tabella seguente si usa d=3, con f'''=6.
tabella(ibrido(f, passo_householder, 2, 3, df, ddf, dddf),
"Householder--Bisection ($d=3$) su $x^3-2x-5$, $[2,3]$")| k | passo | x_k | f(x_k) | \lvert x_k-\alpha\rvert | b-a |
|---|---|---|---|---|---|
| 1 | alto ordine | 2.095856605977 | 1.46e-02 | 1.31e-03 | 9.59e-02 |
| 2 | alto ordine | 2.094551481543 | 2.51e-12 | 2.25e-13 | 9.46e-02 |
| 3 | alto ordine | 2.094551481542 | -8.88e-16 | 0.00e+00 | 2.25e-13 |
Tre passi portano alla precisione di macchina, contro i sei di Newton–Bisection — ma ciascuno costa quattro valutazioni (f, f', f'', f''') contro le due di Newton, e nel conteggio complessivo del prossimo paragrafo il vantaggio sparisce del tutto.
22.13 Confronto sperimentale
Le tabelle precedenti confrontano i metodi per iterazione, che come sappiamo (Sezione 21.1) non è il criterio giusto. Contiamo allora le valutazioni di funzione e di derivate necessarie a ciascun metodo per raggiungere \left\lvert x_k-\alpha\right\rvert\le10^{-10}, su cinque problemi di natura diversa:
| Problema | Caratteristica |
|---|---|
| x^3-2x-5 su [2,3] | radice semplice, funzione ben condizionata |
| x^{10}-1 su [0.5,1.3] | quasi piatta a sinistra, ripidissima a destra: il caso patologico della falsa posizione |
| e^{-x}-x su [0,1] | funzione regolare, derivate di taglia moderata |
| \arctan x su [-5,20] | Newton puro diverge, bracket molto ampio |
| (x-1)^3 su [0,3] | radice tripla: l’interpolazione è inefficace |
| x^3-2x-5 | x^{10}-1 | e^{-x}-x | \arctan x | (x-1)^3 | |
|---|---|---|---|---|---|
| Dekker | 7 | 11 | 7 | 10 | >82 |
| Brent | 7 | 11 | 6 | 10 | >82 |
| Ridders | 10 | 10 | 8 | 18 | 58 |
| TOMS 748 | 12 | 19 | 9 | 12 | 96 |
| Chandrupatla | 7 | 5 | 6 | 11 | 36 |
| ITP | 8 | 31 | 9 | 11 | 36 |
| Newton–Bis. | 15 | 21 | 12 | 24 | 171 |
| Halley–Bis. | 21 | 21 | 15 | 27 | 201 |
| Chebyshev–Bis. | 21 | 45 | 15 | 39 | 231 |
| Householder–Bis. | 25 | 25 | 25 | 36 | 278 |
La tabella si legge così.
- Sui problemi regolari (prima, terza e quarta colonna) Brent, Dekker e Chandrupatla sono i più economici, intorno a 6–11 valutazioni. TOMS 748 non recupera il suo ordine superiore perché su problemi così facili la convergenza avviene prima che i cicli completi entrino a regime.
- Su x^{10}-1 emergono le differenze di progetto. Chandrupatla è nettamente il migliore; ITP invece degenera: la falsa posizione è pessima su questa funzione, il budget \rho_j si azzera e l’algoritmo si riduce alla bisezione. È il prezzo della garanzia minmax, e si vede che il conto torna: le valutazioni spese sono quelle della bisezione, mai di più.
- Sulla radice tripla (x-1)^3 il quadro si capovolge. Tutti i metodi interpolatori soffrono, perché nessun polinomio di grado basso approssima bene una funzione con derivata prima e seconda nulle nella radice; Dekker e Brent non raggiungono affatto la tolleranza nel budget di iterazioni concesso, perché continuano a fidarsi di interpolazioni che non avanzano; TOMS 748 e Ridders ci arrivano ma spendendo rispettivamente 96 e 58 valutazioni; Chandrupatla e ITP, che riconoscono presto l’inutilità dell’interpolazione e cadono sulla bisezione, ci arrivano in 36 valutazioni, cioè esattamente \lceil\log_2(3/10^{-10})\rceil=35 passi di bisezione più uno. Gli ibridi con derivate sono i peggiori, perché Newton su una radice di molteplicità m converge soltanto linearmente con fattore 1-1/m (Sezione 21.3) e ogni iterazione costa da due a quattro valutazioni.
- Gli ibridi con derivate, in generale, costano da due a quattro volte un metodo senza derivate per ogni iterazione, e questo annulla quasi sempre il vantaggio dell’ordine più alto. Hanno senso quando f' (e f'') si ottengono quasi gratis insieme a f: polinomi valutati con lo schema di Horner esteso, oppure differenziazione automatica.
In pratica: quale metodo usare
- Senza derivate, caso generale: Brent–Dekker. È la scelta di riferimento e quella implementata nella maggior parte delle librerie; è difficile da battere in modo significativo.
- Se serve un algoritmo breve da scrivere a mano: Ridders. Il candidato cade sempre nel bracket senza bisogno di test di ammissibilità, quindi l’implementazione sta in poche righe e non ha casi particolari; si paga con due valutazioni per iterazione.
- Se si vuole la robustezza di Brent in trenta righe: Chandrupatla, che nei test sopra è il più efficiente dei metodi senza derivate.
- Tolleranze molto strette su funzioni regolari: TOMS 748, che sfrutta l’interpolazione di grado più alto e ha l’R-ordine maggiore.
- Valutazioni di f costose e necessità di una garanzia: ITP, perché il numero di iterazioni non supera mai quello della bisezione più lo slack n_0.
- Derivata disponibile e poco costosa (polinomi, differenziazione automatica): Newton–Bisection è semplice e sufficiente; Halley–Bisection solo se anche f'' è gratuita.
- Radici multiple: nessuno di questi metodi aiuta davvero. Su una radice di molteplicità pari non esiste nemmeno cambio di segno, quindi il bracket non si può costruire; su una radice di molteplicità dispari il bracket esiste ma, come mostra l’ultima colonna della tabella, l’interpolazione è inefficace e si ricade sulla bisezione. Occorre ricorrere alle tecniche di Sezione 21.3.
22.14 Esercizi
Perché serve il troncamento. Applicare la pura falsa posizione e poi ITP alla funzione f(x)=x^{10}-1 su [0,1.3], contando le valutazioni necessarie per scendere sotto 10^{-10}. Spiegare il ruolo di \delta=\kappa_1(b-a)^{\kappa_2} e che cosa cambia prendendo \kappa_2=1 invece di 2.
Ridders resta nel bracket. Verificare analiticamente che, se f(a)f(b)<0, allora \Delta=\sqrt{f(m)^2-f(a)f(b)}>\left\lvert f(m)\right\rvert e dedurne che r cade sempre in (a,b). Che cosa succede se f(a)f(b)=0?
Il budget di ITP. Modificare l’implementazione di ITP perché registri a ogni passo il valore di \rho_j, e applicarla a x^{10}-1 su [0.5,1.3]: a quale iterazione il budget si azzera? Confrontare con n_0=0 e n_0=4.
Dekker contro Brent. Costruire una funzione continua su [0,1] con f(0)f(1)<0 per cui il metodo di Dekker impieghi molte più valutazioni della bisezione, e verificare che Brent (o
uniroot) non degrada. Suggerimento: servono passi di secante che si accorcino lentamente.Newton–Bisection su una funzione non derivabile. Applicare
ibridoconpasso_newtona f(x)=\operatorname{sign}(x)\left\lvert x\right\rvert^{1/3} su [-1,2], dove Newton puro diverge per qualunque punto iniziale (Sezione 20.6.4). Quanti passi di Newton vengono accettati, e perché?IQI contro parabola diretta. Per tre punti vicini a \sqrt2 su f(x)=x^2-2, confrontare lo zero ottenuto interpolando y=f(x) con una parabola in x e quello ottenuto con l’interpolazione quadratica inversa. Quale dei due è sempre definito, e perché?
Il test di Chandrupatla. Disegnare nel piano (\xi,\phi) la regione 1-\sqrt{1-\xi}<\phi<\sqrt{\xi} per \xi\in(0,1) e verificare che contiene il punto corrispondente a tre punti equispaziati su una funzione lineare. Che cosa accade quando f ha un flesso fra i tre punti?
Molteplicità pari. Spiegare perché nessun metodo di questo capitolo può essere applicato a f(x)=(x-1)^2, e proporre una strategia alternativa basata su Sezione 21.3.
Costo della derivata. Rifare la tabella di Sezione 22.13 contando una valutazione di f e delle sue derivate come una sola valutazione (è il caso dei polinomi con lo schema di Horner esteso). Come cambia la classifica?
Confronto con la libreria. Confrontare le proprie implementazioni con
unirootdi R (che èzeroin, cioè Brent) su tutti e cinque i problemi di Sezione 22.13, usandotol = 1e-12, e commentare le differenze.