
| n | condizionamento |
|---|---|
| 2 | 5.24e+02 |
| 4 | 4.77e+05 |
| 6 | 4.75e+08 |
| 8 | 4.93e+11 |
| 10 | 5.22e+14 |
14 Da Gram–Schmidt ai polinomi di Legendre
14.1 Il prodotto scalare pesato sui polinomi
Sia w:[a,b]\to[0,+\infty) una funzione peso integrabile. Definiamo
\langle f,g\rangle_w=\int_a^b f(x)g(x)w(x)\,\mathrm{d}x, \qquad \|f\|_w=\sqrt{\langle f,f\rangle_w}.
Affinché questa espressione definisca un prodotto scalare pesato definito positivo sullo spazio dei polinomi, sono necessarie due condizioni.
I momenti devono essere finiti. Il k-esimo momento del peso è
\mu_k=\langle x^k,1\rangle_w=\int_a^b x^k\,w(x)\,\mathrm{d}x, \tag{14.1}
ossia l’integrale del monomio x^k rispetto al peso. La denominazione deriva dalla meccanica: se w è la densità di un’asta, \mu_0 ne è la massa, \mu_1 il momento statico e \mu_2 il momento d’inerzia rispetto all’origine. I momenti devono essere finiti affinché \langle f,g\rangle_w sia finito per ogni coppia di polinomi: sviluppando i due fattori, il prodotto scalare risulta una combinazione lineare di momenti. Su un intervallo limitato, se w è integrabile, questa condizione è automaticamente soddisfatta, poiché |x|^k\le\max(|a|,|b|)^k. La condizione è rilevante soprattutto sugli intervalli illimitati, dove il peso deve decadere abbastanza rapidamente. È il caso dei polinomi ortogonali di Hermite e di Laguerre (si veda Capitolo 15.)
Il peso non deve essere nullo. Basta chiedere
\int_a^b w(x)\,\mathrm{d}x>0 . \tag{14.2}
Serve per avere \|p\|_w>0 per ogni polinomio p\ne0, cioè perché \|\cdot\|_w sia una norma e non solo una seminorma. Che basti si vede così: un polinomio non nullo si annulla al più in un numero finito di punti, quindi p(x)^2w(x) è positivo ovunque lo sia w, tranne al più in quei pochi punti; se \int p^2w fosse nullo dovrebbe esserlo anche \int w.
Nota
In letteratura si trova spesso la richiesta, più forte, che w sia positiva quasi ovunque. Senza scomodare la teoria della misura: vuol dire che w può annullarsi, ma solo su un insieme di punti così piccolo da non cambiare il valore di nessun integrale. Per tutti i pesi di questo capitolo si tratta di un numero finito di punti, in genere gli estremi dell’intervallo — si pensi a w(x)=\sqrt{1-x^2}, nulla in \pm1. Ai fini di quanto segue 14.2 è tutto ciò che occorre.
Una famiglia p_0(x),p_1(x),\ldots, con \deg p_n(x)=n, è ortogonale se \langle p_n,p_m\rangle_w=0\quad(n\ne m), ed è ortonormale se inoltre \|p_n\|_w=1. Il segno e la scala restano liberi finché non si fissa una normalizzazione, per esempio polinomio monico oppure p_n(1)=1.
14.2 Esistenza della famiglia ortogonale
Il prodotto scalare c’è; resta da capire se una famiglia ortogonale esista davvero, come la si costruisce e perché la via più ovvia — ortogonalizzare i monomi — non sia praticabile al calcolatore.
Ortogonalizzazione di Gram–Schmidt
Applicando Gram–Schmidt12 ai monomi 1,x,x^2,\ldots si ottiene
q_0=\frac{1}{\|1\|_w},\qquad \widetilde q_n=x^n-\sum_{k=0}^{n-1}\langle x^n,q_k\rangle_w\,q_k, \qquad q_n=\frac{\widetilde q_n}{\|\widetilde q_n\|_w}.
Il coefficiente non ha denominatore perché i q_k sono già ortonormali; lavorando con una famiglia ortogonale ma non normalizzata p_k esso diventa \langle x^n,p_k\rangle_w/\|p_k\|_w^2.
La formula è una definizione costruttiva e dimostra l’esistenza e l’unicità della famiglia ortonormale una volta fissato il segno del coefficiente principale. Per calcoli con polinomi di grado elevato non si applica direttamente Gram–Schmidt ai monomi: i momenti e le potenze possono essere mal condizionati. Le famiglie classiche evitano questo problema con formule e ricorrenze stabili. Si noti che il rimedio abituale in algebra lineare — Gram–Schmidt modificato o riflessioni di Householder, Capitolo 4 — attenua la perdita di ortogonalità ma non il cattivo condizionamento della base di partenza: quindi è necessario cambiare base, non solo algoritmo. Questo è spiegato in maniera precisa in Teorema 14.2 mostrando che il condizionamento della base monomiale cresce esponenzialmente nel grado qualunque sia il peso scelto.
La matrice di Gram e la matrice di Hankel
Che cosa esattamente renda mal condizionata la base monomiale si deduce dalla sua matrice di Gram.
Definizione 14.1 (Matrice di Gram) Dati v_0,v_1,\ldots,v_n in uno spazio vettoriale con prodotto scalare \langle\cdot,\cdot\rangle, la loro matrice di Gram è la matrice G\in\Re^{(n+1)\times(n+1)} di elementi
G_{ij}=\langle v_i,v_j\rangle,\qquad i,j=0,1,\ldots,n.
\bm{G} è sempre simmetrica e semidefinita positiva, perché per ogni c\in\Re^{n+1}
\bm{c}^T\bm{G}\bm{c}=\Big\|\sum_{i=0}^n c_iv_i\Big\|^2\ \ge\ 0,
ed è definita positiva se e solo se i v_i sono linearmente indipendenti (si veda per esempio [4]). Il suo condizionamento misura quanto la base è storta: \bm{G}=\bm{I} esattamente per una base ortonormale, mentre \kappa_2(\bm{G}) grande segnala vettori quasi dipendenti.
Per i monomi v_i=x^i accade qualcosa di particolare. Dai momenti 14.1 si ha \langle x^i,x^j\rangle_w=\mu_{i+j}: la matrice di Gram dipende solo dalla somma degli indici, ed è quindi di un tipo speciale.
Definizione 14.2 (Matrice di Hankel) Una matrice \bm{H} si dice di Hankel se H_{ij} dipende solo da i+j, cioè se è costante lungo le antidiagonali: esiste una successione h_0,h_1,\ldots,h_{2n} con H_{ij}=h_{i+j}.
La matrice di Gram dei monomi è dunque la matrice di Hankel dei momenti,
H_n=\big(\mu_{i+j}\big)_{i,j=0}^{n}. \tag{14.3}
Teorema 14.1 (Esistenza tramite i momenti) Esiste una famiglia di polinomi ortogonali per il peso w se e solo se
\det H_n\ne0\qquad\text{per ogni } n\ge0 ,
e in tal caso la famiglia è unica a meno della normalizzazione.
Dimostrazione. Diamo l’argomento nel verso che ci serve, cioè costruendo la famiglia; il verso opposto si ottiene ripercorrendo gli stessi passaggi all’indietro (la trattazione completa è in [2]).
Cerchiamo il polinomio di grado n in forma monica,
\pi_n(x)=x^n+c_{n-1}x^{n-1}+\cdots+c_1x+c_0 ,
e imponiamo che sia ortogonale a tutti i polinomi di grado minore. Non serve imporlo per ognuno di essi: basta farlo sui monomi 1,x,\ldots,x^{n-1}, che ne sono una base. Le condizioni sono dunque
\langle \pi_n,x^i\rangle_w=0,\qquad i=0,1,\ldots,n-1 .
Sviluppiamo una di queste condizioni usando la definizione di momento 14.1, cioè \langle x^i,x^j\rangle_w=\mu_{i+j}:
0=\langle \pi_n,x^i\rangle_w =\mu_{i+n}+\sum_{j=0}^{n-1}c_j\,\mu_{i+j} ,
ossia, portando a destra il termine noto,
\sum_{j=0}^{n-1}\mu_{i+j}\,c_j=-\mu_{i+n}, \qquad i=0,1,\ldots,n-1 . \tag{14.4}
Questo è un sistema lineare di n equazioni nelle n incognite c_0,\ldots,c_{n-1}, e la sua matrice dei coefficienti ha elemento di posto (i,j) uguale a \mu_{i+j}: è esattamente H_{n-1}, la matrice di Hankel 14.3. Per l’algebra lineare elementare il sistema ha una e una sola soluzione se e solo se \det H_{n-1}\ne0. Richiedendolo per ogni n si ottengono, uno dopo l’altro, tutti i \pi_n; ogni altra famiglia ortogonale si ottiene moltiplicando i \pi_n per costanti non nulle, da cui l’unicità a meno di normalizzazione.
Per un peso positivo la condizione è automaticamente soddisfatta, perché per Definizione 14.1 H_n è la matrice di Gram dei monomi 1,x,\ldots,x^n, che sono linearmente indipendenti: H_n è quindi definita positiva e in particolare invertibile. L’esistenza non è mai in discussione.
Il condizionamento della base monomiale
Il problema vero è il condizionamento, e 14.3 lo rende quantitativo: su [0,1] con w\equiv1 si ha \mu_k=\int_0^1x^k\,\mathrm dx=1/(k+1), cioè
(H_n)_{ij}=\frac{1}{i+j+1},
che è la matrice di Hilbert, l’esempio canonico di matrice mal condizionata [3]. Risolvere 14.4 — cioè ortogonalizzare i monomi — equivale a risolvere un sistema con quella matrice, ed è per questo che il procedimento degenera già a gradi modesti.
Si potrebbe sperare che il guaio dipenda dal peso scelto e che un altro peso dia una Hankel più docile. Non è così, come mostra il seguente teorema.
Teorema 14.2 (Disuguaglianza di Beckermann) Per ogni matrice di Hankel \bm{H} definita positiva di ordine n\ge3 vale
\kappa_2(\bm{H})\ \ge\ \frac{\gamma^{\,n-1}}{16\,n}, \qquad \gamma=e^{4G/\pi}\simeq3{,}210 , \tag{14.5}
dove \kappa_2(\bm{H})=\|\bm{H}\|_2\|\bm{H}^{-1}\|_2 è il numero di condizionamento in norma 2 e G=\sum_{k\ge0}(-1)^k/(2k+1)^2\simeq0{,}916 è la costante di Catalan. La minorazione è ottimale a meno di un fattore 8\gamma n.
La dimostrazione, che copre anche le matrici di Vandermonde reali, usa strumenti di teoria del potenziale ed è in [1]. Quello che conta qui è leggerne l’enunciato: \gamma>1, quindi \gamma^{n-1} cresce esponenzialmente in n mentre il denominatore 16n cresce solo linearmente. Già per n=20 il membro destro di 14.5 vale circa 1{,}3\cdot10^{7}, e per n=30 supera 10^{12}.
Poiché la matrice di Gram dei monomi è di Hankel qualunque sia il peso, il teorema dice che nessuna scelta del peso rende i monomi una base ben condizionata: il condizionamento cresce almeno esponenzialmente nel grado. È la forma precisa dell’avvertimento dato sopra: contro un difetto della base non c’è algoritmo che tenga, bisogna cambiare base.
Nota
La tabella si ferma a n=10 non per brevità: oltre quel grado \kappa_2(H_n) supera 10^{16} e il valore calcolato in doppia precisione non è più affidabile. Per n=14 R restituisce 7{,}5\cdot10^{17}, cioè meno che per n=12: il condizionamento della matrice è diventato troppo grande perché lo si possa misurare con la stessa aritmetica che ne soffre.
Esempio svolto: costruire P_2 a mano
Lavoriamo su [-1,1] con peso w\equiv1. I primi due passi sono immediati:
\widetilde q_0(x)=1, \qquad \widetilde q_1(x)=x,
dove \widetilde q_1 non va corretto perché è già ortogonale a \widetilde q_0: l’integrando x è dispari su un intervallo simmetrico. Per il grado due Gram–Schmidt richiede invece di sottrarre due componenti:
\widetilde q_2(x)=x^2 -\frac{\langle x^2,1\rangle_w}{\langle 1,1\rangle_w}\cdot 1 -\frac{\langle x^2,x\rangle_w}{\langle x,x\rangle_w}\cdot x .
I prodotti scalari che vi compaiono sono tre integrali elementari:
\begin{aligned} \langle x^2,1\rangle_w &= \int_{-1}^{1} x^2\,\mathrm{d}x = \frac{2}{3}, \\[1mm] \langle 1,1\rangle_w &= \int_{-1}^{1} \mathrm{d}x = 2, \\[1mm] \langle x^2,x\rangle_w &= \int_{-1}^{1} x^3\,\mathrm{d}x = 0 \qquad \text{(integrando dispari).} \end{aligned}
L’ultimo è nullo, quindi la componente lungo x non c’è e resta
\widetilde q_2(x) = x^2 - \frac{2/3}{2}\cdot 1 = x^2 - \frac{1}{3}.
Manca solo la normalizzazione. La convenzione dei Legendre è P_2(1)=1, mentre
\widetilde q_2(1) = 1 - \frac{1}{3} = \frac{2}{3},
quindi si moltiplica per 3/2:
P_2(x) = \frac{3}{2}\left(x^2-\frac{1}{3}\right) = \frac{1}{2}\left(3x^2-1\right).
È lo stesso polinomio che la formula di Rodrigues produce per derivazione.
14.3 I polinomi di Legendre
Fissiamo ora il caso più semplice e più usato: intervallo [-1,1] e peso costante. La famiglia che ne risulta ha un nome, una formula chiusa, una ricorrenza e un’equazione differenziale, e le incontriamo tutte in questa sezione.
Definizione e primi polinomi
Su [-1,1] scegliamo il peso costante w(x)=1. I polinomi di Legendre3 P_n(x) sono normalizzati da P_n(1)=1 e soddisfano
\int_{-1}^1 P_n(x)P_m(x)\,\mathrm{d}x =\frac{2}{2n+1}\,\delta_{nm}.
Una definizione esplicita è la formula di Rodrigues4:
P_n(x)=\frac{1}{2^n n!}\frac{\mathrm d^n}{\mathrm{d}x^n}(x^2-1)^n. \tag{14.6}
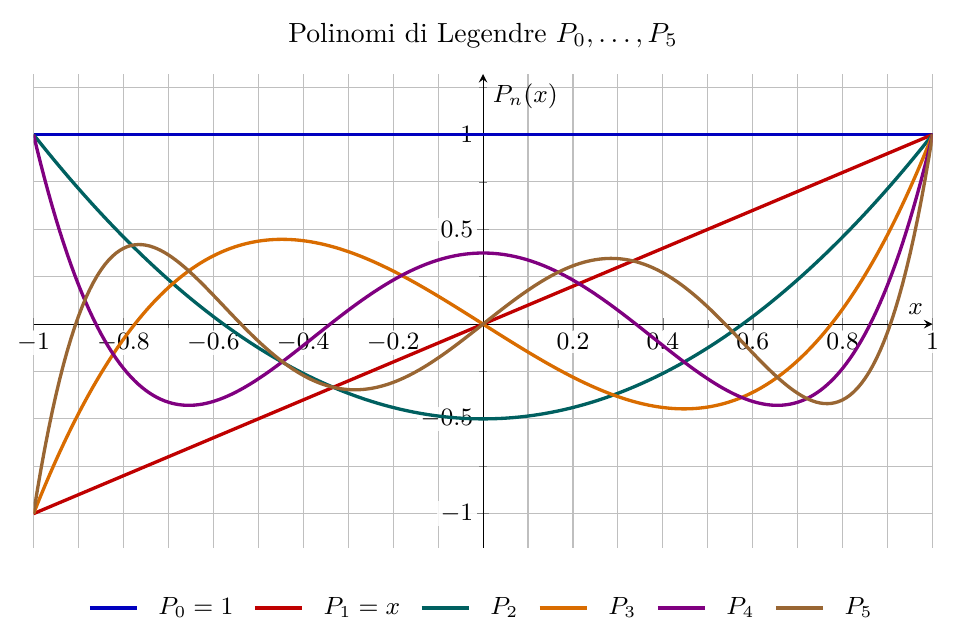
I primi sei polinomi, quelli disegnati in Figura 14.1, sono
\begin{aligned} P_0(x) &= 1, \\ P_1(x) &= x, \\ P_2(x) &= \frac{1}{2}\left(3x^2-1\right), \\ P_3(x) &= \frac{1}{2}\left(5x^3-3x\right), \\ P_4(x) &= \frac{1}{8}\left(35x^4-30x^2+3\right), \\ P_5(x) &= \frac{1}{8}\left(63x^5-70x^3+15x\right). \end{aligned}
La ricorrenza a tre termini
Rodrigues è una definizione, non un algoritmo: derivare n volte un polinomio di grado 2n è costoso e numericamente pessimo. Per il calcolo si usa la ricorrenza a tre termini
\begin{aligned} P_0(x)&=1,\\ P_1(x)&=x,\\ (k+1)\,P_{k+1}(x)&=(2k+1)\,x\,P_k(x)-k\,P_{k-1}(x). \end{aligned} \tag{14.7}
Che una ricorrenza di questo tipo esista non è un caso fortunato: in Capitolo 15 si vede che l’ortogonalità obbliga xp_n ad avere componenti non nulle solo su p_{n-1},p_n,p_{n+1}, e in Capitolo 16 se ne ricava la forma generale. I coefficienti di 14.7 sono il caso \alpha=\beta=0 della ricorrenza di Jacobi.
Una verifica immediata. Per k=1 la ricorrenza dà
2P_2(x)=3x\cdot x-1, \qquad\text{cioè}\qquad P_2(x)=\frac{1}{2}\left(3x^2-1\right),
e per k=2
3P_3(x)=5x\cdot\frac{1}{2}\left(3x^2-1\right)-2x, \qquad\text{cioè}\qquad P_3(x)=\frac{1}{2}\left(5x^3-3x\right),
che sono i polinomi elencati sopra.
Tradotta in codice, 14.7 costa O(n) operazioni e memoria costante, e non richiede mai i coefficienti monomiali. La funzione seguente è definita in _common.R ed è usata da tutti gli esempi del capitolo:
legendre <- function(n, x) {
  if (n == 0) return(rep(1, length(x)))
  p0 <- rep(1, length(x)); p1 <- x
  if (n == 1) return(p1)
  for (k in 1:(n - 1)) {
    p2 <- ((2*k + 1)*x*p1 - k*p0)/(k + 1)
    p0 <- p1; p1 <- p2
  }
  p1
}
Il comportamento in virgola mobile di questa ricorrenza è discusso in Capitolo 16.
Rodrigues e la dimostrazione dell’ortogonalità
Teorema 14.3 (Ortogonalità e norma dei polinomi di Legendre) Il polinomio P_n definito dalla formula di Rodrigues è ortogonale a ogni polinomio di grado minore di n e soddisfa
\int_{-1}^{1} P_n(x)^2\,\mathrm{d}x = \frac{2}{2n+1}.
Dimostrazione. Conviene dare un nome alla funzione che si deriva:
u(x)=(x^2-1)^n=(x-1)^n(x+1)^n,
cosicché
P_n(x)=\frac{1}{2^n\,n!}\,u^{(n)}(x).
Passo 1: u(x) e le sue derivate fino all’ordine n-1 si annullano in \pm1. Applichiamo la formula di Leibniz per la derivata di un prodotto:
u^{(j)}(x)=\sum_{i=0}^{j}\binom{j}{i} \frac{\mathrm d^{i}}{\mathrm{d}x^{i}}\big[(x-1)^n\big]\cdot \frac{\mathrm d^{\,j-i}}{\mathrm{d}x^{\,j-i}}\big[(x+1)^n\big].
Derivare i volte (x-1)^n dà
\frac{\mathrm d^{i}}{\mathrm{d}x^{i}}(x-1)^n =\frac{n!}{(n-i)!}\,(x-1)^{\,n-i},
che contiene ancora il fattore (x-1) ogni volta che i<n. Se j\le n-1, in ogni addendo della somma si ha i\le j<n: tutti gli addendi contengono (x-1) e quindi si annullano in x=1. Scambiando il ruolo dei due fattori si ragiona allo stesso modo in x=-1. Dunque
u^{(j)}(\pm1)=0,\qquad j=0,1,\ldots,n-1 . \tag{14.8}
Passo 2: integrare per parti n volte. Sia r(x) un polinomio qualunque. Un singolo passo di integrazione per parti dà
\int_{-1}^{1} r\,u^{(n)}\,\mathrm{d}x =\Big[\,r\,u^{(n-1)}\Big]_{-1}^{1} -\int_{-1}^{1} r'\,u^{(n-1)}\,\mathrm{d}x =-\int_{-1}^{1} r'\,u^{(n-1)}\,\mathrm{d}x,
dove il termine di bordo è nullo per 14.8. L’integrale che resta ha la stessa forma di quello di partenza, con una derivata in meno su u e una in più su r. Ripetendo il procedimento n volte — e a ogni passo il termine di bordo è nullo, sempre per 14.8 — si ottiene
\int_{-1}^{1} r(x)\,u^{(n)}(x)\,\mathrm{d}x =(-1)^n\int_{-1}^{1} r^{(n)}(x)\,u(x)\,\mathrm{d}x , \tag{14.9}
dove il segno (-1)^n raccoglie il meno che compare a ciascuno degli n passi.
Passo 3: l’ortogonalità. Se \deg r<n, derivando r per n volte si ottiene la funzione identicamente nulla, r^{(n)}\equiv0, e quindi il secondo membro di 14.9 è zero. Dividendo per la costante 2^n\,n!,
\int_{-1}^{1} r(x)\,P_n(x)\,\mathrm{d}x=0 \qquad\text{per ogni } r \text{ di grado } <n .
In particolare, scegliendo r(x)=P_m(x) con m<n, si ha \langle P_n,P_m\rangle=0: i polinomi di Legendre sono a due a due ortogonali.
Passo 4: il coefficiente direttore di P_n(x). Serve per la norma. Scriviamo u(x)=(x^2-1)^n=x^{2n}+\cdots, dove i puntini indicano termini di grado minore di 2n. Derivando n volte, il termine di grado massimo diventa
\frac{\mathrm d^n}{\mathrm{d}x^n}x^{2n} =2n\,(2n-1)\cdots(n+1)\,x^{n}=\frac{(2n)!}{n!}\,x^{n},
mentre tutti gli altri danno potenze di grado minore. Dividendo per 2^n n!, il coefficiente direttore di P_n(x) è
a_n=\frac{(2n)!}{2^n\,(n!)^2}.
Poiché P_n(x) ha grado esattamente n, derivandolo n volte resta la costante
P_n^{(n)}(x)=n!\,a_n=\frac{(2n)!}{2^n\,n!} .
Passo 5: un integrale ausiliario. Poniamo
I_n=\int_{-1}^{1}(1-x^2)^n\,\mathrm{d}x .
Integriamo per parti derivando (1-x^2)^n e integrando il fattore 1:
I_n=\Big[x\,(1-x^2)^n\Big]_{-1}^{1} +2n\int_{-1}^{1}x^2(1-x^2)^{n-1}\,\mathrm{d}x =2n\int_{-1}^{1}x^2(1-x^2)^{n-1}\,\mathrm{d}x,
perché (1-x^2)^n si annulla in \pm1. Scrivendo ora x^2=1-(1-x^2), l’ultimo integrale si spezza in I_{n-1}-I_n, e si ottiene I_n=2n\,(I_{n-1}-I_n), cioè la ricorrenza
I_n=\frac{2n}{2n+1}\,I_{n-1}, \qquad I_0=\int_{-1}^{1}\mathrm{d}x=2 .
Moltiplicando fra loro queste uguaglianze per k=1,2,\ldots,n,
I_n=2\cdot\frac{2\cdot4\cdots(2n)}{3\cdot5\cdots(2n+1)} =\frac{2^{2n+1}\,(n!)^2}{(2n+1)!} .
Passo 6: la norma. Applichiamo 14.9 con r(x)=P_n(x), che ha grado n:
\int_{-1}^{1}P_n(x)^2\,\mathrm{d}x =\frac{1}{2^n n!}\int_{-1}^{1}P_n\,u^{(n)}\,\mathrm{d}x =\frac{(-1)^n}{2^n n!}\int_{-1}^{1}P_n^{(n)}\,u\,\mathrm{d}x .
Per il Passo 4 la quantità P_n^{(n)} è una costante e si porta fuori dall’integrale; inoltre (-1)^n u(x)=(1-x^2)^n, quindi ciò che resta è esattamente I_n:
\int_{-1}^{1}P_n^2\,\mathrm{d}x =\frac{1}{2^n n!}\cdot\frac{(2n)!}{2^n n!}\cdot I_n =\frac{(2n)!}{2^{2n}(n!)^2}\cdot\frac{2^{2n+1}(n!)^2}{(2n+1)!} =\frac{2\,(2n)!}{(2n+1)!} =\frac{2}{2n+1},
dove nell’ultimo passaggio si è usato (2n+1)!=(2n+1)\,(2n)!.
Di conseguenza \phi_n(x)=\sqrt{\frac{2n+1}{2}}P_n(x) è la versione ortonormale.
Equazione differenziale e funzione generatrice
I polinomi di Legendre soddisfano l’equazione:
\frac{\mathrm d}{\mathrm{d}x}\!\left[(1-x^2)P_n'(x)\right] +n(n+1)P_n(x)=0.
Questa equazione segue anche in senso inverso: la soluzione polinomiale di grado n, normalizzata a 1 in x=1, è P_n. La funzione generatrice compatta tutti i gradi in un’unica identità:
\frac{1}{\sqrt{1-2xt+t^2}}=\sum_{n=0}^{\infty}P_n(x)t^n, \qquad |t|<1,\quad -1\le x\le1.
Due conseguenze utili sono la simmetria P_n(-x)=(-1)^nP_n(x) e la formula ai capi P_n(1)=1, P_n(-1)=(-1)^n.
La famiglia in un grafico
La Figura 14.1 sovrappone i primi polinomi: si vede la parità alternata, il numero crescente di oscillazioni e il valore unitario comune all’estremo destro. Gli zeri sono interni e distinti; la loro separazione sarà dimostrata in Sezione 16.2.
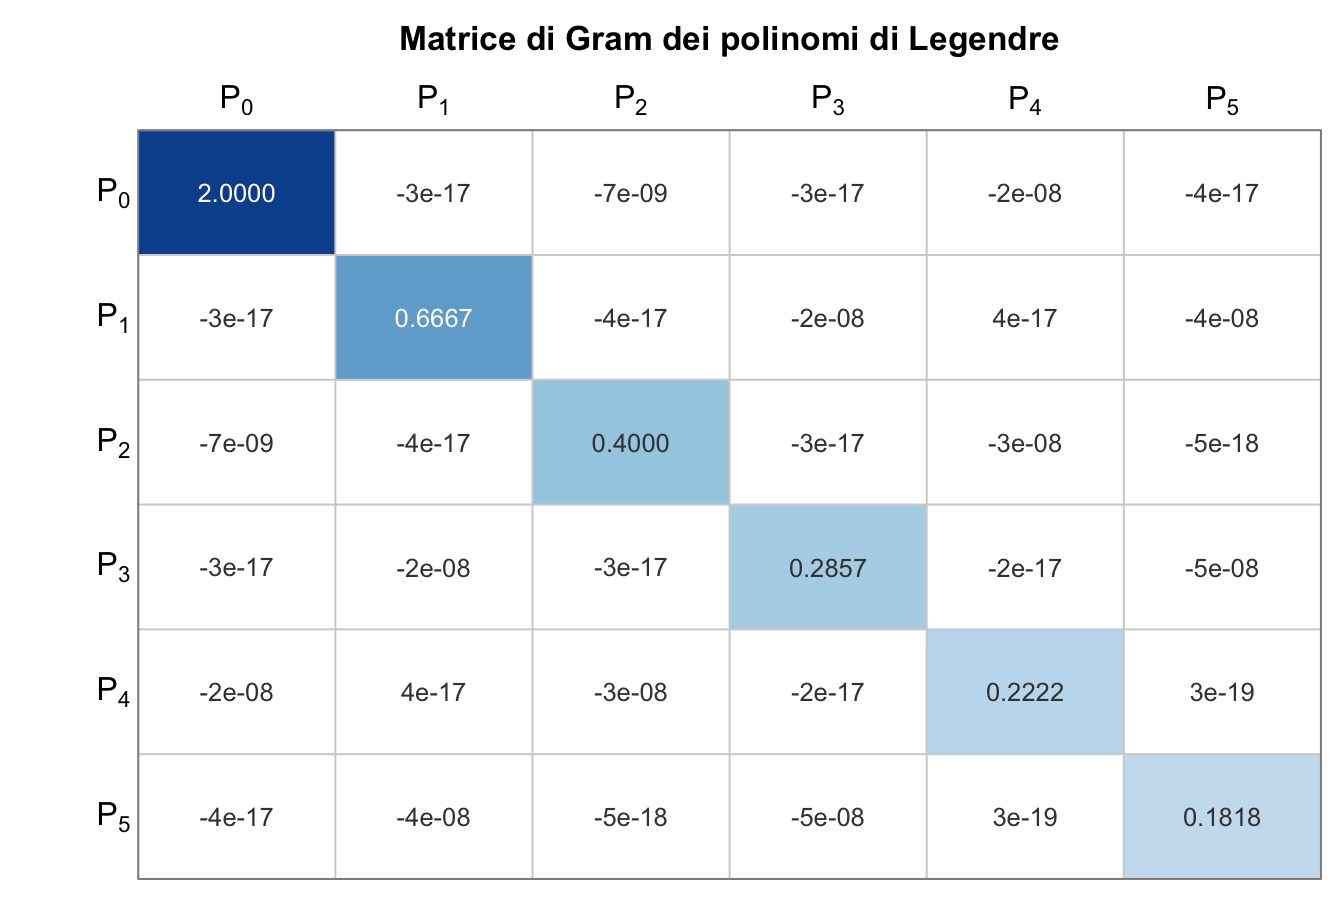
Una seconda figura verifica numericamente l’ortogonalità calcolando la matrice di Gram con quadratura composta del punto medio. Nella Figura 14.2 ogni cella riporta il valore di G_{ij}=\langle P_i,P_j\rangle: sulla diagonale si leggono i valori 2/(2n+1), cioè 2, 0.6667, 0.4, 0.2857, 0.2222, 0.1818, mentre fuori diagonale si trovano numeri dell’ordine di 10^{-8} o minori, cioè zero a meno dell’errore di quadratura.
m <- 12000
x <- -1 + (seq_len(m) - 0.5)*2/m
P <- sapply(0:5, legendre, x = x)
G <- crossprod(P)*(2/m)
d <- 5

par(mar = c(0.6, 3.6, 3.4, 0.6))
# scala radice: comprime il salto fra 2.0000 e 0.1818 senza colorare gli zeri
S   <- sqrt(abs(G)/max(abs(G)))
pal <- colorRampPalette(c("white", "#dbe9f6", "#92c5de",
                          "#3182bd", "#08519c"))(40)
image(0:d, 0:d, t(S[(d+1):1, ]), col = pal,
      breaks = seq(0, 1, length.out = 41),
      axes = FALSE, xlab = "", ylab = "")
axis(3, at = 0:d, tick = FALSE, line = -0.8,
     labels = sapply(0:d, function(k) as.expression(bquote(P[.(k)]))))
axis(2, at = 0:d, tick = FALSE, las = 1, line = -0.8,
     labels = sapply(d:0, function(k) as.expression(bquote(P[.(k)]))))
mtext("Matrice di Gram dei polinomi di Legendre", side = 3, line = 1.9,
      cex = 1.05, font = 2)
abline(h = (0:d) + 0.5, v = (0:d) + 0.5, col = "grey82")
box(col = "grey55")
for (i in 0:d) for (j in 0:d) {
  v <- G[i+1, j+1]
  text(j, d - i,
       if (i == j) sprintf("%.4f", v) else sprintf("%.0e", v),
       cex = 0.80, col = if (S[i+1, j+1] > 0.55) "white" else "grey25")
}
Nota
La figura è un controllo numerico, non una prova dell’ortogonalità: il ragionamento analitico usa Rodrigues. I numeri fuori diagonale non sono esattamente nulli perché l’integrale è stato sostituito da una somma finita: raffinando la quadratura (aumentando m) tendono a zero.
In sintesi
- Un peso positivo w definisce un prodotto scalare sui polinomi; Gram–Schmidt sui monomi dimostra che la famiglia ortogonale esiste ed è unica a meno di normalizzazione, ma non è un buon algoritmo.
- Su [-1,1] con w\equiv1 si ottengono i polinomi di Legendre, normalizzati da P_n(1)=1, con \|P_n\|_2^2=2/(2n+1).
- Rodrigues serve per dimostrare l’ortogonalità; la ricorrenza a tre termini 14.7 serve per calcolare, in O(n).
- Parità, valori agli estremi e zeri interni seguono dalla simmetria del peso e dall’ortogonalità, non da conti espliciti.
14.4 Esercizi
- Usando la formula di Rodrigues calcolare P_0(x), P_1(x) e P_2(x), inoltre verificarne i valori in \pm1.
- Usare la parità per dedurre che \int_{-1}^1 xP_{2k}(x)\,\mathrm{d}x=0.
- Spiegare perché la norma dei polinomi ortonormali è uno, mentre \|P_n\|_2^2=2/(2n+1).
- Verificare 14.7 per k=3 confrontando il risultato con l’espressione esplicita di P_4.