18  Quadrature di Gauss e zeri dei polinomi

Autore/Autrice
Affiliazione

Enrico Bertolazzi

University of Trento, Department of Industrial Engineering

18.1 Esattezza di grado 2n-1

Dall’ortogonalità all’esattezza

Sia w>0 su [a,b], e siano x_1,\ldots,x_n gli zeri del polinomio ortogonale p_n: per Teorema 16.2 sono reali, semplici e interni a (a,b), dunque utilizzabili come nodi. La formula di quadratura gaussiana1 è quella interpolatoria su tali nodi,

Q_n(f)=\sum_{i=1}^n\omega_i f(x_i),\qquad \omega_i=\int_a^b\ell_i(x)\,w(x)\,\mathrm dx, \tag{18.1}

dove \ell_i è l’i-esimo polinomio cardinale di Lagrange2 sui nodi x_1,\ldots,x_n. Definendo i pesi come in 18.1, la formula integra per costruzione esattamente ogni polinomio di \mathcal P_{n-1}: è quanto fa una qualsiasi formula interpolatoria, come quelle di Newton-Cotes di Capitolo 10. La proprietà fondamentale è che questa particolare scelta dei nodi consente di raggiungere un grado di esattezza quasi doppio.

Teorema 18.1 (Esattezza delle formule gaussiane) Siano x_1,\ldots,x_n gli zeri del polinomio ortogonale p_n e siano \omega_1,\ldots,\omega_n i pesi definiti da 18.1. Allora la formula

Q_n(f)=\sum_{i=1}^{n}\omega_i\,f(x_i) \tag{18.2}

soddisfa

Q_n(r)=\int_a^b r(x)\,w(x)\,\mathrm dx \qquad\text{per ogni } r\in\mathcal P_{2n-1},

e questo grado di esattezza è massimo: nessuna formula a n nodi, comunque se ne scelgano nodi e pesi, può essere esatta su tutto \mathcal P_{2n}.

Dimostrazione. Passo 1: dividere per p_n. Sia r un polinomio di grado al più 2n-1. La divisione euclidea fra polinomi — la stessa che si fa fra numeri interi — fornisce quoziente q e resto s con

r=q\,p_n+s,\qquad \deg s<\deg p_n=n . \tag{18.3}

Il grado del quoziente si conta sottraendo: \deg q=\deg r-n\le n-1. Dunque entrambi, quoziente e resto, stanno in \mathcal P_{n-1}: è questo il punto in cui si usa l’ipotesi \deg r\le 2n-1, ed è il motivo per cui la soglia è proprio 2n-1.

Passo 2: l’integrale esatto non vede il quoziente. Integrando 18.3 contro il peso,

\int_a^b r\,w =\underbrace{\int_a^b q\,p_n\,w}_{=\,0} +\int_a^b s\,w =\int_a^b s\,w .

Il primo integrale è nullo perché è \langle p_n,q\rangle_w con \deg q\le n-1<n: è esattamente l’ortogonalità di p_n ai polinomi di grado inferiore.

Passo 3: nemmeno la formula vede il quoziente. Qui entra la scelta dei nodi. Valutando 18.3 in un nodo x_i e usando p_n(x_i)=0,

r(x_i)=q(x_i)\underbrace{p_n(x_i)}_{=\,0}+s(x_i)=s(x_i),

cioè r e s hanno gli stessi valori nei nodi. Poiché Q_n usa solo quei valori,

Q_n(r)=\sum_{i=1}^n\omega_i\,r(x_i)=\sum_{i=1}^n\omega_i\,s(x_i)=Q_n(s).

Passo 4: sul resto la formula è esatta per costruzione. Il resto s ha grado al più n-1, e una formula interpolatoria a n nodi con i pesi 18.1 integra esattamente tutto \mathcal P_{n-1}. Quindi Q_n(s)=\int_a^b s\,w.

Conclusione. Incatenando i tre passi,

Q_n(r)\overset{\text{Passo 3}}{=}Q_n(s) \overset{\text{Passo 4}}{=}\int_a^b s\,w \overset{\text{Passo 2}}{=}\int_a^b r\,w .

Passo 5: 2n-1 non si può superare. L’affermazione di massimalità riguarda una formula a n nodi qualunque, non solo quella gaussiana. Siano dunque y_1,\ldots,y_n nodi arbitrari e \nu_1,\ldots,\nu_n pesi arbitrari, e consideriamo

\Omega(x)=\big[(x-y_1)(x-y_2)\cdots(x-y_n)\big]^2 ,

polinomio di grado esattamente 2n. Da un lato \Omega\ge0 e non è identicamente nullo, quindi \int_a^b\Omega\,w>0. Dall’altro \Omega(y_i)=0 per ogni i, quindi la formula restituisce

\sum_{i=1}^n\nu_i\,\Omega(y_i)=0\ \ne\ \int_a^b\Omega\,w .

Nessuna formula a n nodi è dunque esatta su \mathcal P_{2n}. Nel caso gaussiano il controesempio si scrive in modo ancora più suggestivo: \Omega=p_n^2, a meno del fattore di normalizzazione.

Positività dei pesi

Proposizione 18.1 (Positività dei pesi) I pesi \omega_1,\ldots,\omega_n di una formula gaussiana sono tutti strettamente positivi.

Dimostrazione. Fissiamo un indice i e consideriamo il polinomio cardinale di Lagrange \ell_i, caratterizzato da

\deg\ell_i=n-1,\qquad \ell_i(x_j)=\begin{cases}1 & j=i,\\ 0 & j\ne i.\end{cases} \tag{18.4}

Il suo quadrato \ell_i^2 ha grado 2n-2, che è minore o uguale a 2n-1: per Teorema 18.1 la formula lo integra esattamente. Calcoliamo allora lo stesso numero in due modi.

Con la formula, usando 18.4, sopravvive un solo addendo:

Q_n(\ell_i^2)=\sum_{j=1}^n\omega_j\,\ell_i(x_j)^2 =\omega_i\cdot1^2=\omega_i .

Con l’integrale, invece, si tratta dell’integrale pesato di un quadrato:

\int_a^b \ell_i(x)^2\,w(x)\,\mathrm dx\ >\ 0 ,

strettamente positivo perché \ell_i^2\ge0, perché \ell_i^2 non è identicamente nullo (vale 1 in x_i) e perché w>0.

Essendo i due numeri uguali, \omega_i>0. L’indice i era arbitrario.

La positività non è un dettaglio estetico. Poiché

\sum_{i=1}^{n}|\omega_i|=\sum_{i=1}^{n}\omega_i=\int_a^b w

indipendentemente da n, la formula non amplifica gli errori sui valori di f per quanto si alzi l’ordine. Le formule di Newton-Cotes di Capitolo 10 perdono questa proprietà già per n dell’ordine di otto: è la ragione tecnica per cui non si usano ad alto ordine, mentre le gaussiane sì.

18.2 Gauss–Legendre

Nodi e pesi

Per w=1 su [-1,1] si ottengono le formule di Gauss–Legendre3: i nodi sono gli zeri di P_n e i pesi si possono scrivere \omega_i=\frac{2}{(1-x_i^2)[P_n'(x_i)]^2}. Entrambe le formule sono casi particolari di un fatto generale, che chiude il discorso aperto in Sezione 16.3.

I pesi sono la funzione di Christoffel

Proposizione 18.2 (I pesi sono la funzione di Christoffel) Qualunque sia il peso w, i pesi della formula gaussiana a n nodi valgono

\omega_i=\lambda_{n-1}(x_i)=\frac{1}{K_{n-1}(x_i,x_i)} =\frac{1}{\sum_{k=0}^{n-1}\phi_k(x_i)^2}, \qquad i=1,\ldots,n, \tag{18.5}

dove \lambda_{n-1} è la funzione di Christoffel 16.17 e i \phi_k sono i polinomi ortonormali.

Dimostrazione. L’idea è calcolare due volte, in due modi diversi, la stessa quantità: il minimo di \|p\|_w^2 fra i polinomi p\in\mathcal P_{n-1} vincolati da p(x_i)=1. Fissiamo dunque l’indice i e chiamiamo

m_i=\min\big\{\|p\|_w^2:\ p\in\mathcal P_{n-1},\ p(x_i)=1\big\} .

Primo calcolo: m_i=\omega_i. Sia p\in\mathcal P_{n-1} con p(x_i)=1. Il quadrato p^2 ha grado al più 2n-2\le2n-1, dunque per Teorema 18.1 la formula gaussiana lo integra esattamente:

\|p\|_w^2=\int_a^b p^2\,w=Q_n(p^2)=\sum_{j=1}^{n}\omega_j\,p(x_j)^2 . \tag{18.6}

Tutti gli addendi della somma sono \ge0, perché i pesi sono positivi per Proposizione 18.1 e i p(x_j)^2 sono quadrati. Trattenendo il solo addendo j=i e usando il vincolo p(x_i)=1,

\|p\|_w^2\ \ge\ \omega_i\,p(x_i)^2=\omega_i .

Vale quindi m_i\ge\omega_i. Per vedere che il valore \omega_i è effettivamente raggiunto basta scegliere p=\ell_i, il polinomio cardinale 18.4: è di grado n-1, soddisfa \ell_i(x_i)=1 e, per 18.6, ha norma al quadrato pari a \omega_i. Dunque

m_i=\omega_i ,

e il minimo è raggiunto solo da \ell_i: perché in 18.6 valga l’uguaglianza occorre che tutti gli addendi con j\ne i siano nulli, cioè p(x_j)=0 per j\ne i; ma un polinomio di \mathcal P_{n-1} è determinato dai suoi valori negli n nodi, e quei valori sono proprio quelli di \ell_i.

Secondo calcolo: m_i=1/K_{n-1}(x_i,x_i). Il minimo m_i è esattamente quello descritto da Teorema 16.3, applicato con grado n-1 al posto di n e con x_0=x_i. Quel teorema dice che il minimo vale 1/K_{n-1}(x_i,x_i) ed è raggiunto da K_{n-1}(x_i,\cdot)/K_{n-1}(x_i,x_i).

Conclusione. I due calcoli riguardano lo stesso numero, quindi

\omega_i=m_i=\frac{1}{K_{n-1}(x_i,x_i)}=\lambda_{n-1}(x_i).

Per inciso, confrontando anche i due minimizzanti si ottiene gratis l’identità \ell_i(x)=K_{n-1}(x_i,x)/K_{n-1}(x_i,x_i): i polinomi cardinali di Lagrange sui nodi gaussiani sono polinomi del nucleo normalizzati.

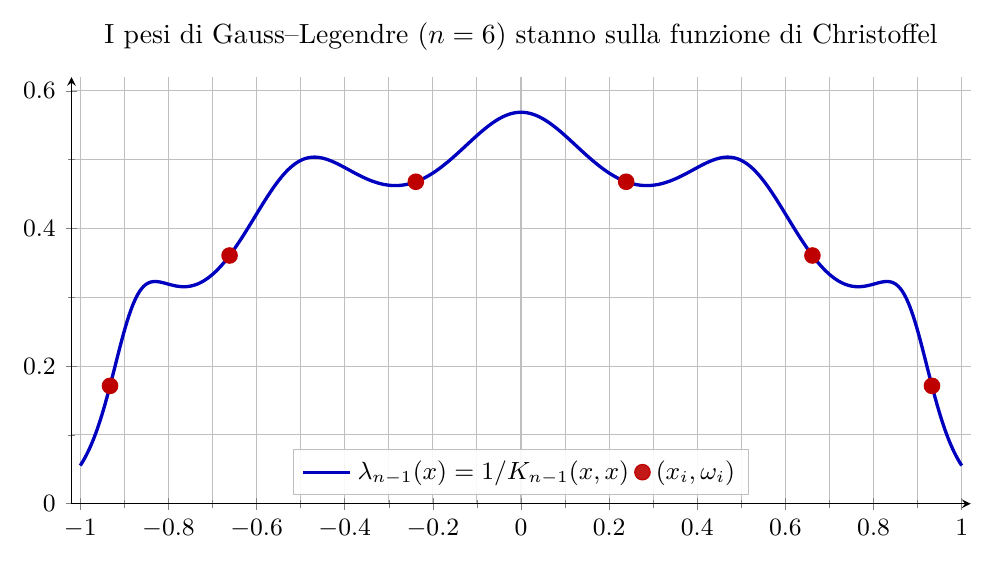
Figura 18.1: I sei pesi di Gauss–Legendre non sono numeri slegati: sono i valori della funzione di Christoffel nei nodi.

La Figura 18.1 lo mostra per n=6: i punti (x_i,\omega_i) cadono sulla curva \lambda_{n-1}. A differenza della formula per i soli Legendre scritta sopra, 18.5 vale per qualunque peso, e dà una seconda dimostrazione del fatto che i pesi sono positivi: sono reciproci di somme di quadrati.

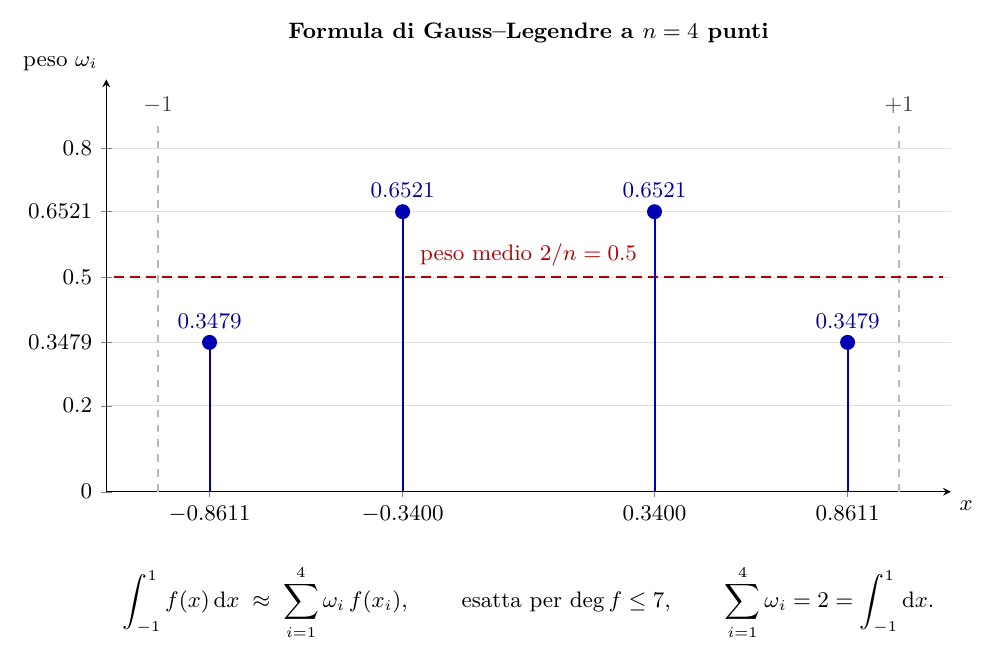
In pratica è spesso preferibile la procedura di Golub–Welsch45 [1]: si costruisce la matrice di Jacobi J_n dalla ricorrenza ortonormale, si calcolano autovalori e autovettori, e si pone x_i=\lambda_i(J_n),\qquad \omega_i=\mu_0 |v_{1i}|^2, \quad \mu_0=\int_{-1}^1w(x)\,\mathrm dx. Nel caso Legendre \mu_0=2. Questo metodo produce nodi reali e pesi positivi per costruzione e scala bene a ordini alti. La Figura 18.2 mostra la configurazione per n=4.

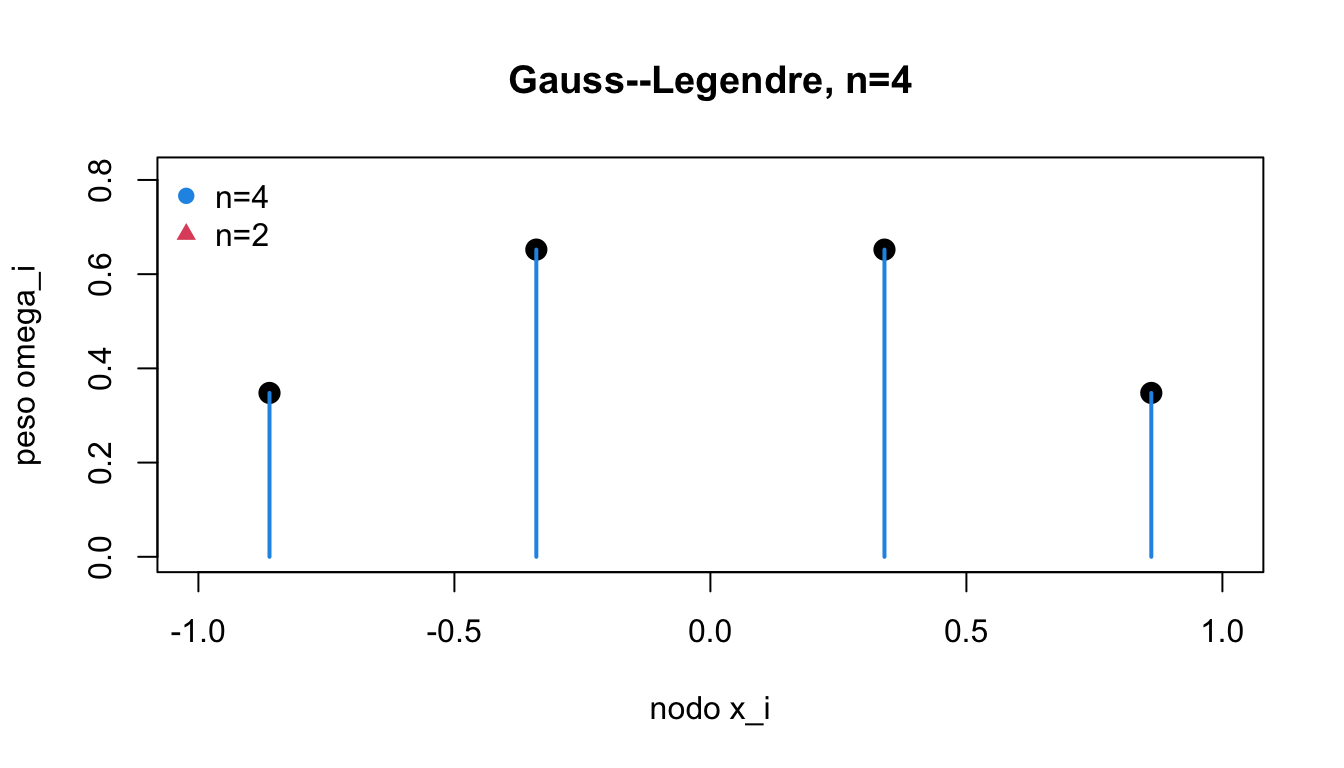
Figura 18.2: Nodi e pesi della formula di Gauss–Legendre a quattro punti. I nodi sono gli zeri di P_4, interni e simmetrici; i pesi sono tutti positivi, più grandi al centro e più piccoli vicino agli estremi, e la loro somma vale 2, cioè l’integrale del peso w\equiv1.

Esempio: costruzione e verifica in R base

gauss_legendre <- function(n) {
  k<-seq_len(n-1); off<-k/sqrt(4*k^2-1); J<-matrix(0,n,n)
  J[cbind(k,k+1)]<-off; J[cbind(k+1,k)]<-off
  e<-eigen(J,symmetric=TRUE); o<-order(e$values)
  list(x=e$values[o],w=2*e$vectors[1,o]^2)
}
g2<-gauss_legendre(2); g4<-gauss_legendre(4)
plot(g4$x,g4$w,pch=19,cex=1.4,xlim=c(-1,1),ylim=c(0,max(g4$w)*1.25),
     xlab="nodo x_i",ylab="peso omega_i",main="Gauss--Legendre, n=4")
segments(g4$x,0,g4$x,g4$w,col=4,lwd=2)
points(g2$x,g2$w,pch=17,col=2,cex=1.3)
legend("topleft",c("n=4","n=2"),pch=c(19,17),col=c(4,2),bty="n")
moments<-sapply(0:7,function(k)sum(g4$w*g4$x^k))
exact<-sapply(0:7,function(k)if(k%%2==0)2/(k+1) else 0)
Figura 18.3: Nodi e pesi della formula di Gauss–Legendre a quattro punti, calcolati dagli autovalori della matrice di Jacobi.
Tabella 18.1: Quattro nodi integrano esattamente i monomi fino al grado 7.
grado integrale_Gauss esatto errore
0 2.0000000 2.0000000 0
1 0.0000000 0.0000000 0
2 0.6666667 0.6666667 0
3 0.0000000 0.0000000 0
4 0.4000000 0.4000000 0
5 0.0000000 0.0000000 0
6 0.2857143 0.2857143 0
7 0.0000000 0.0000000 0

Quattro nodi devono integrare esattamente i monomi fino al grado 7, a precisione floating point. Il test non dimostra il teorema, ma controlla una conseguenza della costruzione.

Gli stessi nodi e pesi verificano 18.5: i pesi coincidono con i reciproci della funzione di Christoffel calcolata nei nodi.

Tabella 18.2: Verifica di 18.5 per Gauss–Legendre con n=6.
nodo peso reciproco_di_K differenza
-0.9324695 0.1713245 0.1713245 0
-0.6612094 0.3607616 0.3607616 0
-0.2386192 0.4679139 0.4679139 0
0.2386192 0.4679139 0.4679139 0
0.6612094 0.3607616 0.3607616 0
0.9324695 0.1713245 0.1713245 0

18.3 Gauss–Jacobi e cambio di intervallo

Peso di Jacobi e mappa affine

Per il peso (1-x)^\alpha(1+x)^\beta, i nodi di Gauss–Jacobi sono gli zeri di P_n^{(\alpha,\beta)}. Anche qui Golub–Welsch si applica alla matrice tridiagonale simmetrica della ricorrenza ortonormale. Per la ricorrenza monica, i coefficienti sono, ponendo s=\alpha+\beta, b_0=\frac{\beta-\alpha}{s+2},\qquad b_k=\frac{\beta^2-\alpha^2}{(2k+s)(2k+s+2)}\ (k\ge1), a_1^2=\frac{4(1+\alpha)(1+\beta)}{(s+2)^2(s+3)},\qquad a_k^2=\frac{4k(k+\alpha)(k+\beta)(k+s)} {(2k+s)^2(2k+s+1)(2k+s-1)},\quad k\ge2. Il caso k=1 è scritto a parte non per distrazione: sostituendo k=1 nella formula generale i fattori (k+s) e (2k+s-1) si semplificano e si ritrova esattamente a_1^2, tranne quando s=\alpha+\beta=-1, dove entrambi si annullano e la forma generale diventa 0/0. È precisamente il caso di Chebyshev di prima specie (\alpha=\beta=-\tfrac12), e la formula separata serve a coprirlo.

I pesi finali sono \mu_0|v_{1i}|^2, con \mu_0=2^{s+1}B(\alpha+1,\beta+1). La trasformazione a [a,b] è t_i=(a+b)/2+(b-a)x_i/2 e moltiplica i pesi per (b-a)/2; se l’integrale originario ha un suo peso, anche questo si trasforma.

Esempio: Gauss–Jacobi asimmetrica

Il codice usa la formula generale di Golub–Welsch e confronta i momenti pesati fino al grado 2n-1. I momenti esatti si calcolano espandendo x^k=(2u-1)^k, u=(x+1)/2, e usando la funzione Beta.

beta_fn <- function(a,b) exp(lgamma(a)+lgamma(b)-lgamma(a+b))
gauss_jacobi <- function(n,alpha,beta) {
  s<-alpha+beta
  b<-numeric(n); b[1]<-(beta-alpha)/(s+2)
  if(n>1) for(j in 1:(n-1))
    b[j+1]<-(beta^2-alpha^2)/((2*j+s)*(2*j+s+2))
  off<-numeric(max(0,n-1))
  if(n>1) {
    off[1]<-sqrt(4*(1+alpha)*(1+beta)/((s+2)^2*(s+3)))
    if(n>2) {
      k<-2:(n-1)
      off[k]<-sqrt(4*k*(k+alpha)*(k+beta)*(k+s)/
        ((2*k+s)^2*(2*k+s+1)*(2*k+s-1)))
    }
  }
  J<-diag(b,n,n)
  if(n>1){idx<-seq_len(n-1);J[cbind(idx,idx+1)]<-off;J[cbind(idx+1,idx)]<-off}
  e<-eigen(J,symmetric=TRUE);o<-order(e$values)
  mu0<-2^(s+1)*beta_fn(alpha+1,beta+1)
  list(x=e$values[o],w=mu0*e$vectors[1,o]^2)
}
alpha<-0.4; beta<-1.1; n<-4; gj<-gauss_jacobi(n,alpha,beta)
moment_jacobi <- function(k,alpha,beta) {
  sum(sapply(0:k,function(j)choose(k,j)*2^j*(-1)^(k-j)*
    beta_fn(beta+j+1,alpha+1))) * 2^(alpha+beta+1)
}
approx<-sapply(0:(2*n-1),function(k)sum(gj$w*gj$x^k))
exact<-sapply(0:(2*n-1),moment_jacobi,alpha=alpha,beta=beta)
knitr::kable(data.frame(k=0:(2*n-1),gauss_jacobi=approx,integrale_esatto=exact,
           errore_assoluto=abs(approx-exact)))
Tabella 18.3: Verifica dei momenti di Gauss–Jacobi con alpha=0.4, beta=1.1 e n=4.
k gauss_jacobi integrale_esatto errore_assoluto
0 1.5804651 1.5804651 0
1 0.3160930 0.3160930 0
2 0.4003845 0.4003845 0
3 0.1659009 0.1659009 0
4 0.2026591 0.2026591 0
5 0.1073954 0.1073954 0
6 0.1280556 0.1280556 0
7 0.0772643 0.0772643 0

beta_fn calcola la funzione Beta B(a,b)=\Gamma(a)\Gamma(b)/\Gamma(a+b) (la Gamma è la Definizione 15.1) passando per i logaritmi: la forma diretta gamma(a)*gamma(b)/gamma(a+b) va in overflow già per a,b\gtrsim 170, mentre exp(lgamma(a)+lgamma(b)-lgamma(a+b)) resta stabile. In R si può usare direttamente beta() o lbeta().

Esempio: i coefficienti di una serie ortogonale

In Capitolo 17 i coefficienti c_k=\langle f,\phi_k\rangle_w sono stati calcolati con una regola del punto medio su decine di migliaia di punti, per non anticipare risultati non ancora dimostrati. Ora possiamo fare molto meglio. La funzione f\phi_k con f=e^x non è un polinomio, quindi il teorema di esattezza non si applica alla lettera, ma per una funzione analitica l’accuratezza della formula gaussiana resta eccellente.

d <- 8
coef_gauss <- function(n) {
  g <- gauss_legendre(n)
  Phi <- legendre_matrix_orthonormal(d, g$x)
  colSums(sweep(Phi, 1, g$w*exp(g$x), `*`))
}
coef_midpoint <- function(m) {
  xq <- -1 + (seq_len(m) - 0.5)*2/m
  Phi <- legendre_matrix_orthonormal(d, xq)
  colSums(sweep(Phi, 1, (2/m)*exp(xq), `*`))
}
riferimento <- coef_gauss(80)
knitr::kable(data.frame(
  regola = c("punto medio, m=1000", "punto medio, m=20000",
             "Gauss--Legendre, n=10", "Gauss--Legendre, n=20"),
  valutazioni_di_f = c(1000, 20000, 10, 20),
  errore_massimo = c(max(abs(coef_midpoint(1000) - riferimento)),
                     max(abs(coef_midpoint(20000) - riferimento)),
                     max(abs(coef_gauss(10)     - riferimento)),
                     max(abs(coef_gauss(20)     - riferimento)))))
Tabella 18.4: Coefficienti di Legendre di exp(x) fino al grado 8: errore massimo del punto medio composito e della quadratura di Gauss, a parità di coefficienti calcolati.
regola valutazioni_di_f errore_massimo
punto medio, m=1000 1000 5.51e-05
punto medio, m=20000 20000 1.00e-07
Gauss–Legendre, n=10 10 0.00e+00
Gauss–Legendre, n=20 20 0.00e+00

Dieci nodi di Gauss battono ventimila valutazioni del punto medio, e con venti si arriva alla precisione macchina. La ragione è il teorema di esattezza: il punto medio composito converge come O(m^{-2}), mentre su una funzione analitica la formula gaussiana converge in modo spettrale. Il prezzo è che i nodi cambiano con n e non si possono riutilizzare quando si raffina.

18.4 Errore e varianti con nodi vincolati

Se f\in C^{2n}[-1,1], l’errore di Gauss–Legendre ammette la forma \int_{-1}^1 f(x)\,\mathrm dx-Q_n(f)= \frac{f^{(2n)}(\xi)}{(2n)!} \int_{-1}^1\left(\prod_{i=1}^n(x-x_i)\right)^2\,\mathrm dx, \qquad \xi\in(-1,1). Per Jacobi vale una forma analoga integrando il quadrato del polinomio monico d’errore contro il peso. La formula spiega l’esattezza massima; la dimensione concreta dell’errore dipende dalla derivata e dalla regolarità della funzione.

Se è necessario includere un estremo, Gauss–Radau6 fissa un nodo in uno dei capi e raggiunge esattezza 2n-2 con n nodi. Se si fissano entrambi gli estremi, Gauss–Lobatto7 raggiunge 2n-3. La ragione è ancora ortogonalità: i nodi interni sono gli zeri dei polinomi di grado n-1 o n-2 ortogonali rispetto ai pesi modificati (1\mp x)w(x) o (1-x^2)w(x).

In sintesi

  • Scegliere come nodi gli zeri del polinomio ortogonale raddoppia il grado di esattezza, da n-1 a 2n-1, e 2n-1 è il massimo possibile con n nodi.
  • I pesi gaussiani sono sempre positivi, quindi la formula è stabile a ogni ordine: è la differenza sostanziale rispetto a Newton-Cotes.
  • In pratica nodi e pesi non si calcolano dagli zeri di p_n, ma come autovalori e prime componenti degli autovettori della matrice di Jacobi (Golub–Welsch).
  • Cambiare peso significa cambiare famiglia ortogonale: Gauss–Jacobi integra esattamente le singolarità (1\mp x)^{\alpha,\beta} agli estremi, che una formula a peso costante risolverebbe male.
  • Radau e Lobatto scambiano grado di esattezza con il controllo di uno o due nodi agli estremi, utile quando servono i valori al bordo.

18.5 Esercizi

  1. Dimostrare che n nodi non possono dare esattezza oltre 2n-1.
  2. Perché i pesi di Gauss sono positivi?
  3. Confrontare Gauss, Radau e Lobatto per lo stesso numero di nodi.
  4. Applicare i nodi a \int_0^1 e^x\,\mathrm dx dopo una mappa lineare; confrontare con l’integrale esatto e-1.
  5. Riprendere l’esercizio 5 di Capitolo 11 e verificare numericamente le stime a priori là ottenute per Gauss–Legendre con 2,3,4,5 nodi.
  6. Calcolare \int_{-1}^1(1-x)^{-1/2}\cos x\,\mathrm dx con Gauss–Legendre e con Gauss–Jacobi (\alpha=-1/2,\beta=0) a parità di nodi, e spiegare la differenza.

  1. Carl Friedrich Gauss (1777-1855)↩︎

  2. Joseph-Louis Lagrange (1736-1813)↩︎

  3. Adrien-Marie Legendre (1752-1833)↩︎

  4. Gene Howard Golub (1932-2007)↩︎

  5. John H. Welsch↩︎

  6. Rodolphe Radau (1835-1911)↩︎

  7. Rehuel Lobatto (1797-1866)↩︎