16  Ricorrenze, zeri e stabilità

Autore/Autrice
Affiliazione

Enrico Bertolazzi

University of Trento, Department of Industrial Engineering

16.1 La ricorrenza a tre termini

Dall’ortogonalità alla ricorrenza

Sia \{\phi_k\}_{k\ge0} una famiglia ortonormale, con coefficiente principale positivo, rispetto a un peso positivo su un intervallo reale. Ortonormale significa

\langle\phi_j,\phi_k\rangle_w= \begin{cases} 1 & \text{se } j=k,\\ 0 & \text{se } j\ne k, \end{cases} \tag{16.1}

e \deg\phi_k=k, cosicché \phi_0,\ldots,\phi_m è una base ortonormale di \mathcal P_m per ogni m.

La moltiplicazione per x ha allora una rappresentazione tridiagonale

x\,\phi_k(x)=a_{k+1}\phi_{k+1}(x)+b_k\phi_k(x)+a_k\phi_{k-1}(x), \qquad a_k>0, \tag{16.2}

con la convenzione a_0=0, \phi_{-1}=0. Vale la pena vedere perché, in tre righe. Il polinomio x\phi_k ha grado k+1, dunque si scrive in modo unico nella base \phi_0,\ldots,\phi_{k+1}:

x\,\phi_k=\sum_{j=0}^{k+1}c_{kj}\,\phi_j, \qquad c_{kj}=\langle x\phi_k,\phi_j\rangle_w .

La chiave è che il fattore x può essere spostato da una parte all’altra del prodotto scalare, perché moltiplicare per x non tocca il peso:

\langle x\phi_k,\phi_j\rangle_w =\int_a^b x\,\phi_k(x)\,\phi_j(x)\,w(x)\,\mathrm dx =\langle\phi_k,x\phi_j\rangle_w .

Se j\le k-2 il polinomio x\phi_j ha grado j+1\le k-1<k, quindi è combinazione di \phi_0,\ldots,\phi_{k-1} e il prodotto scalare con \phi_k è nullo: c_{kj}=0. Sopravvivono solo tre coefficienti,

b_k=\langle x\phi_k,\phi_k\rangle_w,\qquad a_k=\langle x\phi_{k-1},\phi_k\rangle_w=\langle x\phi_k,\phi_{k-1}\rangle_w,

e lo stesso scambio mostra che il coefficiente di \phi_{k-1} in x\phi_k coincide con quello di \phi_{k+1} in x\phi_{k-1}: è questo che rende la rappresentazione simmetrica. Infine a_k>0 perché, confrontando i coefficienti principali in 16.2, a_{k+1}=\kappa_k/\kappa_{k+1}>0, avendo indicato con \kappa_k>0 il coefficiente principale di \phi_k.

Il teorema di Favard

A questo punto è importante distinguere l’implicazione diretta da quella inversa: la prima è quanto appena visto, la seconda è un risultato profondo.

Teorema 16.1 (Ricorrenza a tre termini e teorema di Favard) (Verso diretto.) Sia \{\phi_k\}_{k\ge0} ortonormale rispetto a un peso positivo w, con \deg\phi_k=k e coefficiente principale positivo. Allora esistono numeri reali b_k e numeri a_k>0 tali che valga 16.2 per ogni k\ge0.

(Verso inverso, teorema di Favard.)1 Viceversa, si scelgano in modo del tutto arbitrario numeri reali b_0,b_1,\ldots e numeri positivi a_1,a_2,\ldots, e si definiscano i polinomi \phi_k per ricorrenza tramite 16.2, partendo da \phi_{-1}=0 e \phi_0=\text{cost}>0. Allora esiste una misura positiva sulla retta reale rispetto alla quale la famiglia così costruita è ortonormale.

Il verso diretto è stato dimostrato qui sopra (e, in altra normalizzazione, in Capitolo 15): è una conseguenza immediata dell’ortogonalità e dello scambio \langle x\phi_k,\phi_j\rangle_w=\langle\phi_k,x\phi_j\rangle_w.

Il verso inverso è il risultato non banale, e la sua dimostrazione — che costruisce la misura a partire dai coefficienti — esula da questo corso; si veda [1]. Il suo significato però è semplice da enunciare: la ricorrenza a tre termini caratterizza i polinomi ortogonali. Se una successione di polinomi obbedisce a una relazione di quella forma, con a_k>0, allora è una famiglia ortogonale per un qualche peso, anche se il peso non è stato nominato. Non esistono famiglie con quella struttura che non siano ortogonali, e non esistono famiglie ortogonali che non abbiano quella struttura.

La matrice di Jacobi

Vogliamo riscrivere la ricorrenza 16.2 come un prodotto matrice–vettore. Costruiamo la matrice un pezzo alla volta, partendo dalla ricorrenza stessa.

Primo: mettere la x a destra. La ricorrenza, così com’è scritta, esprime x\phi_k in funzione di tre polinomi consecutivi. Riordiniamola mettendo a sinistra i tre polinomi e a destra la moltiplicazione per x:

a_k\,\phi_{k-1}(x)+b_k\,\phi_k(x)+a_{k+1}\,\phi_{k+1}(x) \;=\;x\,\phi_k(x). \tag{16.3}

Nulla è cambiato, ma ora la 16.3 ha la forma «combinazione lineare di \phi = x per un \phi»: è una riga di un sistema lineare in cui le incognite sono i valori \phi_0(x),\phi_1(x),\ldots

Secondo: scrivere le righe una sotto l’altra. Fissiamo n e scriviamo la 16.3 per k=0,1,2,\ldots,n-1, ricordando le convenzioni a_0=0 e \phi_{-1}=0, che fanno sparire il primo termine quando k=0:

\begin{aligned} k=0:\quad & b_0\phi_0+a_1\phi_1 &&&&= x\,\phi_0,\\[2pt] k=1:\quad & a_1\phi_0+b_1\phi_1+a_2\phi_2 &&&&= x\,\phi_1,\\[2pt] k=2:\quad & a_2\phi_1+b_2\phi_2+a_3\phi_3 &&&&= x\,\phi_2,\\[2pt] & \qquad\qquad\ddots &&&&\ \ \vdots\\[2pt] k=n-2:\quad & a_{n-2}\phi_{n-3}+b_{n-2}\phi_{n-2}+a_{n-1}\phi_{n-1} &&&&= x\,\phi_{n-2},\\[2pt] k=n-1:\quad & a_{n-1}\phi_{n-2}+b_{n-1}\phi_{n-1}+a_n\phi_n &&&&= x\,\phi_{n-1}. \end{aligned} \tag{16.4}

Si osservino due cose. Le prime n-1 righe coinvolgono soltanto \phi_0,\ldots,\phi_{n-1}: sono n-1 equazioni «chiuse». L’ultima riga, quella con k=n-1, fa comparire in più il polinomio \phi_n, che non è fra le incognite: lo isoliamo portandolo a destra,

a_{n-1}\phi_{n-2}+b_{n-1}\phi_{n-1} = x\,\phi_{n-1}-a_n\,\phi_n .

Terzo: leggere i coefficienti riga per riga. Raccogliamo le incognite nel vettore colonna

\Phi(x)=\begin{pmatrix}\phi_0(x)\\ \phi_1(x)\\ \vdots\\ \phi_{n-1}(x)\end{pmatrix} \in\Re^{n},

e numeriamo righe e colonne da 0 a n-1, come i polinomi. Nella riga k di 16.4 i coefficienti non nulli sono soltanto tre, e occupano le colonne k-1, k e k+1:

\underbrace{a_k}_{\text{colonna } k-1},\qquad \underbrace{b_k}_{\text{colonna } k},\qquad \underbrace{a_{k+1}}_{\text{colonna } k+1}.

Tutte le altre colonne hanno coefficiente zero. Una matrice i cui elementi non nulli stanno solo sulla diagonale e sulle due diagonali immediatamente adiacenti si dice tridiagonale.

Quarto: la matrice. Mettendo insieme i coefficienti delle n righe si ottiene la matrice di Jacobi

J_n= \begin{pmatrix} b_0 & a_1 & & & \\ a_1 & b_1 & a_2 & & \\ & a_2 & b_2 & \ddots & \\ & & \ddots & \ddots & a_{n-1} \\ & & & a_{n-1} & b_{n-1} \end{pmatrix} \in\Re^{n\times n}, \tag{16.5}

dove le caselle lasciate in bianco valgono zero. La matrice è simmetrica e non per caso: l’elemento di posto (k,k-1) vale a_k perché è il coefficiente di \phi_{k-1} nella riga k; l’elemento di posto (k-1,k) vale a_{(k-1)+1}=a_k perché è il coefficiente di \phi_k nella riga k-1. Sono lo stesso numero, ed è questa la ragione per cui conviene lavorare con i polinomi ortonormali: in un’altra normalizzazione i due coefficienti sarebbero diversi e la matrice non sarebbe simmetrica.

Con questa notazione le n equazioni 16.4 si riassumono in una sola:

J_n\,\Phi(x)=x\,\Phi(x)-a_n\,\phi_n(x)\,e_n, \tag{16.6}

dove e_n=(0,\ldots,0,1)^T è l’ultimo vettore della base canonica: il termine di disturbo -a_n\phi_n(x) compare infatti solo nell’ultima riga. Scritta per esteso con n=4, la 16.6 è

\begin{pmatrix} b_0 & a_1 & 0 & 0 \\ a_1 & b_1 & a_2 & 0 \\ 0 & a_2 & b_2 & a_3\\ 0 & 0 & a_3 & b_3 \end{pmatrix} \begin{pmatrix}\phi_0(x)\\ \phi_1(x)\\ \phi_2(x)\\ \phi_3(x)\end{pmatrix} =x\begin{pmatrix}\phi_0(x)\\ \phi_1(x)\\ \phi_2(x)\\ \phi_3(x)\end{pmatrix} -a_4\,\phi_4(x)\begin{pmatrix}0\\0\\0\\1\end{pmatrix}.

Quinto: gli zeri sono autovalori. A questo punto la conclusione si legge da sola. Se x è uno zero di \phi_n, allora \phi_n(x)=0, il termine di disturbo sparisce e 16.6 diventa

J_n\,\Phi(x)=x\,\Phi(x).

Il vettore \Phi(x) non è nullo, perché la sua prima componente \phi_0 è una costante diversa da zero. Dunque \Phi(x) è un autovettore di J_n e x è il corrispondente autovalore.

Gli n zeri di \phi_n sono quindi autovalori di J_n; poiché una matrice n\times n ha esattamente n autovalori, sono tutti e soli gli autovalori di J_n. Da qui si leggono subito due proprietà:

  • sono reali, perché J_n è simmetrica a elementi reali;
  • sono semplici, perché una matrice tridiagonale simmetrica con tutti gli elementi extradiagonali non nulli (a_k>0) ha autovalori distinti.

La Sezione 16.2 ridimostra gli stessi fatti, e in più la localizzazione dentro l’intervallo, con un argomento di sola integrazione. Per i polinomi di Legendre ortonormali si ha

b_k=0, \qquad a_k=\frac{k}{\sqrt{(2k-1)(2k+1)}}=\frac{k}{\sqrt{4k^2-1}}, \tag{16.7}

i b_k essendo nulli per la simmetria del peso. È su questa matrice che si basa l’algoritmo di Golub–Welsch di Capitolo 18: calcolare i nodi di una formula gaussiana si riduce a calcolare gli autovalori di una matrice tridiagonale simmetrica, problema per cui esistono algoritmi rapidi e stabili.

16.2 Gli zeri dei polinomi ortogonali

Zeri reali, interni e semplici

Teorema 16.2 (Localizzazione degli zeri) Sia w un peso positivo su (a,b) e sia p_n, con n\ge1, il polinomio di grado n della famiglia ortogonale associata. Allora p_n ha n zeri

a<x_1<x_2<\cdots<x_n<b ,

cioè n zeri reali e distinti (quindi tutti semplici), tutti interni all’intervallo (a,b). In particolare p_n non ha radici complesse, né radici fuori da (a,b), né radici multiple.

Dimostrazione. Useremo una sola volta, ma ripetutamente, la proprietà che definisce p_n:

\langle p_n,q\rangle_w=\int_a^b p_n(x)\,q(x)\,w(x)\,\mathrm dx=0 \qquad\text{per ogni } q \text{ con } \deg q<n, \tag{16.8}

vera perché ogni q di grado minore di n è combinazione lineare di p_0,\ldots,p_{n-1}, e p_n è ortogonale a ciascuno di essi.

Passo 0: un fatto elementare sugli integrali. Se f è continua su (a,b), non cambia mai segno — diciamo f\ge0 — e non è identicamente nulla, allora

\int_a^b f(x)\,w(x)\,\mathrm dx>0 . \tag{16.9}

Infatti esiste \bar x\in(a,b) con f(\bar x)>0; per continuità esiste un intervallino [\bar x-\delta,\bar x+\delta]\subset(a,b) su cui f>f(\bar x)/2, e quindi

\int_a^b f\,w\ \ge\ \int_{\bar x-\delta}^{\bar x+\delta} f\,w \ \ge\ \frac{f(\bar x)}{2}\int_{\bar x-\delta}^{\bar x+\delta}w \ >\ 0,

perché l’integrale di un peso positivo su un intervallo di lunghezza non nulla è positivo. Se invece f\le0 si conclude allo stesso modo che l’integrale è strettamente negativo. In breve: l’integrale pesato di una funzione di segno costante e non nulla non può annullarsi.

Passo 1: p_n cambia segno almeno una volta in (a,b). Applichiamo 16.8 con q\equiv1, lecito perché \deg q=0<n:

\int_a^b p_n(x)\,w(x)\,\mathrm dx=0 .

Se p_n avesse segno costante su (a,b), il Passo 0 darebbe un integrale diverso da zero. Dunque p_n assume sia valori positivi sia valori negativi e, essendo continua, cambia segno: per il teorema degli zeri ha almeno una radice in (a,b) in cui il segno si inverte.

Passo 2: i punti di cambio di segno sono almeno n. Siano x_1<x_2<\cdots<x_r i punti di (a,b) in cui p_n cambia segno. Il Passo 1 garantisce r\ge1. Supponiamo per assurdo r<n e costruiamo il polinomio

q(x)=(x-x_1)(x-x_2)\cdots(x-x_r), \qquad \deg q=r<n .

Osserviamo che q, prodotto di fattori lineari distinti, cambia segno esattamente negli stessi punti x_1,\ldots,x_r e in nessun altro. Allora il prodotto p_n\,q non cambia mai segno in (a,b): fra due punti consecutivi x_j e x_{j+1} entrambi i fattori mantengono il loro segno, e attraversando x_{j+1} entrambi lo invertono, sicché il prodotto lo conserva. Gli eventuali altri zeri di p_n interni a (a,b) non creano problemi: per definizione di x_1,\ldots,x_r in essi il segno non cambia, il prodotto si annulla e poi riprende il segno di prima.

Il polinomio p_nq non è identicamente nullo (è il prodotto di due polinomi non nulli) e ha segno costante: per il Passo 0

\langle p_n,q\rangle_w=\int_a^b p_n\,q\,w\ \ne\ 0 .

Ma \deg q=r<n, e 16.8 impone invece \langle p_n,q\rangle_w=0. Contraddizione. Resta dunque r\ge n.

Passo 3: sono esattamente n, e sono tutti gli zeri. Ogni punto di cambio di segno è una radice reale di p_n interna a (a,b), e punti distinti sono radici distinte: abbiamo quindi almeno n radici reali distinte. D’altra parte p_n ha grado n, e un polinomio di grado n non può avere più di n radici distinte. Dunque r=n esattamente.

Per il teorema fondamentale dell’algebra p_n ha n radici contate con la loro molteplicità: le n radici distinte appena trovate le esauriscono tutte. Non ne restano di complesse, non ne restano fuori da (a,b), e nessuna può essere multipla, perché una radice doppia consumerebbe due unità di molteplicità lasciandone meno di n per le altre.

Questo risultato è ciò che rende possibile la quadratura gaussiana di Capitolo 18, perché i nodi di una formula a n punti devono stare dentro l’intervallo di integrazione ed essere distinti, e qui lo sono per costruzione.

Separazione degli zeri di gradi consecutivi

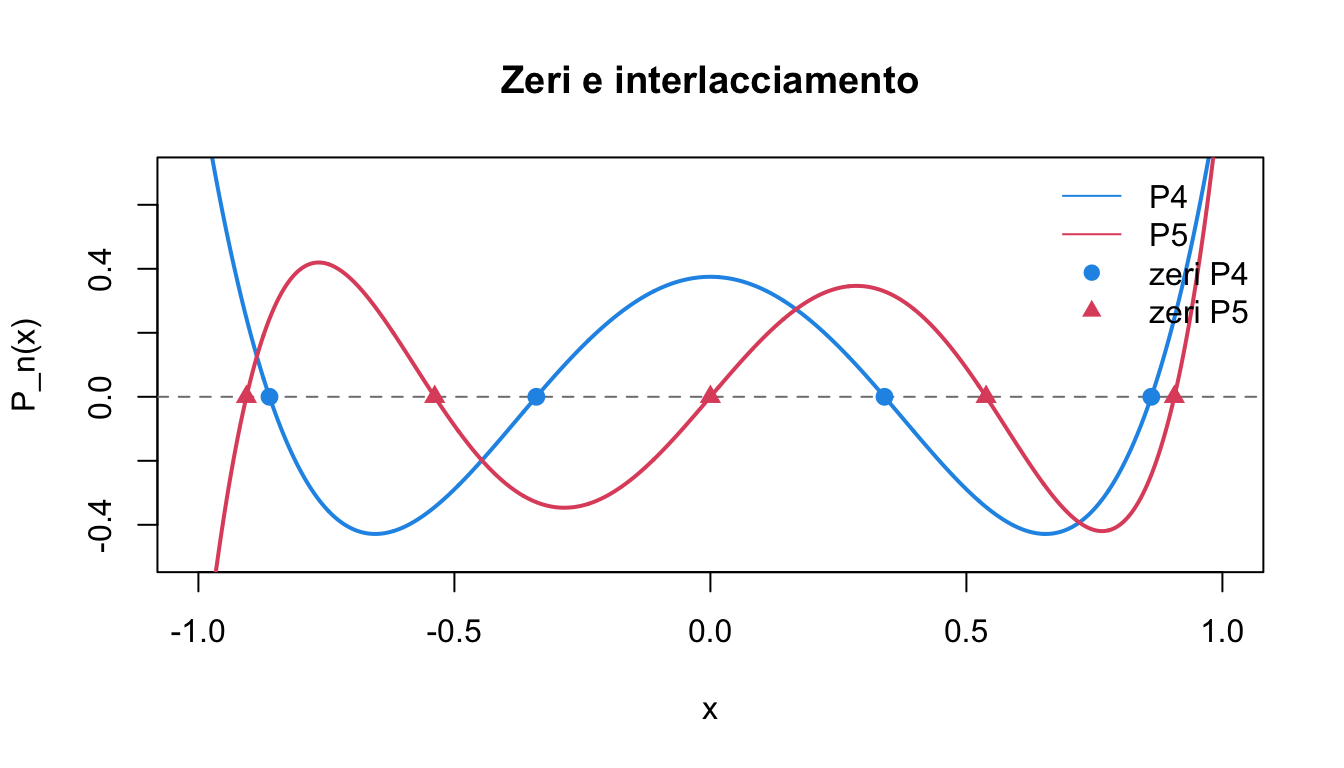
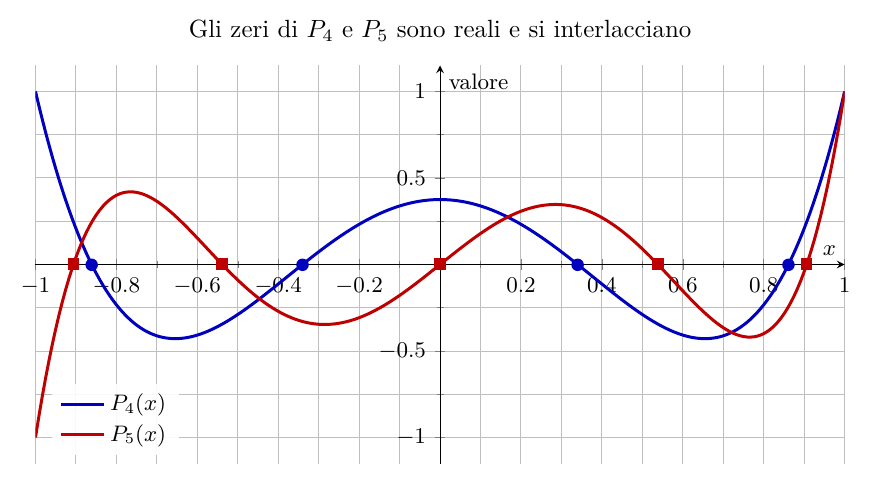
Per i polinomi monici la ricorrenza si scrive \pi_{n+1}(x)=(x-b_n)\pi_n(x)-a_n^2\pi_{n-1}(x),\qquad a_n>0. Due polinomi consecutivi non hanno zeri comuni: se \pi_n e \pi_{n+1} si annullassero entrambi in x, la ricorrenza forzerebbe \pi_{n-1}(x)=0 e, iterando all’indietro, \pi_0(x)=0, impossibile. Inoltre, tutti gli zeri di entrambi sono interni al supporto, come appena dimostrato. La matrice J_n è il minore principale iniziale di J_{n+1}. Il teorema di interlacciamento di Cauchy2 dà interlacciamento debole; l’assenza di autovalori comuni lo rende stretto: fra due zeri consecutivi di \pi_{n+1} cade esattamente uno zero di \pi_n, e inoltre il più piccolo zero di \pi_{n+1} sta a sinistra del più piccolo di \pi_n, il più grande a destra del più grande. In altri termini gli n+1 zeri di \pi_{n+1} separano gli n zeri di \pi_n e li racchiudono.

Figura 16.1: Gli zeri dei polinomi di Legendre di grado 4 e 5 si alternano.

La Figura 16.1 illustra il risultato; nella Figura 16.2 si visualizzano le due famiglie di zeri insieme alle curve.

nodes_legendre <- function(n) {
  k<-seq_len(n-1); off<-k/sqrt(4*k^2-1); J<-matrix(0,n,n)
  J[cbind(k,k+1)]<-off; J[cbind(k+1,k)]<-off
  sort(eigen(J,symmetric=TRUE,only.values=TRUE)$values)
}
x<-seq(-1,1,length.out=2001)
plot(x,legendre(4,x),type="l",lwd=2,col=4,ylim=c(-0.5,0.7),
     xlab="x",ylab="P_n(x)",main="Zeri e interlacciamento")
lines(x,legendre(5,x),lwd=2,col=2); abline(h=0,col="gray50",lty=2)
points(nodes_legendre(4),rep(0,4),pch=19,col=4,cex=1.1)
points(nodes_legendre(5),rep(0,5),pch=17,col=2,cex=1.1)
legend("topright",c("P4","P5","zeri P4","zeri P5"),
       col=c(4,2,4,2),lty=c(1,1,NA,NA),pch=c(NA,NA,19,17),bty="n")
Figura 16.2: P4 e P5 e i rispettivi zeri: tra ogni coppia di zeri di P4 cade uno zero di P5.

16.3 Polinomi del nucleo e minimo vincolato

Il nucleo e la proprietà riproducente

Lavorando con la famiglia ortonormale \phi_k si incontra di continuo una somma che conviene battezzare subito:

K_n(x,y)=\sum_{k=0}^{n}\phi_k(x)\,\phi_k(y) \tag{16.10}

è il polinomio del nucleo di grado n. (Di questa somma esiste anche una forma chiusa, la formula di Christoffel–Darboux, che non serve nel seguito ed è riportata in Sezione A.3.) Il nome viene dalla sua proprietà riproducente: per ogni p\in\mathcal P_n,

\langle p,K_n(\cdot,y)\rangle_w =\sum_{k=0}^n\langle p,\phi_k\rangle_w\,\phi_k(y)=p(y), \tag{16.11}

perché la somma a destra è esattamente lo sviluppo di p nella base ortonormale. In altri termini K_n(\cdot,y) è il vettore che, nel prodotto scalare, valuta in y.

Il polinomio di norma minima vincolata

Da quella sola osservazione segue un risultato che useremo due volte.

Teorema 16.3 (Polinomio di norma minima con un vincolo) Siano n\ge0 e x_0\in\Re un punto qualunque. Fra tutti i polinomi p\in\mathcal P_n che soddisfano il vincolo

p(x_0)=1, \tag{16.12}

ne esiste uno e uno solo di norma \|\cdot\|_w minima, ed è

p^\star(x)=\frac{K_n(x_0,x)}{K_n(x_0,x_0)} , \qquad\text{con}\qquad \|p^\star\|_w=\frac{1}{\sqrt{K_n(x_0,x_0)}} . \tag{16.13}

Nota

Il denominatore non si annulla mai. Infatti, per 16.10,

K_n(x_0,x_0)=\sum_{k=0}^n\phi_k(x_0)^2\ \ge\ \phi_0(x_0)^2>0,

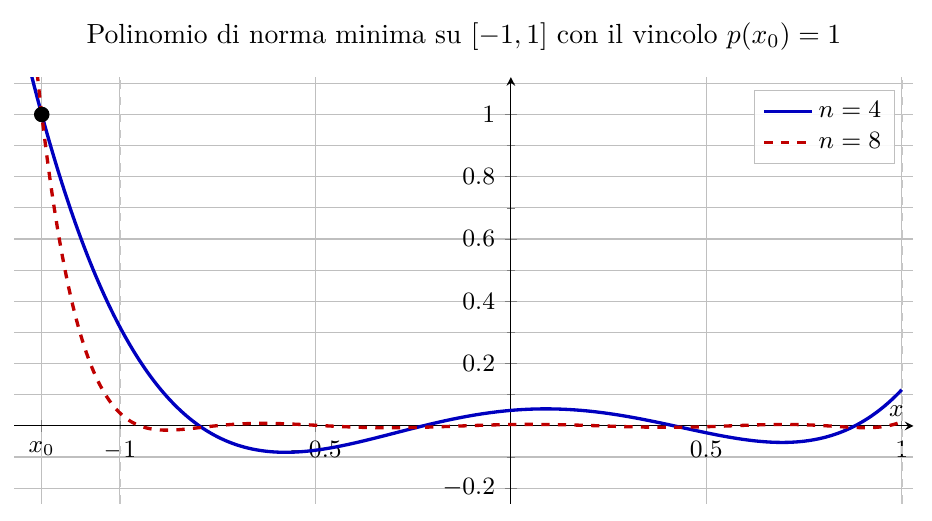
perché \phi_0 è una costante non nulla. La formula 16.13 ha quindi senso per ogni x_0 reale, anche fuori dall’intervallo (a,b): è il caso interessante, come mostra la Figura 16.3.

Dimostrazione. Passo 1: il vincolo si legge come un prodotto scalare. Per la proprietà riproducente 16.11, ogni p\in\mathcal P_n soddisfa p(x_0)=\langle p,K_n(\cdot,x_0)\rangle_w. Il vincolo 16.12 diventa dunque

\langle p,\,K_n(\cdot,x_0)\rangle_w=1 . \tag{16.14}

Geometricamente: fra tutti i vettori la cui proiezione sulla direzione fissata K_n(\cdot,x_0) ha lunghezza assegnata, si cerca il più corto. La risposta, in qualunque spazio con prodotto scalare, è il vettore parallelo a quella direzione — ed è esattamente ciò che la dimostrazione formalizza.

Passo 2: la lunghezza della direzione. Il polinomio K_n(\cdot,x_0) appartiene a \mathcal P_n, quindi la la proprietà riproducente si può applicare al polinomio stesso, con p=K_n(\cdot,x_0) e valutando in y=x_0:

\|K_n(\cdot,x_0)\|_w^2 =\big\langle K_n(\cdot,x_0),K_n(\cdot,x_0)\big\rangle_w =K_n(x_0,x_0). \tag{16.15}

Passo 3: la minorazione. Applichiamo la disuguaglianza di Cauchy–Schwarz |\langle f,g\rangle_w|\le\|f\|_w\|g\|_w a 16.14, e poi 16.15:

1=\big|\langle p,K_n(\cdot,x_0)\rangle_w\big| \le\|p\|_w\,\|K_n(\cdot,x_0)\|_w =\|p\|_w\sqrt{K_n(x_0,x_0)} .

Dividendo per \sqrt{K_n(x_0,x_0)}>0 si ottiene, per ogni p ammissibile,

\|p\|_w\ \ge\ \frac{1}{\sqrt{K_n(x_0,x_0)}} . \tag{16.16}

Nessun polinomio ammissibile può dunque scendere sotto quella soglia.

Passo 4: la soglia è raggiunta, e da un solo polinomio. Il candidato p^\star di 16.13 è ammissibile, perché

p^\star(x_0)=\frac{K_n(x_0,x_0)}{K_n(x_0,x_0)}=1,

e la sua norma vale, ancora per 16.15,

\|p^\star\|_w=\frac{\|K_n(\cdot,x_0)\|_w}{K_n(x_0,x_0)} =\frac{\sqrt{K_n(x_0,x_0)}}{K_n(x_0,x_0)} =\frac{1}{\sqrt{K_n(x_0,x_0)}} ,

cioè esattamente il valore della soglia: il minimo è raggiunto.

Per l’unicità si usa il caso di uguaglianza in Cauchy–Schwarz: in |\langle f,g\rangle_w|=\|f\|_w\|g\|_w vale l’uguale se e solo se f e g sono proporzionali. Se dunque un p ammissibile realizza il minimo, allora p=c\,K_n(\cdot,x_0) per qualche costante c, e il vincolo p(x_0)=1 obbliga c\,K_n(x_0,x_0)=1, cioè c=1/K_n(x_0,x_0): si ritrova p=p^\star e nessun altro.

Figura 16.3: Polinomio di norma minima su [-1,1] con peso unitario, vincolato a valere 1 nel punto esterno x_0=-1.2: già per n=4 oscilla poco dentro l’intervallo, per n=8 pochissimo.

La Figura 16.3 mostra la configurazione tipica: il polinomio vale 1 appena fuori dall’intervallo e dentro è piccolo. È quello che serve quando si vuole un polinomio grande in un punto e piccolo su un intervallo — per esempio un polinomio di precondizionamento, dove x_0=0 e l’intervallo contiene lo spettro della matrice.

La funzione di Christoffel

La quantità

\lambda_n(x)=\frac{1}{K_n(x,x)} =\min\big\{\|p\|_w^2:\ p\in\mathcal P_n,\ p(x)=1\big\} \tag{16.17}

si chiama funzione di Christoffel. Tornerà in Capitolo 18, dove si vedrà che i pesi di una formula gaussiana non sono altro che i suoi valori nei nodi.

16.4 Stabilità della ricorrenza nel calcolo

Per calcolare un singolo P_n(x), la ricorrenza a tre termini costa O(n) operazioni e memoria costante, ed evita i coefficienti monomiali. Il limite analitico |P_n(x)|\le1 per x\in[-1,1] non è una prova di stabilità floating point: gli errori locali di arrotondamento si propagano secondo le due soluzioni indipendenti della ricorrenza e la sensibilità dipende da n e x. Nell’intervallo le soluzioni sono oscillanti e la ricorrenza in avanti è di norma adatta ai polinomi di Legendre, ma vicino a uno zero l’errore relativo resta intrinsecamente grande. Fuori dall’intervallo una componente dominante può sovrastare quella richiesta; quando si cerca la soluzione minimale di una ricorrenza, la direzione in avanti può essere instabile e si ricorre alla ricorrenza all’indietro di Miller, con riscalamento e normalizzazione. I coefficienti di una serie si valutano spesso con Clenshaw. Ogni affermazione di stabilità va quindi qualificata per grado, punto e quantità richiesta.

Per valutare una serie

s(x)=\sum_{k=0}^{n} c_k\,\phi_k(x)

si usa spesso l’algoritmo all’indietro di Clenshaw3. Partendo dalla ricorrenza ortonormale

x\phi_k=a_{k+1}\phi_{k+1}+b_k\phi_k+a_k\phi_{k-1},

si pongono d_{n+1}=d_{n+2}=0 e si calcola d_k=c_k+\frac{x-b_k}{a_{k+1}}d_{k+1} -\frac{a_{k+1}}{a_{k+2}}d_{k+2}, \quad k=n,n-1,\ldots,0, \qquad s(x)=\phi_0(x)d_0,

con la convenzione d_{n+1}=d_{n+2}=0; i coefficienti a_{n+1} e a_{n+2} non intervengono mai, perché moltiplicano termini nulli, e possono essere posti a 1 nell’implementazione. La procedura evita la somma esplicita di termini potenzialmente grandi e spesso migliora l’accuratezza; si devono usare coefficienti coerenti con la normalizzazione scelta. Non rimuove il condizionamento del problema né garantisce accuratezza relativa vicino a cancellazioni.

nn<-0:40; xx<-seq(-1,1,length.out=2001)
inside<-sapply(nn,function(n)max(abs(legendre(n,xx))))
outside<-sapply(nn,function(n)abs(legendre(n,1.2)))
plot(nn,inside,type="l",lwd=2,col=4,log="y",ylim=c(0.5,max(outside)),
     xlab="grado n",ylab="ampiezza (scala log)",main="Dominio di valutazione")
lines(nn,outside,lwd=2,col=2)
legend("topleft",c("max su [-1,1]","|P_n(1.2)|"),col=c(4,2),lwd=2,bty="n")
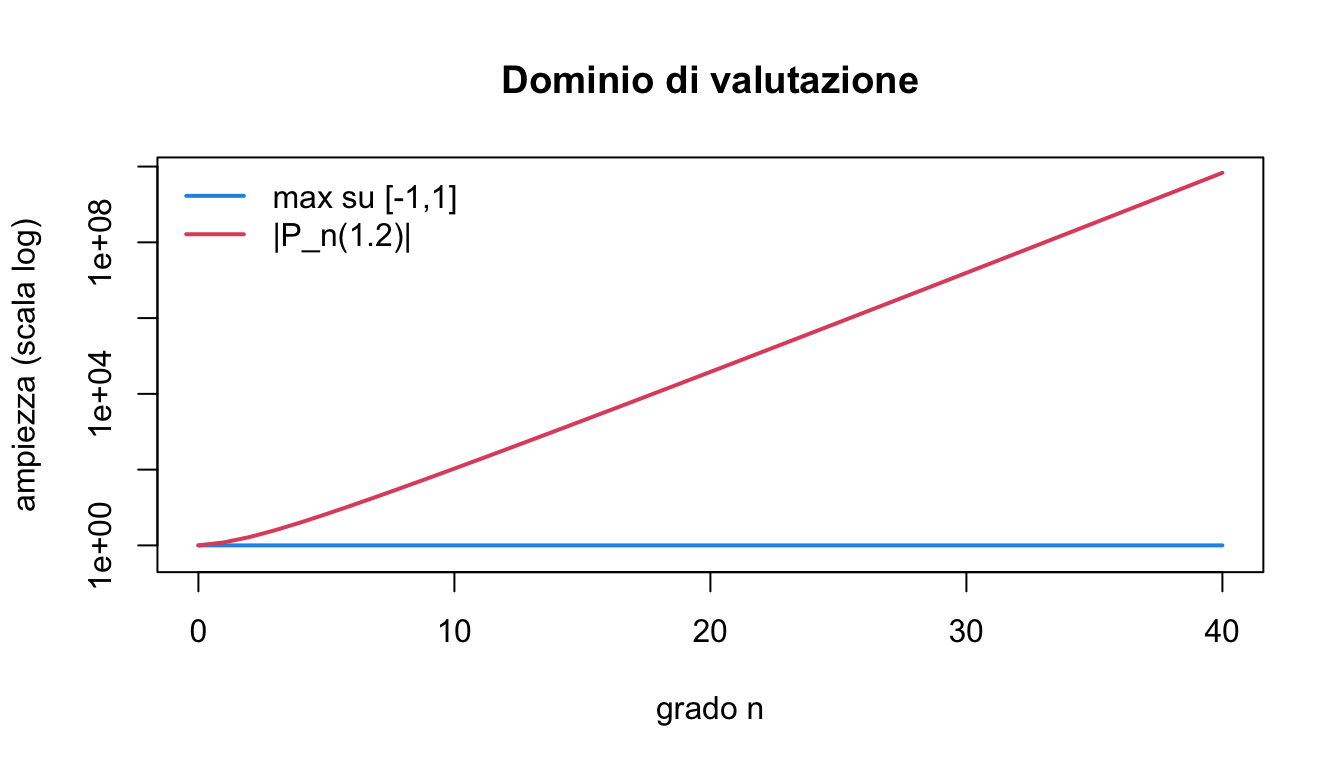
Figura 16.4: Massimo osservato su [-1,1] e valore in 1.2: fuori dal supporto la crescita è rapida.

La Figura 16.4 mostra valori calcolati per gradi finiti; non rappresenta una stima dell’errore di arrotondamento.

In sintesi

  • L’ortogonalità equivale alla ricorrenza a tre termini: il verso diretto è elementare, il viceversa è il teorema di Favard.
  • La stessa ricorrenza è una matrice tridiagonale simmetrica J_n, i cui autovalori sono gli zeri di p_n: zeri reali e semplici sono un fatto di algebra lineare, non di analisi.
  • Gli zeri di p_n e p_{n+1} si separano a vicenda (interlacciamento), conseguenza del teorema di Cauchy applicato al minore principale J_n di J_{n+1}.
  • Ricorrenza in avanti e algoritmo di Clenshaw costano O(n) e memoria costante, ma nessuno dei due garantisce accuratezza relativa: la stabilità va qualificata per grado, punto e quantità richiesta.
  • Il polinomio del nucleo K_n è il vettore che valuta in un punto: da questa sola proprietà segue in forma chiusa il polinomio di norma minima vincolato, e con esso i pesi delle formule gaussiane.
  • Simmetria, derivate, formula di Christoffel–Darboux e quadro di completezza non servono nei due capitoli che seguono e sono raccolti in Appendice A.

16.5 Esercizi

  1. Perché la matrice J_n è simmetrica? Perché gli zeri sono semplici?
  2. Spiegare la differenza tra errore assoluto e relativo vicino a uno zero.
  3. Dimostrare P_n(-x)=(-1)^nP_n(x) usando unicità e simmetria del peso.
  4. Quando è utile Clenshaw rispetto alla valutazione separata della base?
  5. Verificare numericamente l’interlacciamento per P_9 e P_{10} calcolando gli autovalori di J_9 e J_{10}.

  1. Jean Favard (1902-1965)↩︎

  2. Augustin-Louis Cauchy (1789-1857)↩︎

  3. Charles William Clenshaw (1926-2004)↩︎