
base_ortogonale <- function(x, n, w = rep(1, length(x))) {
  Q <- matrix(0, length(x), n + 1); Q[, 1] <- 1
  h <- numeric(n + 1); b <- numeric(n + 1); g <- numeric(n + 1)
  h[1] <- sum(w)
  for (k in seq_len(n) - 1) {              # costruisce q_{k+1}
    qk <- Q[, k + 1]
    b[k + 1] <- sum(w * x * qk^2) / h[k + 1]
    Q[, k + 2] <- if (k == 0) (x - b[1]) * qk else {
      g[k + 1] <- h[k + 1] / h[k]
      (x - b[k + 1]) * qk - g[k + 1] * Q[, k]
    }
    h[k + 2] <- sum(w * Q[, k + 2]^2)
  }
  list(Q = Q, h = h, beta = b, gamma = g)
}

fit_ortogonale <- function(x, y, n, w = rep(1, length(x))) {
  B <- base_ortogonale(x, n, w)
  d <- as.vector(crossprod(B$Q, w * y)) / B$h       # una divisione per grado
  c(B, list(d = d, fitted = as.vector(B$Q %*% d)))
}

valuta <- function(t, f) {                 # rifa` la ricorrenza nei punti t
  qp <- rep(0, length(t)); q <- rep(1, length(t)); s <- f$d[1] * q
  for (k in seq_along(f$d)[-1] - 1) {
    qn <- (t - f$beta[k]) * q - f$gamma[k] * qp
    qp <- q; q <- qn; s <- s + f$d[k + 1] * q
  }
  s
}17 Minimi quadrati con basi ortogonali
17.1 Il problema, e tre domande
Il punto di partenza è una situazione di laboratorio. Un esperimento ha prodotto molti punti (x_i,y_i) — diciamo un centinaio — e le ordinate sono rumorose: ogni y_i è il valore vero più un errore di misura. Non si vuole una curva che passi per tutti i punti, perché riprodurrebbe anche il rumore; si vuole il trend, cioè la curva liscia che i dati suggeriscono.
Lo strumento è il polinomio dei minimi quadrati di grado n, e il modo corretto di calcolarlo è la fattorizzazione QR. Finito? Non proprio: restano aperte tre domande, ed è attorno a queste che ruota il capitolo.
Prima domanda. La QR funziona con qualunque base. Ma se, invece dei monomi 1,x,x^2,\ldots, si usa una base ortogonale — i polinomi di Legendre, oppure una costruita sui dati stessi — la matrice del problema diventa diagonale, o quasi, e meglio condizionata. Quanto si guadagna davvero, e in che senso «quasi»?
Seconda domanda. Alzando il grado il residuo scende sempre, quindi il residuo da solo non dice dove fermarsi. Si osserva però che dopo un certo grado la discesa si appiattisce: compare un plateau. Che cosa lo provoca, e si può trasformare l’osservazione in un criterio di arresto?
Terza domanda. Si può procedere in modo incrementale, cioè aggiungere un grado alla volta riusando tutto il lavoro già fatto, fino a riconoscere il plateau e fermarsi?
La risposta alle tre è affermativa, ma con precisazioni che vale la pena fare bene, perché su questo argomento circolano semplificazioni sbagliate. La più comune è che una base ortogonale «filtri il rumore»: non è così, e la Sezione 17.6 lo chiarisce. Prima però conviene costruire il problema da zero.
17.2 Impostazione del problema
Che cosa si vuole minimizzare
Un esperimento produce m coppie di numeri
(x_1,y_1),\ (x_2,y_2),\ \ldots,\ (x_m,y_m),
dove x_i è il valore impostato e y_i quello misurato, con il suo errore di misura. Si vuole riassumere i dati con un polinomio
p(x)=c_0\varphi_0(x)+c_1\varphi_1(x)+\cdots+c_n\varphi_n(x) \tag{17.1}
di grado n, scritto come combinazione di una base \varphi_0,\ldots,\varphi_n di \mathcal P_n che per ora lasciamo indeterminata.
Il caso interessante è m>n+1: i dati sono più numerosi delle incognite. Far passare il polinomio esattamente per tutti i punti in generale è impossibile, e sarebbe anche sbagliato, perché i y_i contengono rumore e non vogliamo riprodurlo. Si chiede allora che gli scarti
r_i=p(x_i)-y_i,\qquad i=1,\ldots,m,
siano complessivamente piccoli, e si misura il «complessivamente» con la somma dei loro quadrati:
\min_{c_0,\ldots,c_n}\ \sum_{i=1}^{m}\big[p(x_i)-y_i\big]^2 . \tag{17.2}
Questo è il problema dei minimi quadrati discreti. Si sceglie il quadrato — e non, per esempio, il valore assoluto — perché rende la funzione obiettivo derivabile e, come vedremo, riconduce tutto a un sistema lineare.
La scrittura matriciale
Valutiamo 17.1 in tutti i nodi e raccogliamo i risultati in un vettore. Posto
\bm{A}=\begin{pmatrix} \varphi_0(x_1) & \varphi_1(x_1) & \cdots & \varphi_n(x_1)\\ \varphi_0(x_2) & \varphi_1(x_2) & \cdots & \varphi_n(x_2)\\ \vdots & \vdots & & \vdots \\ \varphi_0(x_m) & \varphi_1(x_m) & \cdots & \varphi_n(x_m) \end{pmatrix}\in\Re^{m\times(n+1)}, \qquad \bm{c}=\begin{pmatrix}c_0\\ \vdots\\ c_n\end{pmatrix}, \qquad \bm{y}=\begin{pmatrix}y_1\\ \vdots\\ y_m\end{pmatrix},
la i-esima componente del vettore Ac è esattamente p(x_i), e quindi r=Ac-y è il vettore degli scarti. La 17.2 si riscrive
\min_{\bm{c}\in\Re^{n+1}}\ \|\bm{A}\bm{c}-\bm{y}\|_2^2 . \tag{17.3}
La matrice \bm{A}, alta e stretta, si chiama matrice di progetto. Si noti dove entra la base: una colonna di \bm{A} è una funzione della base valutata sui nodi. Con i monomi \varphi_j(x)=x^j si ottiene la matrice di Vandermonde1 A_{ij}=x_i^{\,j}; con una base ortogonale si ottiene A_{ij}=\varphi_j(x_i). Lo spazio \mathcal P_n è lo stesso, e quindi anche il polinomio ottimo p è lo stesso: cambiano solo i numeri c_j che lo descrivono e, come vedremo, la difficoltà di calcolarli.
Le equazioni normali
Per trovare il minimo sviluppiamo la funzione obiettivo. Scrivendo la norma come prodotto scalare,
\Psi(c)=\|\bm{A}\bm{c}-\bm{y}\|_2^2=(\bm{A}\bm{c}-\bm{y})^T(\bm{A}\bm{c}-\bm{y}) =\bm{c}^T\bm{A}^T\bm{A}\bm{c}-2\,\bm{c}^T\bm{A}^T\bm{y}+\bm{y}^T\bm{y}.
È un polinomio di secondo grado nelle n+1 variabili c_j, con termine quadratico \bm{c}^T(\bm{A}^T\bm{A})\bm{c}=\|\bm{A}\bm{c}\|_2^2\ge0: la funzione è una «parabola multidimensionale» rivolta verso l’alto, e il suo unico punto di minimo è il punto in cui tutte le derivate parziali si annullano. Imponendo \nabla\Psi(\bm{c})=0 si ottiene
\bm{A}^T\bm{A}\,\bm{c}=\bm{A}^T\bm{y}. \tag{17.4}
Sono le equazioni normali: un sistema lineare quadrato di ordine n+1, dunque piccolo anche se i dati sono tanti. La matrice \bm{A}^TA è invertibile non appena le colonne di \bm{A} sono linearmente indipendenti, cosa che accade sempre se i nodi x_i sono almeno n+1 e distinti.
Il nome «normali» viene dalla lettura geometrica. L’equazione 17.4 si può riscrivere come
\bm{A}^T(\bm{A}\bm{c}-\bm{y})=0,
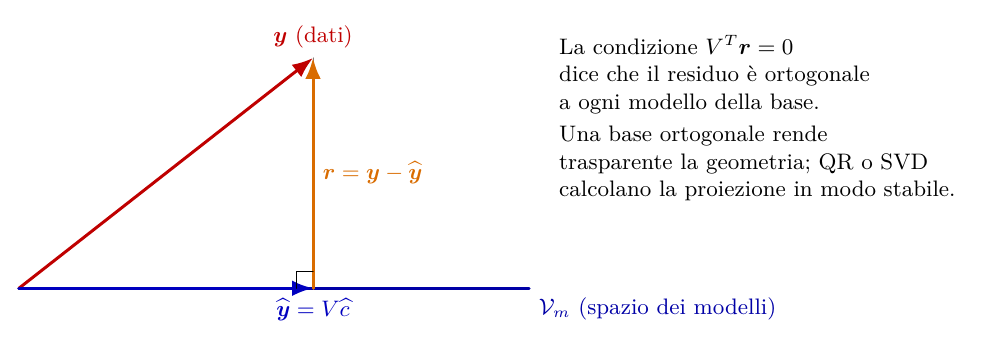
cioè: il vettore residuo \bm{r}=\bm{A}\bm{c}-\bm{y} è ortogonale a tutte le colonne di \bm{A}, quindi all’intero sottospazio generato da esse. Il punto \bm{A}\bm{c} è la proiezione ortogonale di \bm{y} su quel sottospazio — il punto del sottospazio più vicino a \bm{y} — ed è lo stesso quadro geometrico della Figura 17.9, qui in versione discreta.
Che cosa cambia cambiando base
Guardiamo da vicino l’elemento di posto (j,k) della matrice del sistema:
(\bm{A}^T\bm{A})_{jk}=\sum_{i=1}^{m}\varphi_j(x_i)\,\varphi_k(x_i) =\langle \varphi_j,\varphi_k\rangle_{\text{discreto}} . \tag{17.5}
È un prodotto scalare fra due funzioni della base, calcolato sui nodi anziché con un integrale. Da qui l’idea che regge tutta la sezione:
se la base è ortogonale rispetto a questo prodotto scalare discreto, allora \bm{A}^TA è diagonale e il sistema 17.4 si risolve con n+1 divisioni, senza eliminazione di Gauss.
L’esempio che segue mostra la cosa in concreto.
17.3 Un esempio svolto a mano: cinque punti, una parabola
Prendiamo cinque dati con ascisse intere, in modo che tutti i conti si possano fare a mente:
\begin{array}{c|ccccc} x_i & -2 & -1 & 0 & 1 & 2\\\hline y_i & 2 & 1 & 0 & 1 & 4 \end{array} \tag{17.6}
e cerchiamo la parabola (n=2, quindi tre incognite) che minimizza la somma dei quadrati degli scarti. I dati sono cinque, le incognite tre: siamo nel caso m>n+1.
Prima versione: la base monomiale
Con \varphi_0=1, \varphi_1=x, \varphi_2=x^2 la matrice di progetto e i dati sono
\bm{A}=\begin{pmatrix} 1 & -2 & 4\\ 1 & -1 & 1\\ 1 & 0 & 0\\ 1 & 1 & 1\\ 1 & 2 & 4 \end{pmatrix}, \qquad \bm{y}=\begin{pmatrix}2\\1\\0\\1\\4\end{pmatrix}.
Costruiamo \bm{A}^T\bm{A} usando 17.5. Servono solo cinque somme di potenze:
\textstyle\sum_i 1=5,\quad \sum_i x_i=0,\quad \sum_i x_i^2=10,\quad \sum_i x_i^3=0,\quad \sum_i x_i^4=34,
(le somme di potenze dispari sono nulle perché i nodi sono simmetrici rispetto all’origine), e analogamente \sum_iy_i=8, \sum_ix_iy_i=4, \sum_ix_i^2y_i=26. Le equazioni normali sono dunque
\begin{pmatrix} 5 & 0 & 10\\ 0 & 10 & 0\\ 10 & 0 & 34 \end{pmatrix} \begin{pmatrix}c_0\\ c_1\\ c_2\end{pmatrix} = \begin{pmatrix}8\\ 4\\ 26\end{pmatrix} . \tag{17.7}
La seconda equazione è isolata e dà subito c_1=2/5; la prima e la terza sono invece accoppiate, perché (\bm{A}^TA)_{02}=\sum x_i^2=10\ne0: le funzioni 1 e x^2 non sono ortogonali sui nodi. Bisogna risolvere il sistema 2\times2
\begin{cases} 5\,c_0+10\,c_2=8,\\ 10\,c_0+34\,c_2=26, \end{cases}
che per sostituzione dà 14\,c_2=10, cioè c_2=5/7, e quindi c_0=6/35. La parabola cercata è
p(x)=\frac{6}{35}+\frac{2}{5}\,x+\frac{5}{7}\,x^2 . \tag{17.8}
Seconda versione: una base ortogonale sui nodi
Cambiamo base, tenendo lo stesso spazio \mathcal P_2. Vogliamo tre polinomi q_0,q_1,q_2, di gradi 0,1,2, ortogonali rispetto al prodotto scalare discreto \langle u,v\rangle=\sum_{i=1}^5u(x_i)v(x_i). Li costruiamo con Gram–Schmidt, esattamente come nel Capitolo 14 ma con la somma al posto dell’integrale.
q_0(x)=1 .
q_1(x)=x-\frac{\langle x,q_0\rangle}{\langle q_0,q_0\rangle}\,q_0(x) =x-\frac{0}{5}=x ,
perché \sum_ix_i=0.
q_2(x)=x^2 -\frac{\langle x^2,q_0\rangle}{\langle q_0,q_0\rangle}\,q_0(x) -\frac{\langle x^2,q_1\rangle}{\langle q_1,q_1\rangle}\,q_1(x) =x^2-\frac{10}{5}\cdot1-\frac{0}{10}\cdot x =x^2-2 .
Si noti che q_2 dipende dai nodi: con cinque nodi diversi verrebbe un altro polinomio. Non è il polinomio di Legendre di grado 2, che è ortogonale rispetto a un integrale, non a questa somma.
Con la nuova base la matrice di progetto è
\bm{Q}=\begin{pmatrix} 1 & -2 & 2\\ 1 & -1 & -1\\ 1 & 0 & -2\\ 1 & 1 & -1\\ 1 & 2 & 2 \end{pmatrix},
e la matrice del sistema diventa diagonale:
\bm{Q}^T\bm{Q}=\begin{pmatrix}5&0&0\\ 0&10&0\\ 0&0&14\end{pmatrix}, \qquad \bm{Q}^T\bm{y}=\begin{pmatrix}8\\ 4\\ 10\end{pmatrix} .
Non c’è più nessun sistema da risolvere: ogni coefficiente è un rapporto fra due numeri,
d_k=\frac{\langle y,q_k\rangle}{\langle q_k,q_k\rangle} \qquad\Longrightarrow\qquad d_0=\frac{8}{5},\quad d_1=\frac{4}{10}=\frac{2}{5}, \quad d_2=\frac{10}{14}=\frac{5}{7} . \tag{17.9}
Il polinomio è
p(x)=\frac{8}{5}+\frac{2}{5}\,x+\frac{5}{7}\,(x^2-2),
e sviluppando il termine \frac57(x^2-2)=\frac57x^2-\frac{10}{7} con \frac85-\frac{10}{7}=\frac{56-50}{35}=\frac{6}{35} si ritrova esattamente la 17.8. Due strade, stesso polinomio: cambiare base non cambia il risultato, cambia solo la fatica.
Il residuo, uguale nelle due versioni, vale
\sum_{i=1}^5 r_i^2=\frac{16}{35}\simeq0{,}4571 .
NotaDue vantaggi, non uno
Oltre a eliminare il sistema lineare, 17.9 ha una proprietà che le equazioni normali piene non hanno: i coefficienti non si ricalcolano. Se dopo aver trovato d_0,d_1,d_2 si decide di aggiungere il termine di grado 3, basta calcolare d_3: i primi tre restano quelli. Con i monomi, invece, aggiungere una colonna cambia tutte le componenti della soluzione, perché il sistema è accoppiato.
Terza versione: costruire la base dai dati
Con cinque nodi e grado due Gram–Schmidt si fa a mano. Con m nodi qualunque e grado n qualunque serve un procedimento sistematico, e soprattutto serve capire che cosa si sta ortogonalizzando.
Il prodotto scalare discreto
Fissati i nodi x_1,\ldots,x_m e, se si vuole, dei pesi w_i>0 che dicono quanto ciascun dato è affidabile, poniamo
\langle u,v\rangle_{d}=\sum_{i=1}^{m}w_i\,u(x_i)\,v(x_i), \qquad \|u\|_{d}^2=\langle u,u\rangle_{d}=\sum_{i=1}^{m}w_i\,u(x_i)^2 . \tag{17.10}
Il pedice d sta per «discreto». Questa è, parola per parola, la costruzione dei capitoli precedenti con la somma al posto dell’integrale: tutto quello che è stato dimostrato lì continua a valere, purché \langle\cdot,\cdot\rangle_d sia davvero un prodotto scalare.
AvvisoL’unica differenza rispetto al caso continuo
Un prodotto scalare deve soddisfare \|u\|_d=0\Rightarrow u=0. Qui \|u\|_d=0 significa solo u(x_i)=0 per ogni i: il polinomio si annulla nei nodi, non ovunque. Un polinomio di grado m può annullarsi in tutti gli m nodi senza essere nullo — per esempio (x-x_1)\cdots(x-x_m).
Dunque 17.10 è un prodotto scalare solo su \mathcal P_{m-1}, e la costruzione che segue funziona finché
n\le m-1 ,
cioè finché i dati sono almeno quanti i coefficienti. È esattamente l’ipotesi del Passo 1, e non è una coincidenza.
Perché non Gram–Schmidt sui monomi
Si potrebbe ortogonalizzare la lista 1,x,x^2,\ldots,x^n con Gram–Schmidt, come abbiamo fatto a mano. Per n piccolo va bene, ma è la strada sbagliata per due motivi, entrambi già incontrati nel Capitolo 14: costa O(mn^2) operazioni, e parte da una base pessimamente condizionata, con tutti i problemi di cancellazione che ne derivano. Esiste un’alternativa che costa O(mn) e non nomina mai i monomi.
La ricorrenza a tre termini, versione discreta
I polinomi q_k che cerchiamo siano monici di grado k e ortogonali fra loro rispetto a 17.10. Ripetiamo il ragionamento del Capitolo 16.
Il polinomio x\,q_k è monico di grado k+1, quindi la differenza x\,q_k-q_{k+1} ha grado al più k e si scrive nella base q_0,\ldots,q_k:
x\,q_k=q_{k+1}+\sum_{j=0}^{k}\alpha_j\,q_j, \qquad \alpha_j=\frac{\langle x\,q_k,q_j\rangle_d}{\langle q_j,q_j\rangle_d}.
Come nel caso continuo, il fattore x si sposta da una parte all’altra del prodotto scalare, \langle x\,q_k,q_j\rangle_d=\langle q_k,x\,q_j\rangle_d, e se j\le k-2 il polinomio x\,q_j ha grado \le k-1: il prodotto scalare è nullo. Sopravvivono solo j=k e j=k-1. Isolando q_{k+1} si ottiene
q_{k+1}(x)=(x-\beta_k)\,q_k(x)-\gamma_k\,q_{k-1}(x), \qquad q_{-1}=0,\quad q_0=1, \tag{17.11}
con
\beta_k=\frac{\langle x\,q_k,\,q_k\rangle_d}{\langle q_k,q_k\rangle_d} =\frac{\sum_i w_i\,x_i\,q_k(x_i)^2}{\sum_i w_i\,q_k(x_i)^2}, \qquad \gamma_k=\frac{\langle q_k,q_k\rangle_d}{\langle q_{k-1},q_{k-1}\rangle_d} =\frac{\|q_k\|_d^2}{\|q_{k-1}\|_d^2} . \tag{17.12}
La formula di \gamma_k merita una riga: per definizione \gamma_k=\langle x\,q_k,q_{k-1}\rangle_d/\|q_{k-1}\|_d^2, e spostando il fattore x si ottiene \langle q_k,\,x\,q_{k-1}\rangle_d; ma x\,q_{k-1} è monico di grado k, dunque uguale a q_k più termini di grado inferiore, che sono ortogonali a q_k. Resta \langle x q_k,q_{k-1}\rangle_d=\|q_k\|_d^2.
Si noti che \beta_k e \gamma_k si calcolano dai dati: sono medie pesate di quantità note al passo k, non richiedono di conoscere i polinomi in forma monomiale.
L’algoritmo
Mettendo insieme 17.11 e la formula dei coefficienti 17.9 si ottiene un procedimento che in una sola passata costruisce la base e il fit, senza mai nominare i monomi e senza mai formare una matrice.
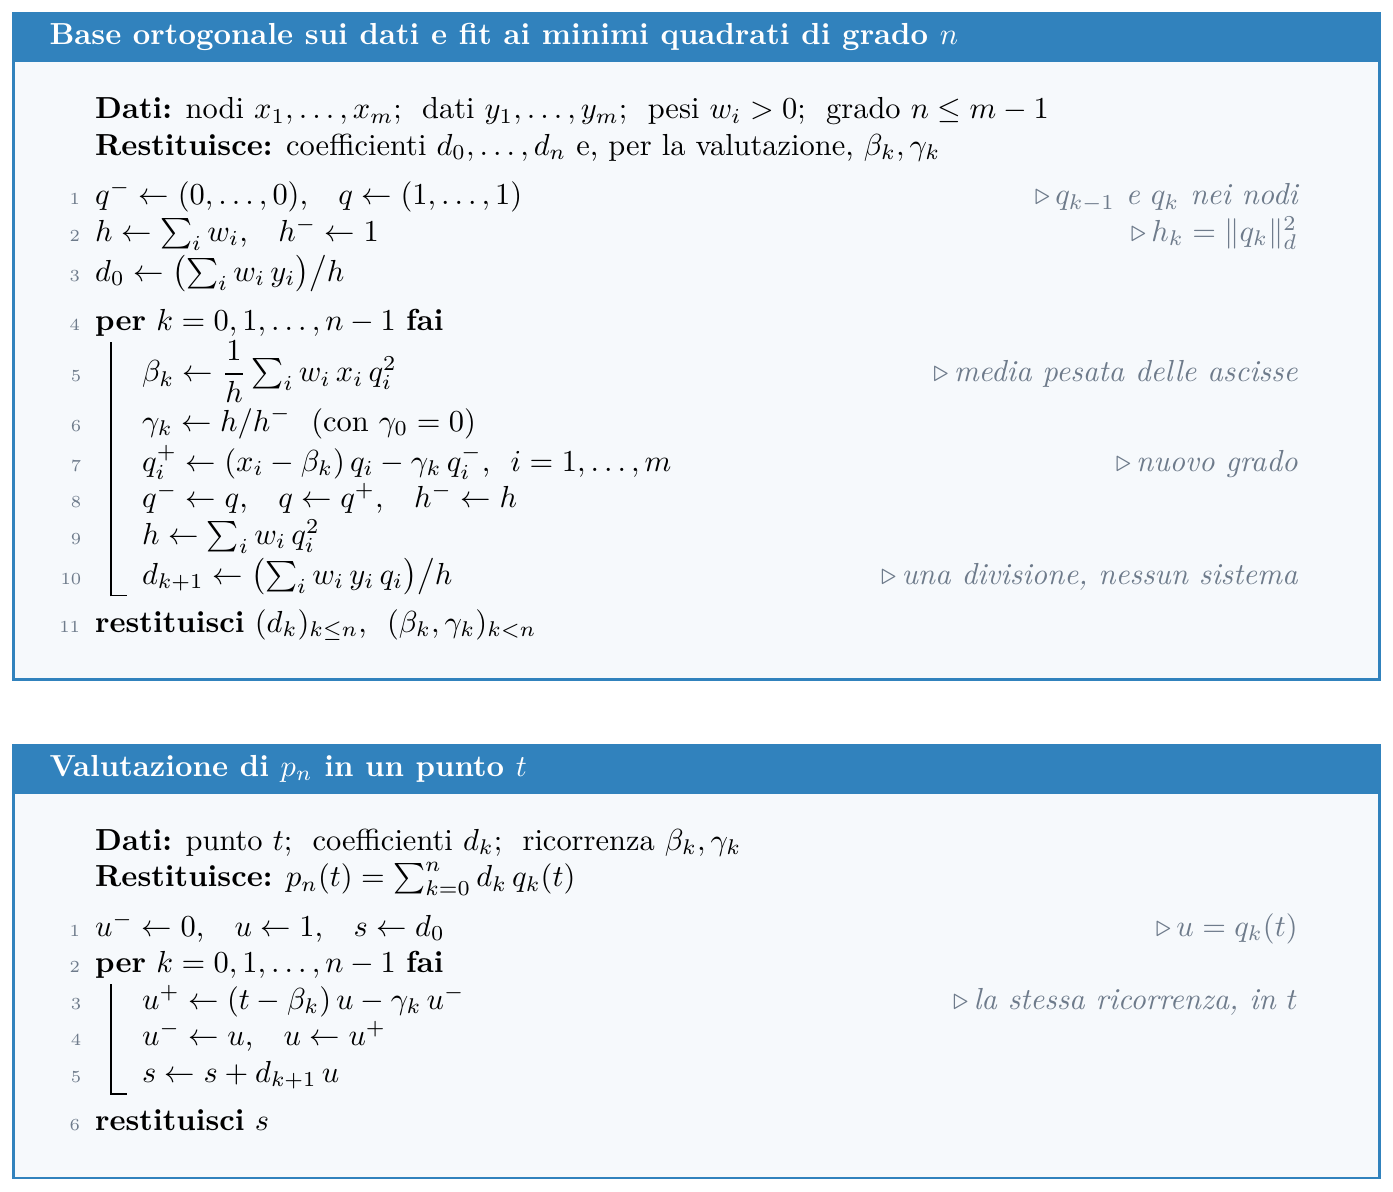
Tre osservazioni sul costo. Ogni grado richiede un numero fisso di passate sugli m dati, quindi il costo totale è O(mn) operazioni: niente matrici, niente sistemi lineari, nessuna \bm{A}^TA da formare. La memoria necessaria sono due soli vettori di lunghezza m — i valori q_{k-1} e q_k nei nodi — più una manciata di scalari. E per valutare p_n in un punto nuovo non serve convertire in forma monomiale: basta rieseguire 17.11 in quel punto, accumulando i contributi d_kq_k(t), come nel secondo riquadro della Figura 17.1.
L’algoritmo in R
Tre funzioni di poche righe, nessuna libreria di algebra lineare. Proviamole sui cinque dati dell’esempio fatto a mano.
x <- c(-2, -1, 0, 1, 2)
y <- c( 2,  1, 0, 1, 4)
f <- fit_ortogonale(x, y, 2)

knitr::kable(data.frame(
  k        = 0:2,
  beta_k   = f$beta[1:3],
  gamma_k  = f$gamma[1:3],
  h_k      = f$h,
  d_k      = f$d,
frazione = c("8/5", "2/5", "5/7")))| k | beta_k | gamma_k | h_k | d_k | frazione |
|---|---|---|---|---|---|
| 0 | 0 | 0 | 5 | 1.6000000 | 8/5 |
| 1 | 0 | 2 | 10 | 0.4000000 | 2/5 |
| 2 | 0 | 0 | 14 | 0.7142857 | 5/7 |
I valori coincidono con quelli trovati a mano: h=(5,10,14), \beta_k=\gamma_k nulli o pari a 2 per la simmetria dei nodi, e d=(8/5,\,2/5,\,5/7).
Le due basi a confronto, in R
x <- c(-2, -1, 0, 1, 2)
y <- c( 2,  1, 0, 1, 4)

A <- cbind(1, x, x^2)       # base monomiale
Q <- cbind(1, x, x^2 - 2)   # base ortogonale sui cinque nodi

cA <- solve(crossprod(A), crossprod(A, y))   # risolve un sistema 3x3
cQ <- crossprod(Q, y) / diag(crossprod(Q))   # tre sole divisioni

knitr::kable(data.frame(
  base        = c("monomi", "ortogonale"),
  residuo_RSS = c(sum((A %*% cA - y)^2), sum((Q %*% cQ - y)^2)),
  kappa2_A    = c(kappa(A, exact = TRUE), kappa(Q, exact = TRUE)),
  kappa2_AtA  = c(kappa(crossprod(A), exact = TRUE),
kappa(crossprod(Q), exact = TRUE))))| base | residuo_RSS | kappa2_A | kappa2_AtA |
|---|---|---|---|
| monomi | 0.4571429 | 4.435961 | 19.67775 |
| ortogonale | 0.4571429 | 1.673320 | 2.80000 |
xx <- seq(-2.3, 2.3, length.out = 400)
p  <- function(t) 6/35 + (2/5)*t + (5/7)*t^2
plot(x, y, pch = 19, cex = 1.3, xlab = "x", ylab = "y",
     xlim = c(-2.4, 2.4), ylim = c(-0.4, 4.4),
     main = "Minimi quadrati: cinque dati, una parabola")
segments(x, y, x, p(x), col = "grey45", lwd = 2, lty = 2)
lines(xx, p(xx), col = 4, lwd = 2)
points(x, p(x), pch = 1, cex = 1.3, col = 4)
legend("top", c("dati", "parabola ottima", "scarti"),
       pch = c(19, NA, NA), lty = c(NA, 1, 2), lwd = c(NA, 2, 2),
       col = c(1, 4, "grey45"), bty = "n", horiz = TRUE)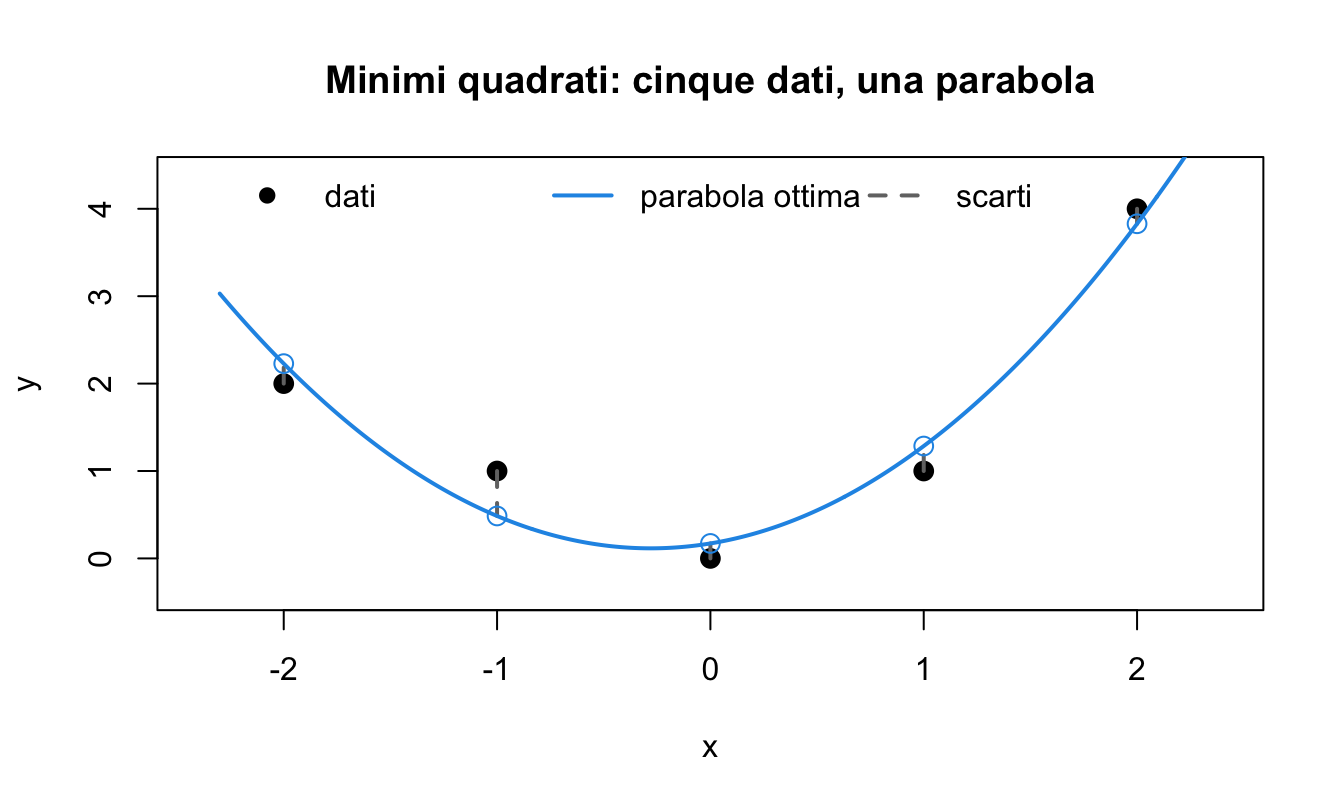
Le due basi danno lo stesso residuo a precisione macchina, come previsto. I due numeri di condizionamento, invece, differiscono già in questo esempio minuscolo: \kappa_2(\bm{A})\simeq4{,}44 con i monomi contro \kappa_2(\bm{Q})=\sqrt{14/5}\simeq1{,}67 con la base ortogonale. L’ultima colonna mostra il fenomeno che studiamo nel prossimo paragrafo: il condizionamento di \bm{A}^TA è il quadrato di quello di \bm{A}.
17.4 Tre esempi con l’algoritmo
I cinque dati di prima erano simmetrici rispetto all’origine, e questo faceva sparire quasi tutti i coefficienti della ricorrenza. Vediamo ora tre situazioni in cui non sparisce niente. Tutti e tre gli esempi usano gli stessi sei dati, che simulano una misura di laboratorio con ascisse non equispaziate — tipicamente perché i campionamenti iniziali sono fitti e quelli finali radi:
\begin{array}{c|cccccc} x_i & 0 & 1 & 2 & 5 & 10 & 20\\\hline y_i & 1{,}02 & 1{,}95 & 2{,}61 & 4{,}15 & 5{,}71 & 7{,}42 \end{array} \tag{17.13}
Esempio A: la base che i dati si costruiscono addosso
Applichiamo l’algoritmo con n=2 e pesi tutti uguali.
xs <- c(0, 1, 2, 5, 10, 20)
ys <- c(1.02, 1.95, 2.61, 4.15, 5.71, 7.42)
fA <- fit_ortogonale(xs, ys, 2)

knitr::kable(data.frame(k = 0:2, beta_k = fA$beta[1:3],
                        gamma_k = fA$gamma[1:3],
h_k = fA$h, d_k = fA$d), digits = 5)| k | beta_k | gamma_k | h_k | d_k |
|---|---|---|---|---|
| 0 | 6.33333 | 0.00000 | 6.0000 | 3.81000 |
| 1 | 13.63441 | 48.22222 | 289.3333 | 0.30636 |
| 2 | 0.00000 | 0.00000 | 8465.0323 | -0.01584 |
Leggiamo la tabella riga per riga, perché ogni numero ha un significato.
\beta_0=\sum_ix_i/6=6{,}333 è la media delle ascisse. Di conseguenza
q_1(x)=x-\beta_0=x-6{,}333
è la variabile centrata: il primo polinomio ortogonale non fa altro che spostare l’origine nel baricentro dei dati. Nell’esempio precedente i nodi erano già centrati e infatti era \beta_0=0.
h_0=6 è il numero dei dati, h_1=289{,}3 è la loro dispersione \sum_i(x_i-\bar x)^2.
\gamma_1=h_1/h_0=48{,}22 e \beta_1=13{,}63 producono
q_2(x)=(x-13{,}63)\,q_1(x)-48{,}22 ,
un polinomio di secondo grado costruito su misura per questi sei nodi: non è né x^2, né il polinomio di Legendre di grado due, né il x^2-2 dell’esempio precedente.
d_0=3{,}81 è la media delle ordinate: il fit di grado zero è, come deve essere, la media dei dati.
La verifica che la base sia davvero ortogonale è immediata: la matrice \bm{Q}^TQ deve risultare diagonale.
G <- round(crossprod(fA$Q), 10)
dimnames(G) <- list(c("q0", "q1", "q2"), c("q0", "q1", "q2"))
knitr::kable(G)| q0 | q1 | q2 | |
|---|---|---|---|
| q0 | 6 | 0.0000 | 0.000 |
| q1 | 0 | 289.3333 | 0.000 |
| q2 | 0 | 0.0000 | 8465.032 |
La Figura 17.3 mostra i tre polinomi della base — ciascuno riscalato per poterli disegnare insieme — e il fit risultante.
tt <- seq(-1, 21, length.out = 400)
B  <- base_ortogonale(tt, 2)$Q
op <- par(mfrow = c(1, 2), mar = c(4, 4, 2.5, 0.8))

Bs <- sweep(B, 2, apply(abs(B), 2, max), "/")   # riscalati per il disegno
matplot(tt, Bs, type = "l", lty = 1, lwd = 2, col = c(1, 4, 2),
        ylim = c(-1.15, 1.45),
        xlab = "x", ylab = "q_k (riscalato)", main = "La base ortogonale")
abline(h = 0, col = "grey70"); rug(xs, lwd = 2)
legend("top", c("q0", "q1", "q2"), col = c(1, 4, 2),
       lwd = 2, bty = "n", horiz = TRUE)

plot(xs, ys, pch = 19, cex = 1.2, xlab = "x", ylab = "y",
     main = "Fit di grado 2")
lines(tt, valuta(tt, fA), col = 4, lwd = 2)
segments(xs, ys, xs, fA$fitted, col = "grey45", lty = 2, lwd = 2)
par(op)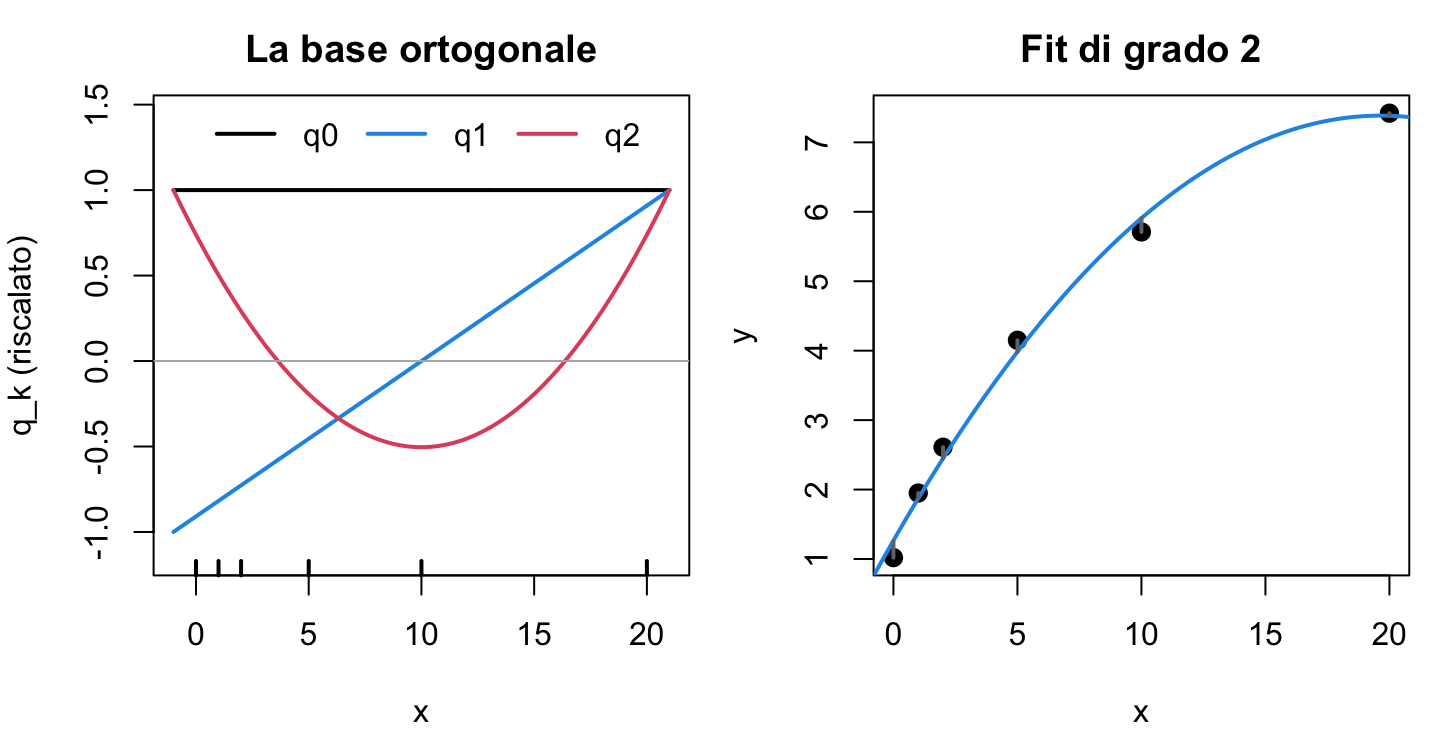
Si noti, nel pannello di sinistra, che q_1 si annulla nel baricentro 6{,}33 e che q_2 ha due zeri, entrambi interni all’intervallo dei dati: è il Teorema 16.2, valido anche nella versione discreta.
Infine il confronto con i monomi. Qui le ascisse arrivano a 20, dunque la colonna x^2 arriva a 400: le tre colonne della Vandermonde hanno ordini di grandezza molto diversi, e il condizionamento ne risente.
AA <- cbind(1, xs, xs^2)
cA2 <- solve(crossprod(AA), crossprod(AA, ys))
knitr::kable(data.frame(
  base        = c("monomi", "ortogonale"),
  residuo_RSS = c(sum((AA %*% cA2 - ys)^2), sum((fA$fitted - ys)^2)),
  kappa2_A    = c(kappa(AA, exact = TRUE), kappa(fA$Q, exact = TRUE)),
  kappa2_AtA  = c(kappa(crossprod(AA), exact = TRUE),
kappa(crossprod(fA$Q), exact = TRUE))), digits = 8)| base | residuo_RSS | kappa2_A | kappa2_AtA |
|---|---|---|---|
| monomi | 0.1613141 | 293.87043 | 86359.832 |
| ortogonale | 0.1613141 | 37.56113 | 1410.839 |
Il residuo è lo stesso fino all’ultima cifra, come deve essere. Il condizionamento della matrice di progetto passa invece da circa 294 a circa 38, e quello di \bm{A}^TA da 8{,}6\cdot10^{4} a 1{,}4\cdot10^3.
NotaOrtogonale non vuol dire ortonormale
Perché \kappa_2(\bm{Q})\simeq38 e non 1? Perché le colonne di \bm{Q} sono sì perpendicolari, ma hanno lunghezze molto diverse: h_0=6 contro h_2=8465. Il condizionamento di una matrice a colonne ortogonali è
\kappa_2(\bm{Q})=\sqrt{\frac{\max_k h_k}{\min_k h_k}} =\sqrt{\frac{8465}{6}}\simeq37{,}6 .
Dividendo ogni colonna per \sqrt{h_k} — cioè passando alla base ortonormale \phi_k=q_k/\|q_k\|_d — si ottiene \kappa_2=1, il minimo possibile. È una riga di codice in più e non cambia il polinomio: cambia solo la scala dei coefficienti.
Esempio B: alzare il grado non ricalcola nulla
Questa è la proprietà annunciata nel callout «Due vantaggi, non uno», ed è il motivo pratico per cui in laboratorio si usa questa base. Rifacciamo il fit degli stessi sei dati con n=1, n=2 e n=3, e confrontiamo i coefficienti nelle due basi.
righe <- lapply(1:3, function(n) {
  fo <- fit_ortogonale(xs, ys, n)
  Am <- outer(xs, 0:n, `^`)
  cm <- qr.solve(Am, ys)
  data.frame(grado = n, base = c("ortogonale", "monomi"),
             coef0 = c(fo$d[1], cm[1]), coef1 = c(fo$d[2], cm[2]),
             coef2 = c(if (n >= 2) fo$d[3] else NA, if (n >= 2) cm[3] else NA),
             coef3 = c(if (n >= 3) fo$d[4] else NA, if (n >= 3) cm[4] else NA))
})
knitr::kable(do.call(rbind, righe), digits = 5)| grado | base | coef0 | coef1 | coef2 | coef3 |
|---|---|---|---|---|---|
| 1 | ortogonale | 3.81000 | 0.30636 | NA | NA |
| 1 | monomi | 1.86972 | 0.30636 | NA | NA |
| 2 | ortogonale | 3.81000 | 0.30636 | -0.01584 | NA |
| 2 | monomi | 1.26569 | 0.62268 | -0.01584 | NA |
| 3 | ortogonale | 3.81000 | 0.30636 | -0.01584 | 0.00121 |
| 3 | monomi | 1.08011 | 0.84849 | -0.05086 | 0.00121 |
Si guardino le righe «ortogonale»: la colonna coef0 vale 3{,}81 per tutti e tre i gradi, coef1 vale 0{,}30636 per tutti e tre. Alzare il grado aggiunge un coefficiente e lascia stare gli altri, perché la nuova direzione q_{n+1} è perpendicolare a tutte le precedenti: la proiezione su quelle non cambia.
Nelle righe «monomi» invece c_0 passa da 1{,}87 a 1{,}27 a 1{,}08 e c_1 da 0{,}31 a 0{,}62 a 0{,}85: tutto si rimescola, perché le colonne 1,x,x^2,x^3 sono fra loro correlate.
Consiglio
Un’eccezione apparente: il coefficiente di grado massimo coincide sempre nelle due basi (-0{,}01584 per n=2, 0{,}00121 per n=3). Non è un caso: i q_k sono monici, quindi d_n e c_n sono entrambi il coefficiente di x^n del medesimo polinomio.
Questo rende naturale la scelta del grado: si costruisce la base una volta sola fino a un grado massimo, si guarda come decrescono i contributi d_k^2h_k — che sono esattamente le riduzioni del residuo apportate da ciascun grado — e ci si ferma quando smettono di decrescere in modo significativo.
fB <- fit_ortogonale(xs, ys, 4)
contrib <- fB$d^2 * fB$h
knitr::kable(data.frame(
  grado_k         = 0:4,
  contributo      = contrib,
residuo_dopo_k = sum(ys^2) - cumsum(contrib)), digits = 6)| grado_k | contributo | residuo_dopo_k |
|---|---|---|
| 0 | 87.096600 | 29.441400 |
| 1 | 27.155701 | 2.285699 |
| 2 | 2.124384 | 0.161314 |
| 3 | 0.148873 | 0.012441 |
| 4 | 0.010254 | 0.002187 |
La tabella è la traduzione numerica dell’identità di Pitagora: poiché i q_k sono ortogonali,
\sum_{i=1}^{m}y_i^2 =\sum_{k=0}^{n}d_k^2\,h_k+\text{residuo} , \tag{17.14}
cioè l’energia dei dati si ripartisce fra i gradi, e ogni grado aggiunto ne sottrae una quota d_k^2h_k\ge0 al residuo. Con i monomi una decomposizione del genere non esiste.
Esempio C: dati di qualità diversa
Supponiamo ora che i primi tre dati provengano da uno strumento accurato, con incertezza \sigma=0{,}05, e gli ultimi tre da uno strumento grossolano, con \sigma=0{,}4. Trattarli alla pari sarebbe sbagliato: il criterio standard è pesare ciascun dato con l’inverso della varianza,
w_i=\frac{1}{\sigma_i^2},
cosicché il problema diventa \min\sum_i w_i\,[p(x_i)-y_i]^2. L’algoritmo non cambia di una riga: i pesi entrano in 17.10 e si propagano in \beta_k,\gamma_k,h_k,d_k.
sigma <- c(0.05, 0.05, 0.05, 0.4, 0.4, 0.4)
tt <- seq(-1, 21, length.out = 400)
fU <- fit_ortogonale(xs, ys, 2)                      # pesi uguali
fW <- fit_ortogonale(xs, ys, 2, w = 1/sigma^2)       # pesi 1/sigma^2

plot(xs, ys, pch = 19, cex = 1.2, ylim = c(0.5, 8), xlab = "x", ylab = "y",
     main = "Minimi quadrati pesati")
arrows(xs, ys - sigma, xs, ys + sigma, angle = 90, code = 3,
       length = 0.05, lwd = 2, col = "grey40")
lines(tt, valuta(tt, fU), col = 2, lwd = 2, lty = 2)
lines(tt, valuta(tt, fW), col = 4, lwd = 2)
legend("bottomright", c("pesi uguali", "pesi 1/sigma^2", "barre d'errore"),
       col = c(2, 4, "grey40"), lty = c(2, 1, 1), lwd = 2, bty = "n")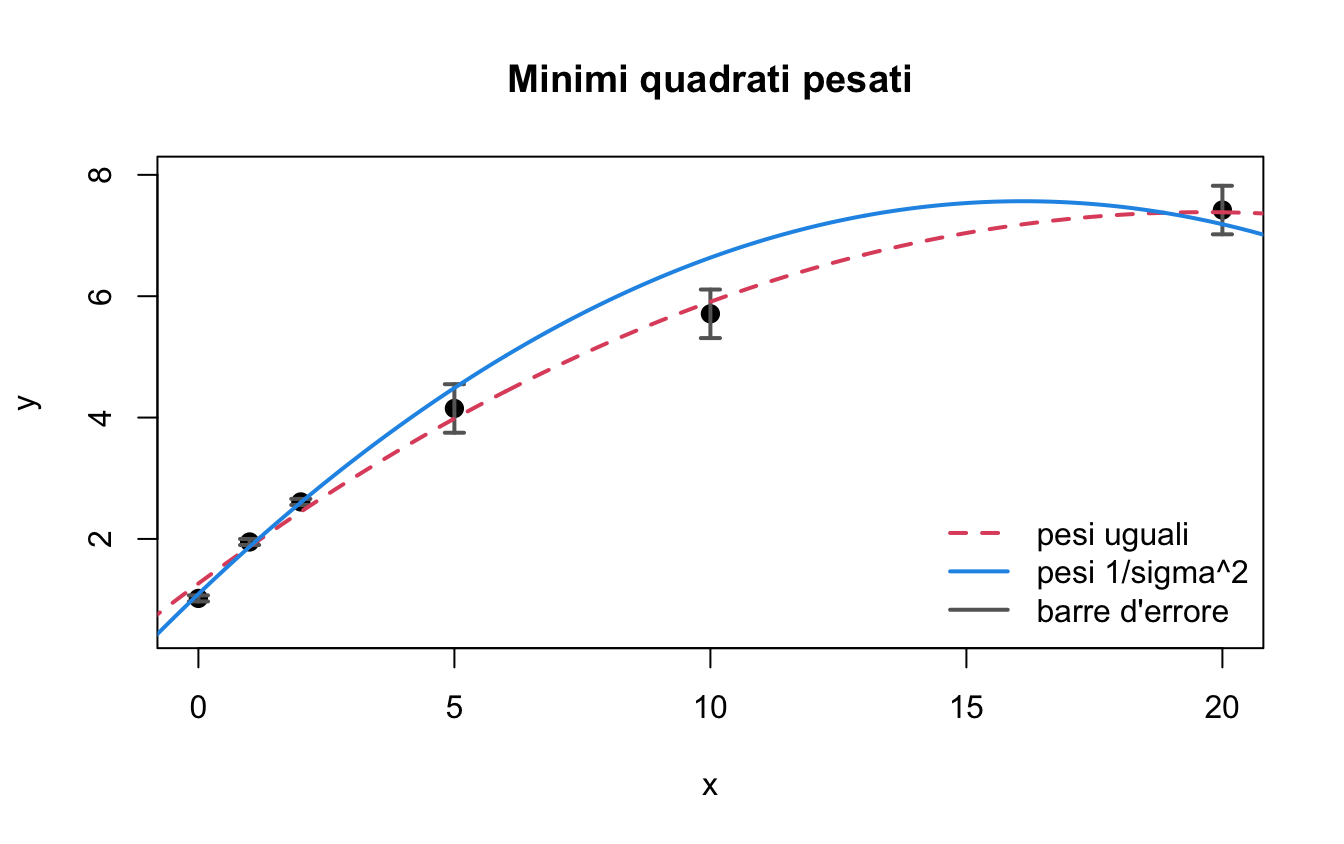
knitr::kable(data.frame(
  x               = xs,
  sigma           = sigma,
  scarto_uniforme = fU$fitted - ys,
  scarto_pesato   = fW$fitted - ys,
scarto_su_sigma = (fW$fitted - ys)/sigma), digits = 4)| x | sigma | scarto_uniforme | scarto_pesato | scarto_su_sigma |
|---|---|---|---|---|
| 0 | 0.05 | 0.2457 | 0.0723 | 1.4452 |
| 1 | 0.05 | -0.0775 | -0.0787 | -1.5744 |
| 2 | 0.05 | -0.1623 | -0.0096 | -0.1927 |
| 5 | 0.40 | -0.1669 | 0.3381 | 0.8452 |
| 10 | 0.40 | 0.1984 | 0.9257 | 2.3141 |
| 20 | 0.40 | -0.0373 | -0.2338 | -0.5845 |
Nei primi tre punti lo scarto del fit pesato è molto più piccolo di quello uniforme; negli ultimi tre è più grande. È il comportamento voluto: un errore di 0{,}3 su un dato con \sigma=0{,}4 è irrilevante, uno di 0{,}25 su un dato con \sigma=0{,}05 vale cinque deviazioni standard. L’ultima colonna, che riporta gli scarti in unità di \sigma, è la quantità che il metodo pesato rende uniformemente piccola, e quella da guardare per giudicare se il modello è adeguato.
17.5 Come si risolve davvero: la fattorizzazione QR
Perché le equazioni normali sono una cattiva idea
Le equazioni normali sono il modo più rapido per capire il problema, ma non il modo giusto per risolverlo in aritmetica finita. Il motivo sta in un’identità: se \bm{A} ha colonne indipendenti,
\kappa_2(\bm{A}^T\bm{A})=\kappa_2(\bm{A})^2 . \tag{17.15}
Infatti i valori singolari di \bm{A}^T\bm{A} sono i quadrati di quelli di \bm{A}, e \kappa_2 è il rapporto fra il più grande e il più piccolo. Formare \bm{A}^T\bm{A} raddoppia le cifre perse: se \kappa_2(\bm{A})=10^{6}, già accettabile, allora \kappa_2(\bm{A}^T\bm{A})=10^{12} e in doppia precisione (circa 16 cifre) ne restano quattro. Nell’esempio precedente si passa da 4{,}44 a 19{,}7\simeq4{,}44^2: innocuo lì, rovinoso al crescere del grado, come mostra la Figura 17.5.
C’è di più: il prodotto \bm{A}^T\bm{A} va calcolato, e sommare numeri di ordini di grandezza molto diversi distrugge informazione. Può accadere che \bm{A} abbia colonne indipendenti ma che \bm{A}^T\bm{A}, una volta calcolata in virgola mobile, risulti numericamente singolare.
La conclusione è che le equazioni normali servono per ragionare, non per calcolare. Il metodo di riferimento è un altro.
Che cosa sono \bm{Q} e \bm{R}
Ogni matrice \bm{A}\in\Re^{m\times(n+1)} con m\ge n+1 e colonne indipendenti si fattorizza come
\bm{A}=\bm{Q}\bm{R}, \tag{17.16}
dove \bm{Q}\in\Re^{m\times(n+1)} ha colonne ortonormali (\bm{Q}^T\bm{Q}=\bm{I}) e \bm{R}\in\Re^{(n+1)\times(n+1)} è triangolare superiore con elementi diagonali positivi. La costruzione è quella del Capitolo 4; concettualmente \bm{Q} contiene la base ortonormale ottenuta ortogonalizzando le colonne di \bm{A}, e \bm{R} registra i coefficienti usati per ottenerla.
Perché la QR risolve il problema
La proprietà che rende utile \bm{Q} è che moltiplicare per una matrice ortogonale non cambia le lunghezze: se \bm{U} è ortogonale (\bm{U}^T\bm{U}=\bm{U}\bm{U}^T=\bm{I}) allora \|\bm{U}\bm{v}\|_2=\|\bm{v}\|_2, perché \|\bm{U}\bm{v}\|_2^2=\bm{v}^T\bm{U}^T\bm{U}\bm{v}=\bm{v}^T\bm{v}. Una rotazione o una riflessione non allungano né accorciano i vettori.
Completiamo le colonne di \bm{Q} con altre m-(n+1) colonne ortonormali, ottenendo una matrice quadrata ortogonale \bm{U}=\begin{pmatrix}\bm{Q} & \widetilde{\bm{Q}}\end{pmatrix}. Allora, per ogni c,
\|\bm{A}\bm{c}-\bm{y}\|_2=\|\bm{U}^T(\bm{A}\bm{c}-\bm{y})\|_2 =\left\|\begin{pmatrix}\bm{Q}^T\\ \widetilde{\bm{Q}}^{\,T}\end{pmatrix}(\bm{Q}\bm{R}\bm{c}-\bm{y})\right\|_2 =\left\|\begin{pmatrix}\bm{R}\bm{c}-\bm{Q}^T\bm{y}\\[2pt] -\widetilde{\bm{Q}}^{\,T}\bm{y}\end{pmatrix}\right\|_2 ,
dove si è usato \bm{Q}^T\bm{Q}=\bm{I} e \widetilde{\bm{Q}}^{\,T}\bm{Q}=\bm{0}. Elevando al quadrato, le due parti si sommano:
\|\bm{A}\bm{c}-\bm{y}\|_2^2=\underbrace{\|\bm{R}\bm{c}-\bm{Q}^T\bm{y}\|_2^2}_{\text{dipende da }c} +\underbrace{\|\widetilde{\bm{Q}}^{\,T}\bm{y}\|_2^2}_{\text{non dipende da }\bm{c}} . \tag{17.17}
Il secondo addendo non si può toccare: è il residuo minimo, quello che resta anche nella migliore delle ipotesi. Il primo si può invece azzerare, scegliendo \bm{c} che risolve
\bm{R}\,\bm{c}=\bm{Q}^T\bm{y}. \tag{17.18}
Il sistema triangolare e il suo costo
Il sistema 17.18 è triangolare superiore, e si risolve dall’ultima equazione verso la prima (sostituzione all’indietro): l’ultima contiene una sola incognita, la penultima due di cui una già nota, e così via. Costa \mathcal{O}(n^2) operazioni, contro le \mathcal{O}(n^3) di un sistema pieno, e soprattutto non si è mai formata la matrice \bm{A}^T\bm{A}: si lavora con \kappa_2(\bm{A}), non con il suo quadrato.
In R tutto questo è qr.solve(A, y), che esegue la fattorizzazione, calcola \bm{Q}^T\bm{y} e risolve il sistema triangolare, segnalando se il rango numerico è insufficiente.
La QR sull’esempio dei cinque punti
Riprendiamo i dati 17.6. Con la base monomiale la fattorizzazione dà
\bm{R}=\begin{pmatrix} \sqrt5 & 0 & 2\sqrt5\\ 0 & \sqrt{10}& 0\\ 0 & 0 & \sqrt{14} \end{pmatrix},
a meno dei segni, che dipendono dalla convenzione. L’elemento R_{02}=2\sqrt5\ne0 è la traccia dell’accoppiamento fra le colonne 1 e x^2: è il motivo per cui prima abbiamo dovuto risolvere un sistema 2\times2.
Con la base ortogonale, invece, le colonne di \bm{Q} sono già fra loro perpendicolari e la fattorizzazione non ha nulla da ortogonalizzare: \bm{R} risulta diagonale,
\bm{R}=\begin{pmatrix} \sqrt5 & 0 & 0\\ 0 & \sqrt{10} & 0\\ 0 & 0 & \sqrt{14} \end{pmatrix},
con sulla diagonale proprio le norme \|q_k\|=\sqrt{\langle q_k,q_k\rangle} delle colonne. Il sistema triangolare 17.18 degenera in tre divisioni, e si ritrovano i coefficienti 17.9.
| riga | monomi_col1 | monomi_col2 | monomi_col3 | ortog_col1 | ortog_col2 | ortog_col3 |
|---|---|---|---|---|---|---|
| 1 | 2.2361 | 0.0000 | 4.4721 | 2.2361 | 0.0000 | 0.0000 |
| 2 | 0.0000 | 3.1623 | 0.0000 | 0.0000 | 3.1623 | 0.0000 |
| 3 | 0.0000 | 0.0000 | 3.7417 | 0.0000 | 0.0000 | 3.7417 |
ImportanteIl punto della sezione
Usare una base ortogonale non sostituisce la fattorizzazione QR: ne anticipa il lavoro. La QR ortogonalizza le colonne di \bm{A} numericamente, al momento del calcolo; una base ortogonale le consegna già ortogonali, perché l’ortogonalizzazione è stata fatta una volta per tutte in forma analitica (o con la ricorrenza 17.11). Nei due casi il risultato è lo stesso, ma nel secondo il fattore \bm{R} è diagonale, il condizionamento di \bm{A} è minimo e gli errori di arrotondamento hanno molto meno spazio per accumularsi.
17.6 Prima domanda: quanto si guadagna cambiando base
Le tre basi a confronto
Abbiamo ora tre candidate per le colonne della matrice di progetto.
| Base | Ortogonale rispetto a | \bm{A}^TA sui nodi |
|---|---|---|
| monomi 1,x,x^2,\ldots | niente | piena |
| Legendre P_0,P_1,\ldots | l’integrale su [-1,1] | quasi diagonale |
| q_0,q_1,\ldots dai dati | la somma sui nodi | esattamente diagonale |
La riga centrale è quella che merita attenzione, perché è la più usata e la più fraintesa. I polinomi di Legendre soddisfano
\int_{-1}^{1}P_j(x)P_k(x)\,\mathrm dx=0,\qquad j\ne k,
mentre il problema dei minimi quadrati discreti coinvolge
(\bm{A}^TA)_{jk}=\sum_{i=1}^{m}P_j(x_i)\,P_k(x_i).
La somma è una quadratura dell’integrale: se i nodi sono numerosi e ragionevolmente distribuiti, la somma vale circa l’integrale (a meno del fattore m/2) e quindi gli elementi fuori diagonale sono piccoli ma non nulli. Di qui il «quasi». E il «quasi» peggiora al crescere del grado, perché il prodotto P_jP_k ha grado j+k e una quadratura fissata integra bene solo fino a un certo grado.
L’esperimento seguente misura le due cose insieme: quanto \bm{A}^TA si discosta dalla diagonale e quanto vale \kappa_2(\bm{A}), su m=120 nodi equispaziati in [-1,1] e gradi crescenti.
xg <- seq(-1, 1, length.out = 120)

fuori_diag <- function(A) {                  # 0 = colonne ortogonali
  G <- crossprod(A); G <- G / sqrt(outer(diag(G), diag(G)))
  max(abs(G - diag(ncol(A))))
}

riga <- function(n) {
  M <- outer(xg, 0:n, `^`)                        # monomi
  L <- sapply(0:n, legendre, x = xg)              # Legendre
  B <- base_ortogonale(xg, n)
  D <- sweep(B$Q, 2, sqrt(B$h), "/")              # dai dati, ortonormale
  data.frame(grado = n,
             kappa_monomi   = kappa(M, exact = TRUE),
             kappa_legendre = kappa(L, exact = TRUE),
             kappa_dati     = kappa(D, exact = TRUE),
             fuoridiag_monomi   = fuori_diag(M),
             fuoridiag_legendre = fuori_diag(L),
             fuoridiag_dati     = fuori_diag(D))
}
knitr::kable(do.call(rbind, lapply(c(3, 6, 10, 15, 20), riga)), digits = 4)il massimo elemento extradiagonale della matrice di correlazione delle colonne: 0 significa ortogonalita esatta.
| grado | kappa_monomi | kappa_legendre | kappa_dati | fuoridiag_monomi | fuoridiag_legendre | fuoridiag_dati |
|---|---|---|---|---|---|---|
| 3 | 8.076500e+00 | 2.5830 | 1 | 0.9166 | 0.0376 | 0 |
| 6 | 9.818410e+01 | 3.4735 | 1 | 0.9834 | 0.0897 | 0 |
| 10 | 2.945329e+03 | 4.4337 | 1 | 0.9945 | 0.1655 | 0 |
| 15 | 2.193304e+05 | 5.4536 | 1 | 0.9977 | 0.2727 | 0 |
| 20 | 1.716883e+07 | 6.3600 | 1 | 0.9987 | 0.3722 | 0 |
I numeri dicono tre cose.
- I monomi collassano. Il condizionamento passa da 8 a 1{,}7\cdot10^{7} fra grado 3 e grado 20, e le colonne diventano quasi parallele (correlazione fuori diagonale vicinissima a 1). È la disuguaglianza di Beckermann 14.5 in azione.
- Legendre regge benissimo. Il condizionamento resta sotto 7 anche a grado 20: un guadagno di sei ordini di grandezza. Gli elementi fuori diagonale crescono da 0{,}04 a 0{,}37: la matrice è davvero quasi diagonale a gradi bassi, un po’ meno a gradi alti, ma il condizionamento non ne risente quasi.
- La base costruita sui dati è perfetta, con \kappa_2=1 e fuori diagonale nullo a tutti i gradi — purché sia normalizzata.
AvvisoOrtogonale non basta: serve ortonormale
I polinomi q_k prodotti dalla ricorrenza 17.11 sono monici, e le loro norme h_k=\|q_k\|_d^2 cambiano di ordini di grandezza. Le colonne sono perpendicolari, ma lunghissime alcune e cortissime altre, e il condizionamento di una matrice a colonne ortogonali vale
\kappa_2(\bm{Q})=\sqrt{\frac{\max_k h_k}{\min_k h_k}} ,
che in questo esperimento arriva a 8\cdot10^{5} a grado 20: peggio di Legendre. Il rimedio è una riga di codice — dividere ogni colonna per \sqrt{h_k}, cioè usare
\phi_k=\frac{q_k}{\|q_k\|_d} \tag{17.19}
— dopo la quale \kappa_2=1 esattamente. Da qui in avanti useremo sempre i \phi_k.
ImportanteChe cosa la base non fa
Girano affermazioni del tipo «i polinomi ortogonali filtrano il rumore» o «sono meno soggetti a sovradattamento». Sono false, e conviene dire perché.
Fissati i nodi e fissato il grado n, il polinomio dei minimi quadrati è uno solo: è il punto di \mathcal P_n più vicino ai dati, e questo non dipende da come si scrive \mathcal P_n. Monomi, Legendre e base dai dati producono lo stesso identico polinomio e lo stesso identico residuo — l’abbiamo verificato numericamente più volte in questo capitolo.
Quello che cambia è con quanta precisione quel polinomio viene calcolato in aritmetica finita. Con i monomi a grado 20 si perdono sette cifre prima ancora di cominciare; con una base ortogonale non se ne perde nessuna. Il confronto che a volte si trova — «fit ortogonale di grado 3 contro fit monomiale di grado 12» — non confronta due basi, confronta due gradi: il sovradattamento che si vede è colpa del grado 12, e si vedrebbe identico con una base ortogonale.
A filtrare il rumore è la scelta del grado, ed è l’argomento della Sezione 17.7.
Riscalare l’intervallo
Resta un’avvertenza pratica. I polinomi di Legendre vivono su [-1,1]: usarli su dati con ascisse in [0,20] senza riscalare non solo non aiuta, peggiora le cose. Con la trasformazione affine
t=\frac{2x-(x_{\min}+x_{\max})}{x_{\max}-x_{\min}}\in[-1,1] \tag{17.20}
si recupera tutto il guadagno; senza, \kappa_2 con Legendre su [0,20] a grado 5 vale 5\cdot10^{7} contro 6\cdot10^{6} dei monomi — peggio del punto di partenza. La base costruita sui dati non ha questo problema, perché il riscalamento lo fa da sé: \beta_0 è il baricentro dei nodi e le h_k aggiustano la scala.
gradi <- 1:20
kM <- kL <- kD <- numeric(length(gradi))
for (j in seq_along(gradi)) {
  n <- gradi[j]
  kM[j] <- kappa(outer(xg, 0:n, `^`), exact = TRUE)
  kL[j] <- kappa(sapply(0:n, legendre, x = xg), exact = TRUE)
  B <- base_ortogonale(xg, n)
  kD[j] <- kappa(sweep(B$Q, 2, sqrt(B$h), "/"), exact = TRUE)
}
plot(gradi, kM, type = "b", pch = 1, log = "y", lwd = 2, col = 2,
     ylim = range(c(kM, kL, kD)), xlab = "grado n",
     ylab = expression(kappa[2](A)),
     main = "Condizionamento della matrice di progetto")
lines(gradi, kL, type = "b", pch = 16, lwd = 2, col = 4)
lines(gradi, kD, type = "b", pch = 17, lwd = 2, col = 3)
abline(h = 1/.Machine$double.eps, lty = 3, col = "grey40")
legend("topleft", c("monomi", "Legendre", "ortonormale dai dati",
                    "soglia 1/eps"),
       col = c(2, 4, 3, "grey40"), lty = c(1, 1, 1, 3),
       pch = c(1, 16, 17, NA), lwd = 2, bty = "n")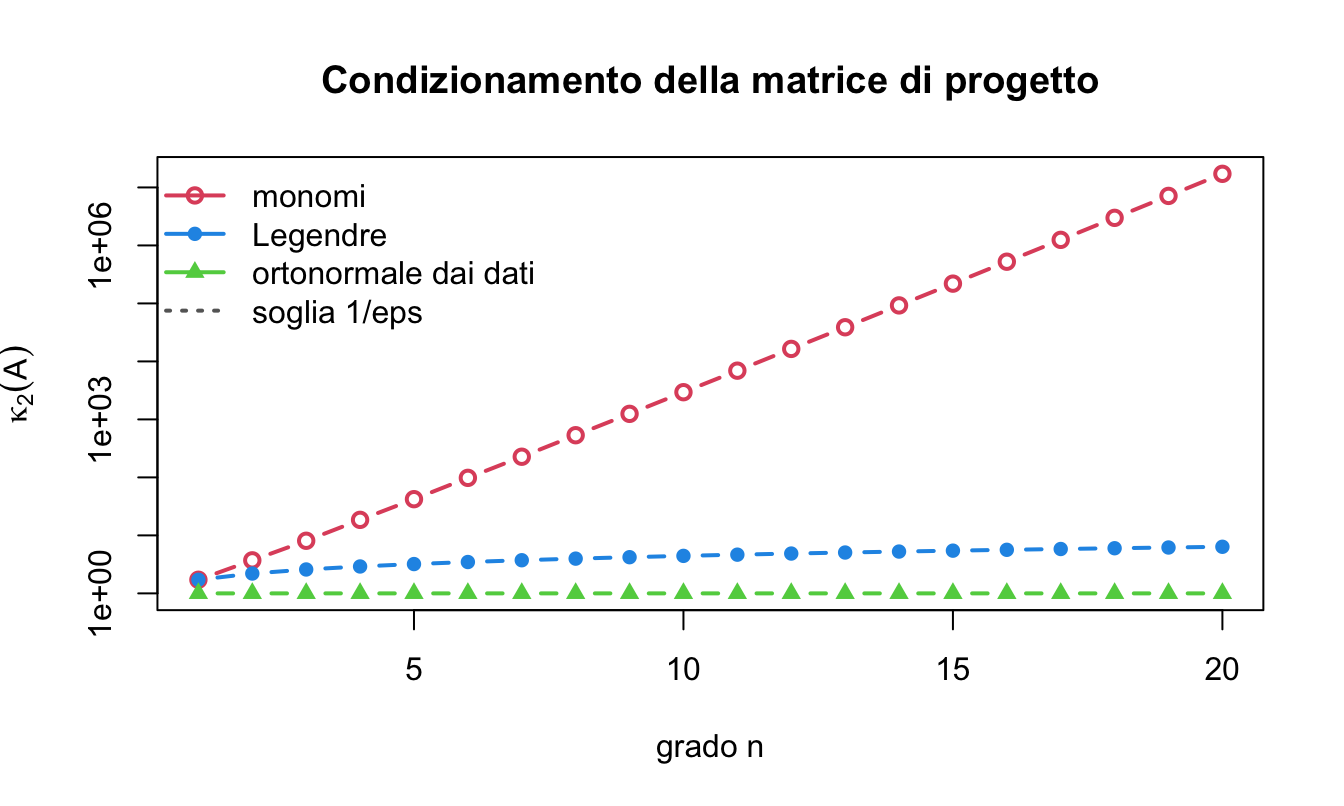
La linea tratteggiata è 1/\varepsilon_{\text{macchina}}\simeq4{,}5\cdot10^{15}: quando \kappa_2(\bm{A}) la raggiunge, la soluzione calcolata non ha più nessuna cifra significativa. Con i monomi accade attorno al grado 30; con le altre due basi non accade mai.
Risposta alla prima domanda. Sì, conviene, e il guadagno è nel condizionamento, non nell’approssimazione. Se i nodi sono ragionevoli e l’intervallo è riscalato, Legendre basta e ha il vantaggio di essere una base fissa, tabulata, indipendente dai dati. Se si vuole l’ortogonalità esatta — e i due regali che ne derivano, i coefficienti annidati e il criterio di arresto della prossima sezione — serve la base costruita sui dati.
17.7 Seconda domanda: lo spettro dei coefficienti e il plateau
Alzando il grado il residuo non può che diminuire: lo spazio \mathcal P_n contiene \mathcal P_{n-1}, quindi il nuovo ottimo è almeno buono quanto il vecchio. Guardare il residuo per scegliere il grado è dunque inutile — porterebbe sempre a n=m-1, cioè all’interpolazione di tutti i punti, rumore compreso.
La base ortonormale \phi_k di 17.19 rende visibile l’informazione che serve.
I coefficienti come spettro
Con base ortonormale i coefficienti sono semplici prodotti scalari,
\widehat c_k=\langle y,\phi_k\rangle_d=\sum_{i=1}^{m}\phi_k(x_i)\,y_i , \tag{17.21}
e il polinomio di grado n è p_n=\widehat c_0\phi_0+\cdots+\widehat c_n\phi_n. Per l’identità di Pitagora 17.14 il residuo vale
\mathrm{RSS}(n)=\sum_{i=1}^m y_i^2-\sum_{k=0}^{n}\widehat c_k^{\,2}, \qquad\text{dunque}\qquad \mathrm{RSS}(n-1)-\mathrm{RSS}(n)=\widehat c_n^{\,2} . \tag{17.22}
Ogni grado aggiunto riduce il residuo esattamente del quadrato del suo coefficiente. La successione |\widehat c_0|,|\widehat c_1|,\ldots si chiama spettro dei dati: dice quanta parte dei dati vive su ciascun grado. Si noti che \widehat c_k^{\,2}, essendo una differenza di residui, non dipende dalla base: è una quantità intrinseca dei dati e dei nodi. La base ortonormale non la crea, la rende calcolabile gratis.
Perché compare un plateau
Supponiamo ora che i dati siano
y_i=f(x_i)+\varepsilon_i ,
con f il trend vero e \varepsilon_i errori di misura indipendenti, di media nulla e deviazione standard \sigma. Sostituendo in 17.21 e usando la linearità,
\widehat c_k=\underbrace{\langle f,\phi_k\rangle_d}_{=\,c_k,\ \text{segnale}} +\underbrace{\sum_{i=1}^m\phi_k(x_i)\,\varepsilon_i}_{\text{rumore}} .
Il termine di rumore ha media nulla, e la sua varianza si calcola in una riga, perché gli errori sono indipendenti:
\operatorname{Var}\Big(\sum_i\phi_k(x_i)\varepsilon_i\Big) =\sigma^2\sum_{i=1}^m\phi_k(x_i)^2=\sigma^2 , \tag{17.23}
dove l’ultimo passaggio è esattamente la normalizzazione \|\phi_k\|_d=1. Lo stesso conto con due indici diversi dà covarianza nulla, per l’ortogonalità. Ne segue il fatto centrale:
ogni coefficiente stimato è il coefficiente vero più un errore di deviazione standard \sigma, la stessa per tutti i gradi, e gli errori sui diversi coefficienti sono scorrelati.
Il rumore si spalma dunque in modo uniforme su tutto lo spettro, con ampiezza \sigma, mentre il segnale si concentra sui primi gradi: se f è liscia, i suoi coefficienti c_k decadono rapidamente. Il risultato è lo scenario tipico:
- per k piccolo, |c_k|\gg\sigma e |\widehat c_k| misura il segnale;
- da un certo k^\star in poi |c_k|\ll\sigma e |\widehat c_k| oscilla attorno a \sigma, senza più decrescere.
È il plateau: lo spettro smette di scendere e si appiattisce sul livello del rumore. Per 17.22 il residuo, da lì in poi, scende di circa \sigma^2 per ogni grado aggiunto, cioè linearmente:
\mathbb E\big[\mathrm{RSS}(n)\big]\simeq \underbrace{\sum_i\big[f(x_i)-p_n(x_i)\big]^2}_{\simeq\,0\ \text{dopo }k^\star} +\,(m-n-1)\,\sigma^2 . \tag{17.24}
Continuare oltre k^\star significa spendere un grado di libertà per spiegare rumore: il residuo sui dati scende, ma la distanza dal trend vero aumenta. È il sovradattamento, lo stesso meccanismo del fenomeno di Runge di Capitolo 9 con il rumore al posto della derivata alta.
Il criterio di arresto
17.24 suggerisce anche come stimare \sigma senza conoscerlo:
\widehat\sigma^2=\frac{\mathrm{RSS}(n)}{m-n-1} \qquad\text{per un } n \text{ nel plateau}, \tag{17.25}
oppure, equivalentemente, come radice della media dei \widehat c_k^{\,2} sui gradi alti. Il criterio diventa allora:
si alza il grado finché |\widehat c_k|>2\widehat\sigma; ci si ferma quando due o tre coefficienti consecutivi scendono sotto la soglia.
Due precisazioni, entrambe necessarie.
- Perché consecutivi. Un coefficiente può essere nullo per ragioni di simmetria: se f è pari, tutti i coefficienti dispari sono nulli, e fermarsi al primo sotto soglia troncherebbe il fit troppo presto.
- Perché non il massimo. Con 25 coefficienti nel plateau, per puro caso ci si aspetta che circa uno superi 2\sigma. Non è segnale: è statistica. Si guarda dove lo spettro smette di decrescere, non l’ultimo valore che sporge.
Il criterio è una regola pratica, non un teorema. Resta valido il controllo definitivo, cioè la validazione incrociata: si toglie una parte dei dati, si calcola il fit sul resto e si misura l’errore sui dati esclusi, che — a differenza del residuo — non è monotono nel grado e ha un minimo vicino a k^\star.
L’esperimento
Generiamo m=120 dati da un trend liscio con rumore di deviazione standard \sigma=0{,}15 e guardiamo lo spettro.
set.seed(42)
m     <- 120
xr    <- seq(-1, 1, length.out = m)
trend <- function(t) exp(0.6*t) * sin(pi*t) + 0.3*t
sigma <- 0.15
yr    <- trend(xr) + rnorm(m, sd = sigma)

nmax <- 24
Br   <- base_ortogonale(xr, nmax)
chat <- as.vector(crossprod(Br$Q, yr)) / sqrt(Br$h)   # coefficienti ortonormali
rss  <- sum(yr^2) - cumsum(chat^2)                    # residuo grado per grado
shat <- sqrt(mean(chat[9:(nmax + 1)]^2))              # sigma stimato dal plateau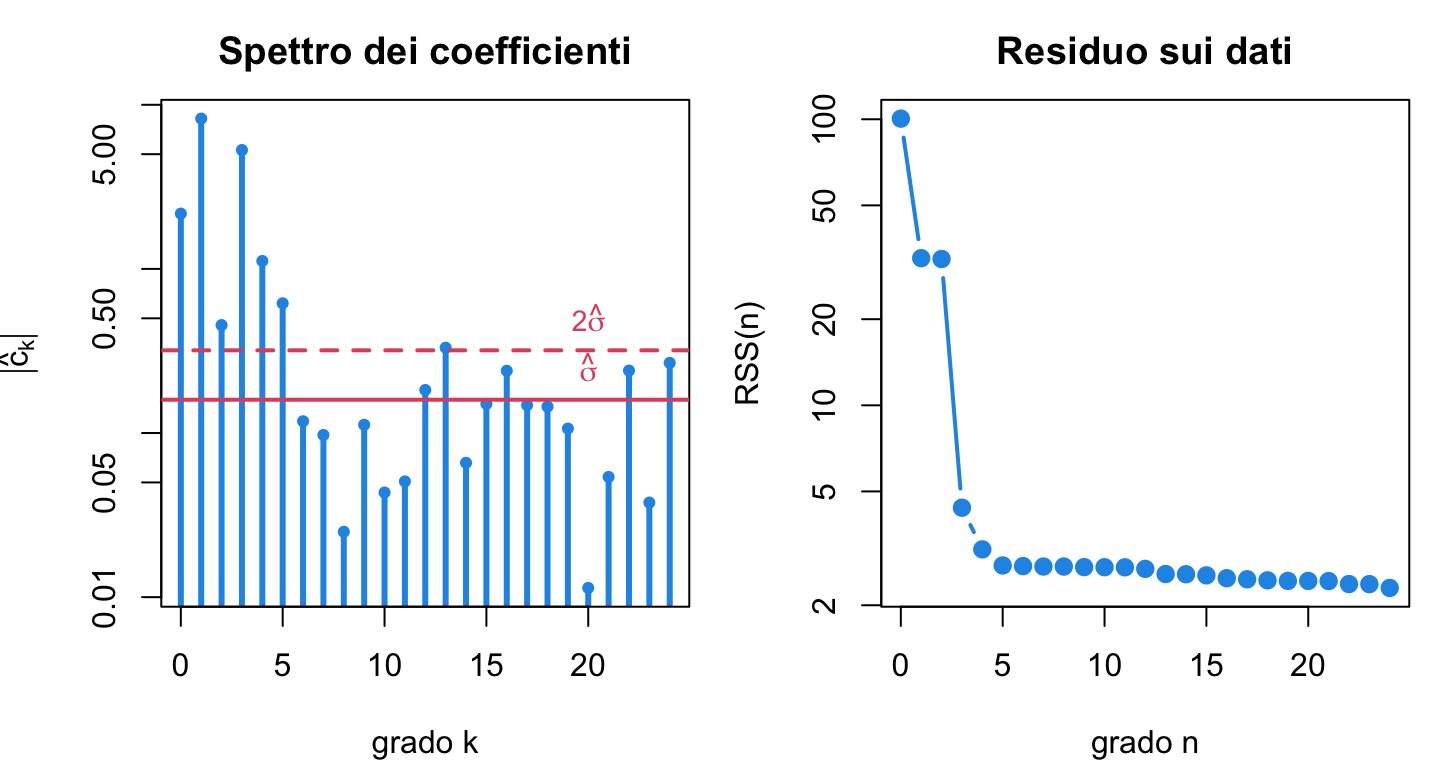
Lo spettro parla da solo: i coefficienti di grado 0–5 valgono 2{,}2, 8{,}2, 0{,}45, 5{,}3, 1{,}1, 0{,}62, tutti ben sopra la soglia 2\widehat\sigma\simeq0{,}32; dal grado 6 in poi non si scende più sotto e non si risale sopra in modo sistematico. Il valore stimato \widehat\sigma=0{,}16 è vicino al \sigma=0{,}15 usato per generare i dati, che però in un caso reale non si conosce.
Il pannello di destra mostra perché il residuo non serve: scende in modo monotono e non ha ginocchi riconoscibili dopo il grado 5.
La tabella seguente chiude il discorso confrontando, grado per grado, il residuo sui dati con l’errore rispetto al trend vero — che nella realtà non si può misurare, ma qui sì, perché il trend lo abbiamo scelto noi.
valuta_fino <- function(t, n) {
  d <- as.vector(crossprod(Br$Q[, 1:(n+1), drop = FALSE], yr)) / Br$h[1:(n+1)]
  valuta(t, list(d = d, beta = Br$beta, gamma = Br$gamma))
}
tg <- seq(-1, 1, length.out = 801)
gr <- c(1, 3, 5, 6, 8, 12, 16, 24)
knitr::kable(data.frame(
  n              = gr,
  c_hat_n        = abs(chat[gr + 1]),
  sopra_soglia   = ifelse(abs(chat[gr + 1]) > 2*shat, "si", "no"),
  RSS_dati       = rss[gr + 1],
  errore_vs_trend = sapply(gr, function(n) max(abs(valuta_fino(tg, n) - trend(tg))))),
digits = 4)| n | c_hat_n | sopra_soglia | RSS_dati | errore_vs_trend |
|---|---|---|---|---|
| 1 | 8.2361 | si | 32.6847 | 1.1897 |
| 3 | 5.3003 | si | 4.3852 | 0.5151 |
| 5 | 0.6172 | si | 2.7552 | 0.0833 |
| 6 | 0.1180 | no | 2.7413 | 0.1011 |
| 8 | 0.0250 | no | 2.7312 | 0.0877 |
| 12 | 0.1829 | no | 2.6807 | 0.1046 |
| 16 | 0.2395 | no | 2.4869 | 0.1697 |
| 24 | 0.2675 | no | 2.2990 | 0.2117 |
Il minimo dell’errore rispetto al trend cade al grado 5, esattamente dove il criterio dello spettro dice di fermarsi. Dal grado 12 in poi l’errore raddoppia mentre il residuo continua tranquillamente a scendere: il fit sta imparando il rumore.
plot(xr, yr, pch = 19, cex = 0.55, col = "grey45", xlab = "x", ylab = "y",
     main = "Grado scelto dallo spettro contro grado eccessivo")
lines(tg, trend(tg), lwd = 3, col = 1, lty = 2)
lines(tg, valuta_fino(tg, 5),  lwd = 2.5, col = 4)
lines(tg, valuta_fino(tg, 24), lwd = 2,   col = 2)
legend("bottom", c("dati", "trend vero", "grado 5", "grado 24"),
       pch = c(19, NA, NA, NA), lty = c(NA, 2, 1, 1),
       lwd = c(NA, 3, 2.5, 2), col = c("grey45", 1, 4, 2),
       bty = "n", cex = 0.9, ncol = 2)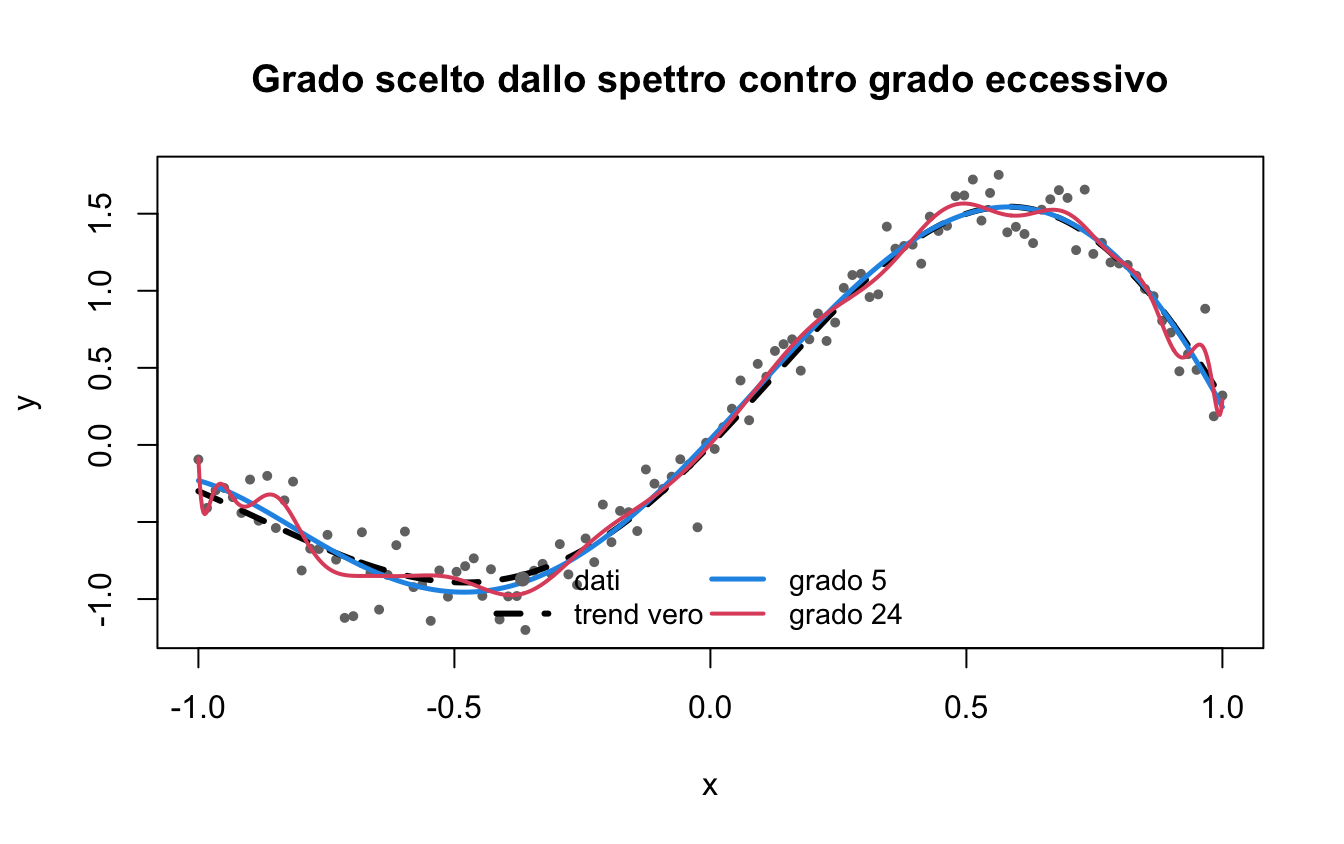
Risposta alla seconda domanda. Il plateau esiste, ha una causa precisa — il rumore si distribuisce uniformemente sullo spettro con ampiezza \sigma, il segnale no — e si legge nei coefficienti, non nel residuo. È uno dei motivi per cui la base ortonormale sui dati è preferibile a Legendre: la 17.23, da cui tutto discende, vale esattamente solo se i \phi_k sono ortonormali rispetto al prodotto scalare discreto. Con Legendre su nodi qualunque i coefficienti stimati sono leggermente correlati e lo spettro è un po’ più confuso, pur restando leggibile.
17.8 Terza domanda: il fitting incrementale
Mettiamo insieme i pezzi. La ricorrenza 17.11 produce i q_k uno alla volta, ciascuno da due predecessori; i coefficienti sono indipendenti fra loro (17.9) e non vanno ricalcolati quando se ne aggiunge uno nuovo; il residuo si aggiorna per sottrazione (17.22) e lo spettro dice quando fermarsi (Sezione 17.7). Ne esce un algoritmo che costruisce il fit per gradi crescenti e si arresta da solo.
L’algoritmo
La Figura 17.8 lo riassume. Rispetto alla Figura 17.1 cambiano tre cose: i coefficienti sono normalizzati (\widehat c_k anziché d_k, cioè divisione per \sqrt{h_k} anziché per h_k), il residuo viene aggiornato per sottrazione a ogni grado, e un test di arresto interrompe il ciclo appena lo spettro entra nel plateau.
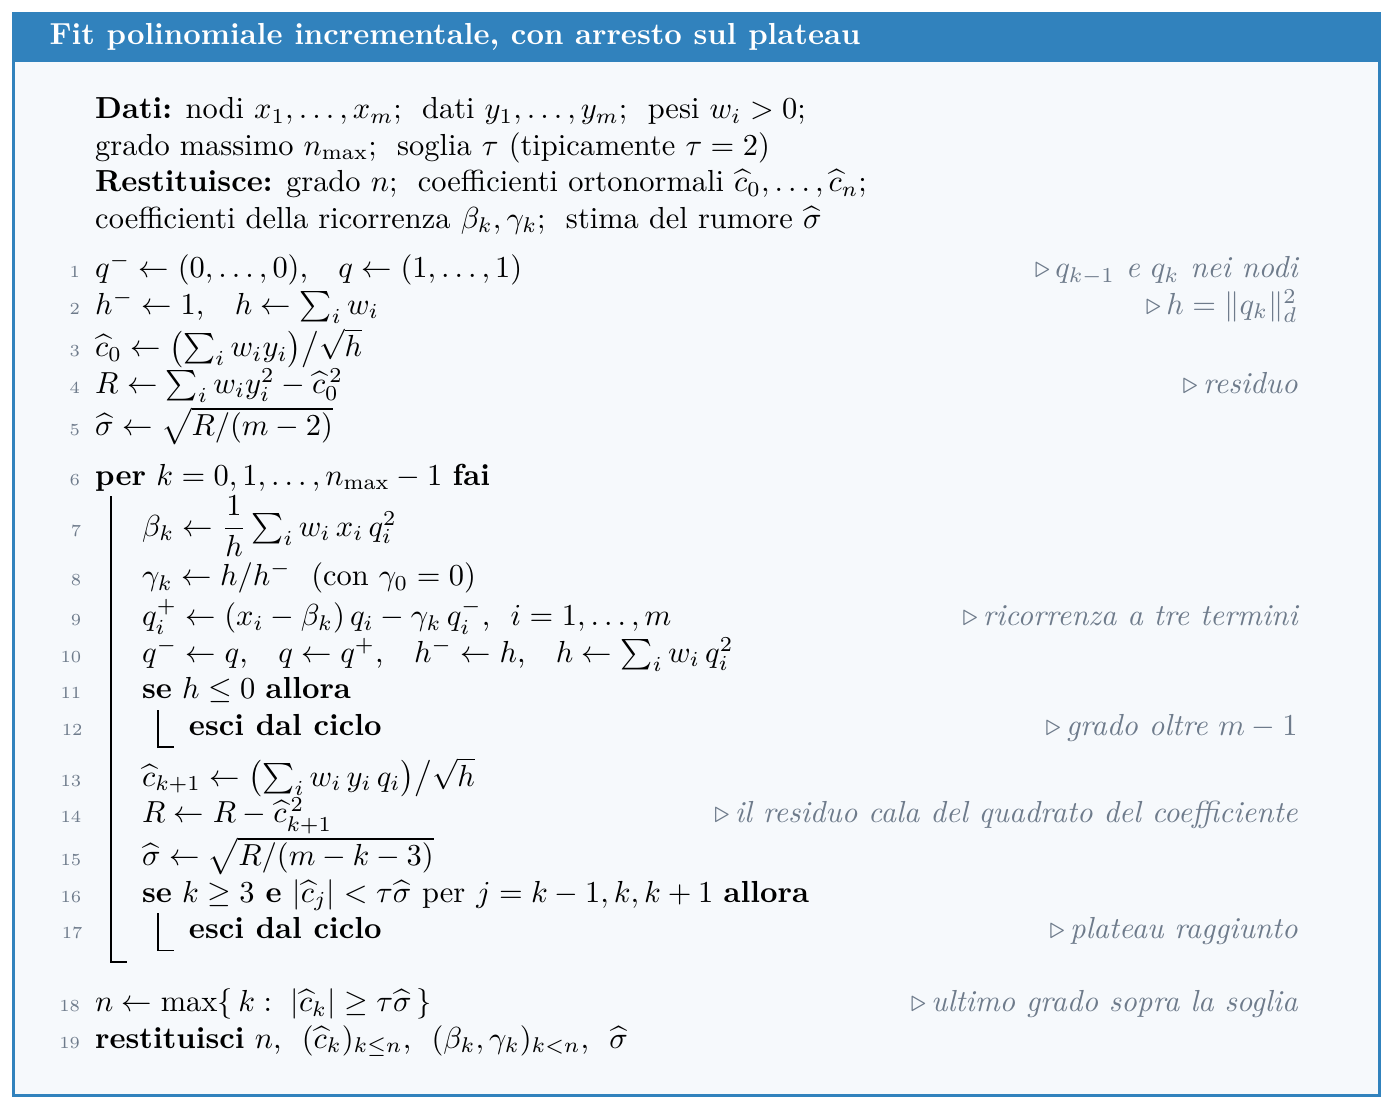
La riga che fa il lavoro concettuale è l’aggiornamento R\leftarrow R-\widehat c_{k+1}^{\,2}: è la 17.22, cioè l’identità di Pitagora applicata un grado alla volta. Da essa discende anche la stima del rumore, perché per 17.24 il residuo nel plateau vale circa (m-k-2)\,\sigma^2.
Tre proprietà rendono l’algoritmo adatto anche a dataset molto grandi.
- Costo. Ogni grado richiede un numero fisso di passate sui dati, quindi O(m) operazioni per grado e O(mn) in totale — contro gli O(mn^2) di una QR rifatta da capo per ogni grado.
- Memoria. Servono solo due vettori di lunghezza m (q_k e q_{k-1} nei nodi) più gli scalari. Non si memorizza nessuna matrice m\times(n+1).
- Niente lavoro buttato. Fermandosi al grado n si è speso esattamente quanto serviva per il grado n: non c’è un n_{\max} da indovinare in anticipo e nessun calcolo viene scartato.
L’implementazione in R
fit_incrementale <- function(x, y, nmax = 30, tau = 2,
                             w = rep(1, length(x))) {
  m  <- length(x)
  qp <- rep(0, m); q <- rep(1, m)          # q_{k-1} e q_k valutati nei nodi
  hp <- 1;         h <- sum(w)             # norme al quadrato
  ch <- hk <- rss <- sig <- beta <- gamma <- numeric(nmax + 1)

  hk[1]  <- h
  ch[1]  <- sum(w * y) / sqrt(h)           # primo coefficiente
  rss[1] <- sum(w * y^2) - ch[1]^2
  sig[1] <- sqrt(max(rss[1], 0) / max(m - 2, 1))

  K <- 0
  for (k in seq_len(nmax) - 1) {
    beta[k + 1]  <- sum(w * x * q^2) / h
    gamma[k + 1] <- if (k == 0) 0 else h / hp
    qn <- (x - beta[k + 1]) * q - gamma[k + 1] * qp   # nuovo grado
    qp <- q; q <- qn; hp <- h; h <- sum(w * q^2)
    if (h <= 0) break                      # grado oltre il consentito
    hk[k + 2]  <- h
    ch[k + 2]  <- sum(w * y * q) / sqrt(h)
    rss[k + 2] <- rss[k + 1] - ch[k + 2]^2            # il residuo cala
    sig[k + 2] <- sqrt(max(rss[k + 2], 0) / max(m - k - 3, 1))
    K <- k + 1
    if (K >= 3 && all(abs(ch[(K - 1):(K + 1)]) < tau * sig[K + 1])) break
  }

  i     <- 0:K
  sopra <- which(abs(ch[i + 1]) >= tau * sig[K + 1])
  g     <- if (length(sopra)) max(sopra) - 1 else 0
  list(storia = data.frame(k = i, c_hat = ch[i + 1],
                           RSS = rss[i + 1], sigma = sig[i + 1]),
       sigma  = sig[K + 1],
       grado  = g,
       d      = (ch[i + 1] / sqrt(hk[i + 1]))[1:(g + 1)],  # coeff. monici
       beta   = beta, gamma = gamma)
}
Il campo storia registra, grado per grado, coefficiente, residuo e stima del rumore: è la tabella da guardare per capire che cosa ha fatto l’algoritmo.
L’algoritmo sui dati rumorosi
inc <- fit_incrementale(xr, yr, nmax = 24, tau = 2)
st  <- inc$storia
st$sopra_soglia <- ifelse(abs(st$c_hat) >= 2 * inc$sigma, "si", "no")
knitr::kable(st, digits = 4, row.names = FALSE)| k | c_hat | RSS | sigma | sopra_soglia |
|---|---|---|---|---|
| 0 | 2.1722 | 100.5181 | 0.9230 | si |
| 1 | 8.2361 | 32.6847 | 0.5285 | si |
| 2 | 0.4546 | 32.4780 | 0.5291 | si |
| 3 | -5.3003 | 4.3852 | 0.1953 | si |
| 4 | -1.1176 | 3.1362 | 0.1659 | si |
| 5 | 0.6172 | 2.7552 | 0.1561 | si |
| 6 | 0.1180 | 2.7413 | 0.1564 | no |
| 7 | 0.0972 | 2.7319 | 0.1569 | no |
| 8 | 0.0250 | 2.7312 | 0.1576 | no |
L’algoritmo si ferma dopo aver calcolato pochi gradi oltre quello utile, e restituisce grado = 5, con una stima del rumore \widehat\sigma= 0.1576 contro il valore vero 0{,}15. Non ha mai costruito una matrice, non ha mai risolto un sistema, e il costo è stato di una manciata di passate sui 120 dati.
NotaIl legame con QR
Vale la pena vedere la stessa cosa con gli occhi dell’algebra lineare. Costruire la base ortonormale \phi_0,\ldots,\phi_n sui nodi è calcolare il fattore \bm{Q} della fattorizzazione \bm{A}=\bm{Q}\bm{R} della matrice di Vandermonde: le colonne di \bm{Q} sono proprio i \phi_k(x_i), e \bm{R} contiene i coefficienti che esprimono i monomi nella base ortogonale.
La differenza è che la QR classica ortogonalizza le colonne numericamente, con riflessioni di Householder, costa O(mn^2) e va rifatta da capo se cambia il grado; la ricorrenza a tre termini le ortogonalizza analiticamente, costa O(mn) ed è incrementale. Il prezzo è che la ricorrenza funziona solo per il caso polinomiale: la QR funziona per qualunque matrice.
Risposta alla terza domanda. Sì, ed è il modo naturale di procedere: la ricorrenza aggiunge un grado alla volta, il coefficiente nuovo non disturba i vecchi, il residuo si aggiorna per sottrazione e lo spettro dice quando smettere. Il lavoro complessivo è lo stesso che servirebbe per calcolare il solo fit del grado finale.
17.9 Il problema continuo
La proiezione in norma pesata
Per approssimare f in L^2_w(-1,1), con base ortogonale \phi_k, la minimizzazione \min_{c_0,\ldots,c_n}\int_{-1}^1 \left|f(x)-\sum_{k=0}^n c_k\phi_k(x)\right|^2w(x)\,\mathrm dx si disaccoppia: c_k=\langle f,\phi_k\rangle_w nella base ortonormale. Con base ortogonale non normalizzata, c_k=\langle f,p_k\rangle_w/\|p_k\|_w^2. La proiezione è il minimizzatore unico, come dimostrato in Sezione A.4; la Figura 17.9 ne riassume il contenuto geometrico.
Esempio: proiezione di e^x e dipendenza dal peso
Approssimiamo e^x con Legendre ortonormali. I coefficienti integrali sono stimati con una regola del punto medio fine; il grafico mostra la funzione, le proiezioni per tre gradi e l’errore puntuale. Non si tratta di un bound teorico: riportiamo anche l’errore massimo misurato su una griglia indipendente.
m<-20000; xq<- -1+(seq_len(m)-0.5)*2/m; wq<-rep(2/m,m)
xx<-seq(-1,1,length.out=1001); truth<-exp(xx)
degrees<-c(2,4,8); cols<-c(2,4,3)
plot(xx,truth,type="l",lwd=3,col=1,xlab="x",ylab="f(x)",main="Proiezione ortogonale di exp(x)")
errs<-numeric(length(degrees))
for(j in seq_along(degrees)){
  d<-degrees[j]; Pq<-sapply(0:d,legendre,x=xq)
  phiQ<-sweep(Pq,2,sqrt((2*(0:d)+1)/2),`*`)
  coef<-colSums(sweep(phiQ,1,wq*exp(xq),`*`))
  Px<-sapply(0:d,legendre,x=xx)
  phiX<-sweep(Px,2,sqrt((2*(0:d)+1)/2),`*`)
  approx<-drop(phiX%*%coef); lines(xx,approx,col=cols[j],lwd=2)
  errs[j]<-max(abs(truth-approx))
}
legend("topleft",c("exp(x)",paste0("grado ",degrees)),col=c(1,cols),lwd=c(3,2,2,2),bty="n")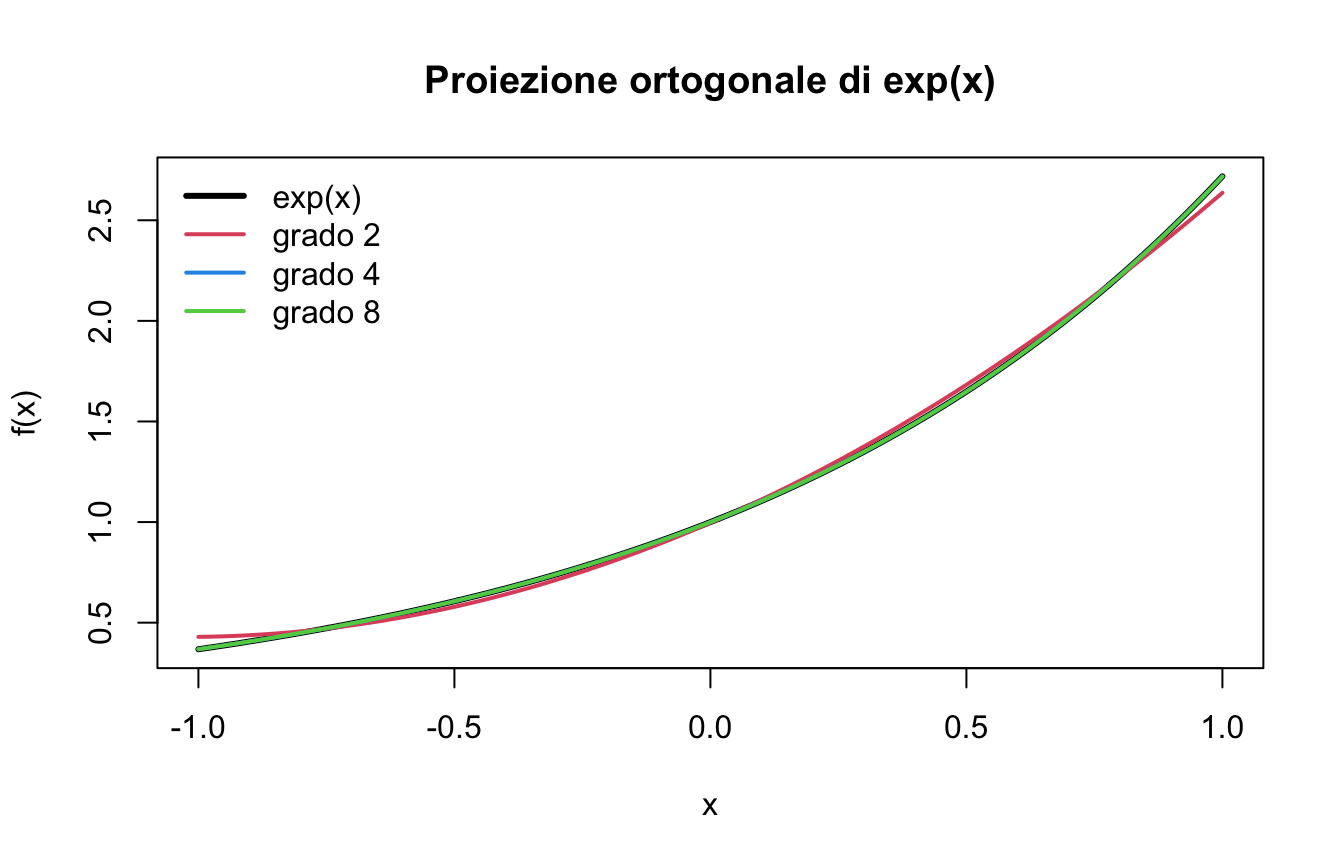
| grado | errore_massimo_griglia |
|---|---|
| 2 | 0.0816280 |
| 4 | 0.0012073 |
| 8 | 0.0000010 |
Per un peso diverso, cambiano sia i coefficienti sia la funzione obiettivo. L’errore massimo non coincide con l’errore L^2_w; il primo è utile per visualizzare, il secondo è quello minimizzato dalla proiezione.
Esempio: cambiare il peso cambia la proiezione
Il prossimo esempio risolve il problema continuo pesato con quadratura del punto medio. Usiamo la stessa base polinomiale, ma due prodotti scalari: uniforme e Jacobi con \alpha=0.6, \beta=0.2. La minimizzazione discreta approssima l’integrale; aumentando m si raffina la quadratura.
m<-10000; xq<- -1+(seq_len(m)-0.5)*2/m; dx<-2/m
degree<-4; A<-sapply(0:degree,legendre,x=xq); y<-exp(xq)
w_uniform<-rep(dx,m)
w_jacobi<-dx*(1-xq)^0.6*(1+xq)^0.2
fit_weighted<-function(w){Aw<-sweep(A,1,sqrt(w),`*`)
  yw<-sqrt(w)*y; cc<-qr.solve(Aw,yw,tol=1e-12); list(c=cc,rss=sum(w*(A%*%cc-y)^2))}
u<-fit_weighted(w_uniform); j<-fit_weighted(w_jacobi)
xx<-seq(-1,1,length.out=1001); B<-sapply(0:degree,legendre,x=xx)
pu<-drop(B%*%u$c); pj<-drop(B%*%j$c)
plot(xx,exp(xx),type="l",lwd=3,col=1,xlab="x",ylab="funzione",
     main="Proiezione pesata: stesso grado, pesi diversi")
lines(xx,pu,col=4,lwd=2);lines(xx,pj,col=2,lwd=2,lty=2)
legend("topleft",c("exp(x)","peso uniforme","peso Jacobi (0.6,0.2)"),
       col=c(1,4,2),lty=c(1,1,2),lwd=c(3,2,2),bty="n")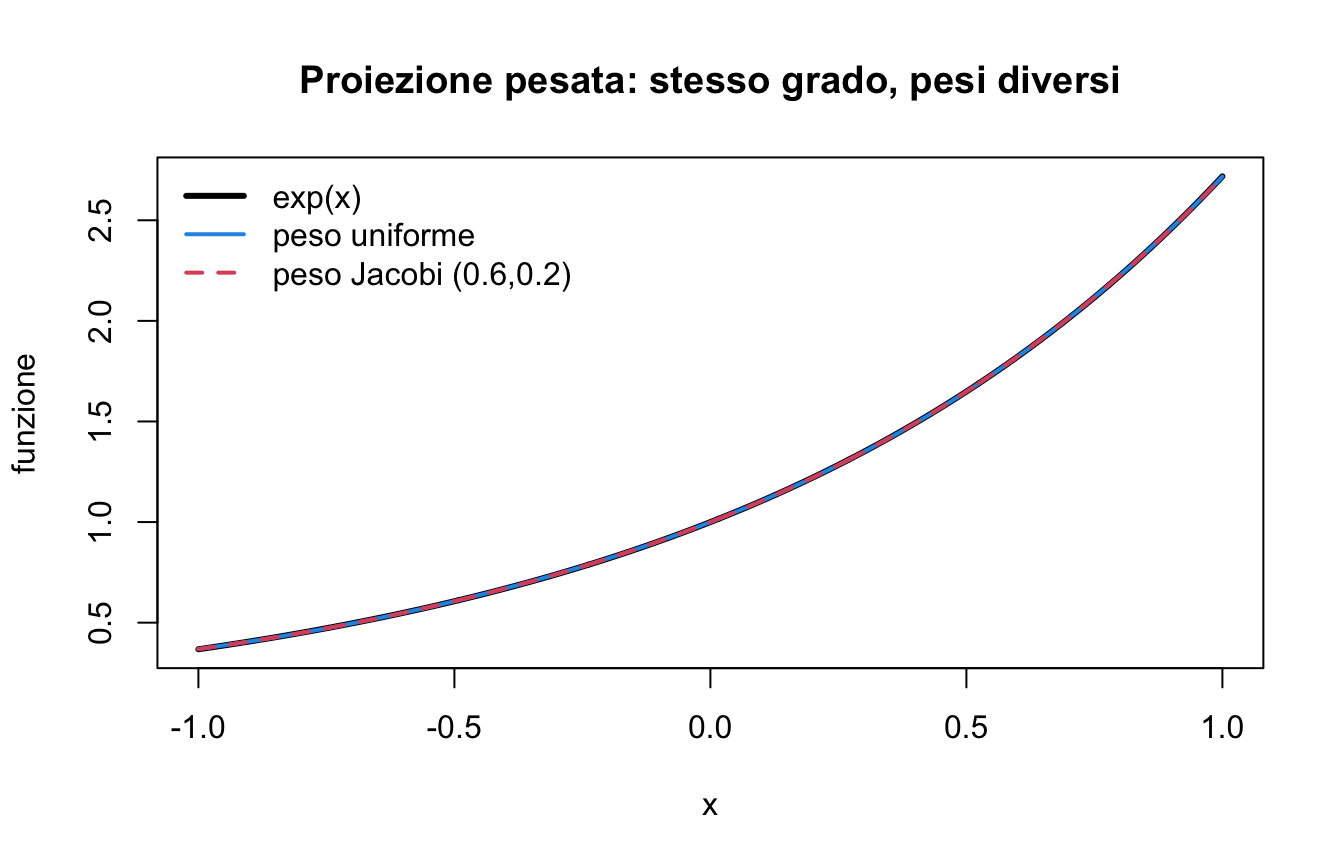
| peso | errore_L2_pesato_discreto |
|---|---|
| uniforme | 2e-07 |
| Jacobi alpha=0.6, beta=0.2 | 1e-07 |
Si tratta di errori quadratici rispetto ai rispettivi pesi, quindi i valori delle due righe non misurano la stessa quantità. Per un confronto equo fra approssimazioni, si possono valutare entrambe in una terza norma comune.
In sintesi
Le tre domande poste all’inizio hanno ora una risposta.
La base. Cambiare base non cambia lo spazio approssimante, non cambia il polinomio ottimo e non cambia il residuo: cambia il condizionamento della matrice di progetto, e quindi l’accuratezza con cui quel polinomio viene calcolato. Il guadagno è grande — sei ordini di grandezza a grado 20 — ma è tutto lì. In particolare una base ortogonale non filtra il rumore e non riduce il sovradattamento.
- I monomi sono una base pessima: \kappa_2 cresce esponenzialmente nel grado (14.5), e nessuna scelta del peso lo evita.
- I polinomi di Legendre sono una base fissa ed eccellente, purché i dati siano riscalati su [-1,1] con 17.20. Danno una \bm{A}^TA quasi diagonale, perché la somma sui nodi è una quadratura dell’integrale rispetto al quale sono ortogonali.
- La base \phi_k costruita sui dati con la ricorrenza 17.11 dà ortogonalità esatta, \bm{A}^TA diagonale e \kappa_2=1 — a patto di normalizzare, perché i q_k monici hanno norme di ordini di grandezza diversi.
Il grado. Con base ortonormale ogni coefficiente stimato è il coefficiente vero più un errore di deviazione standard \sigma, uguale per tutti i gradi e scorrelato fra gradi diversi (17.23). Il rumore si spalma quindi uniformemente sullo spettro, il segnale no: da un certo grado in poi |\widehat c_k| smette di decrescere e si appiattisce su \sigma. È il plateau, e dà il criterio di arresto: fermarsi quando due o tre coefficienti consecutivi scendono sotto 2\widehat\sigma. Il residuo, che decresce sempre, non fornisce invece nessuna indicazione.
L’incrementalità. La ricorrenza produce un grado alla volta, i coefficienti sono indipendenti, il residuo si aggiorna per sottrazione (17.22) e il criterio di arresto si valuta strada facendo. Il costo è O(m) per grado e la memoria O(m) in tutto, contro O(mn^2) e O(mn) di una QR rifatta per ogni grado. La ricorrenza a tre termini è, in sostanza, la fattorizzazione QR della Vandermonde eseguita analiticamente invece che numericamente.
Il peso. Nel problema continuo il peso decide quale errore viene minimizzato: proiezioni rispetto a pesi diversi sono approssimazioni diverse e non vanno confrontate con il residuo di una sola delle due norme. Nel problema discreto i pesi w_i=1/\sigma_i^2 sono il modo corretto di combinare misure di precisione diversa.
Un parente stretto. La variante vincolata dello stesso problema — minimizzare la norma fra i polinomi che valgono 1 in un punto assegnato — ha soluzione in forma chiusa tramite il polinomio del nucleo (Teorema 16.3), e tornerà nei pesi della quadratura gaussiana.
Consiglio
Gli integrali \langle f,\phi_k\rangle_w del problema continuo sono qui approssimati con una regola del punto medio molto fine, per non anticipare risultati non ancora dimostrati. In Capitolo 18 si vedrà che poche decine di nodi di Gauss bastano a ottenere gli stessi coefficienti a precisione macchina.
17.10 Esercizi
- Generare m=200 dati da f(x)=\cos(4x) su [-1,1] con rumore \sigma=0{,}05 e applicare
fit_incrementale. Verificare che il grado scelto cresce al diminuire di \sigma e spiegare perché: quali coefficienti emergono sopra il livello del rumore? - Ripetere l’esperimento della Tabella 17.10 con nodi non equispaziati, per esempio x_i=\cos\big((2i-1)\pi/(2m)\big) (nodi di Chebyshev). Che cosa succede agli elementi fuori diagonale della base di Legendre, e perché?
- Verificare numericamente 17.23: fissati nodi e grado, generare mille realizzazioni di solo rumore (y_i=\varepsilon_i) e controllare che la deviazione standard campionaria di ciascun \widehat c_k valga \sigma e che le correlazioni fra coefficienti diversi siano trascurabili.
- Implementare la validazione incrociata leave-one-out sul fit polinomiale e confrontare il grado da essa scelto con quello del criterio dello spettro, sugli stessi dati della
- Modificare
fit_incrementaleper accettare pesi w_i=1/\sigma_i^2 e verificare, su dati con incertezze diverse, che il plateau si forma al livello 1 anziché \sigma (gli scarti sono ora misurati in unità di deviazione standard). - Costruire un fit pesato discreto con w_i=1+x_i e risolverlo anche con
qr.solvesu \min\|W^{1/2}(Ac-y)\|_2; confrontare i coefficienti ottenuti per le due strade. - Usare la SVD della matrice di progetto nella base monomiale e scartare i valori singolari minori di 10^{-10}\sigma_{\max}; spiegare il legame fra questo troncamento e il criterio dello spettro.